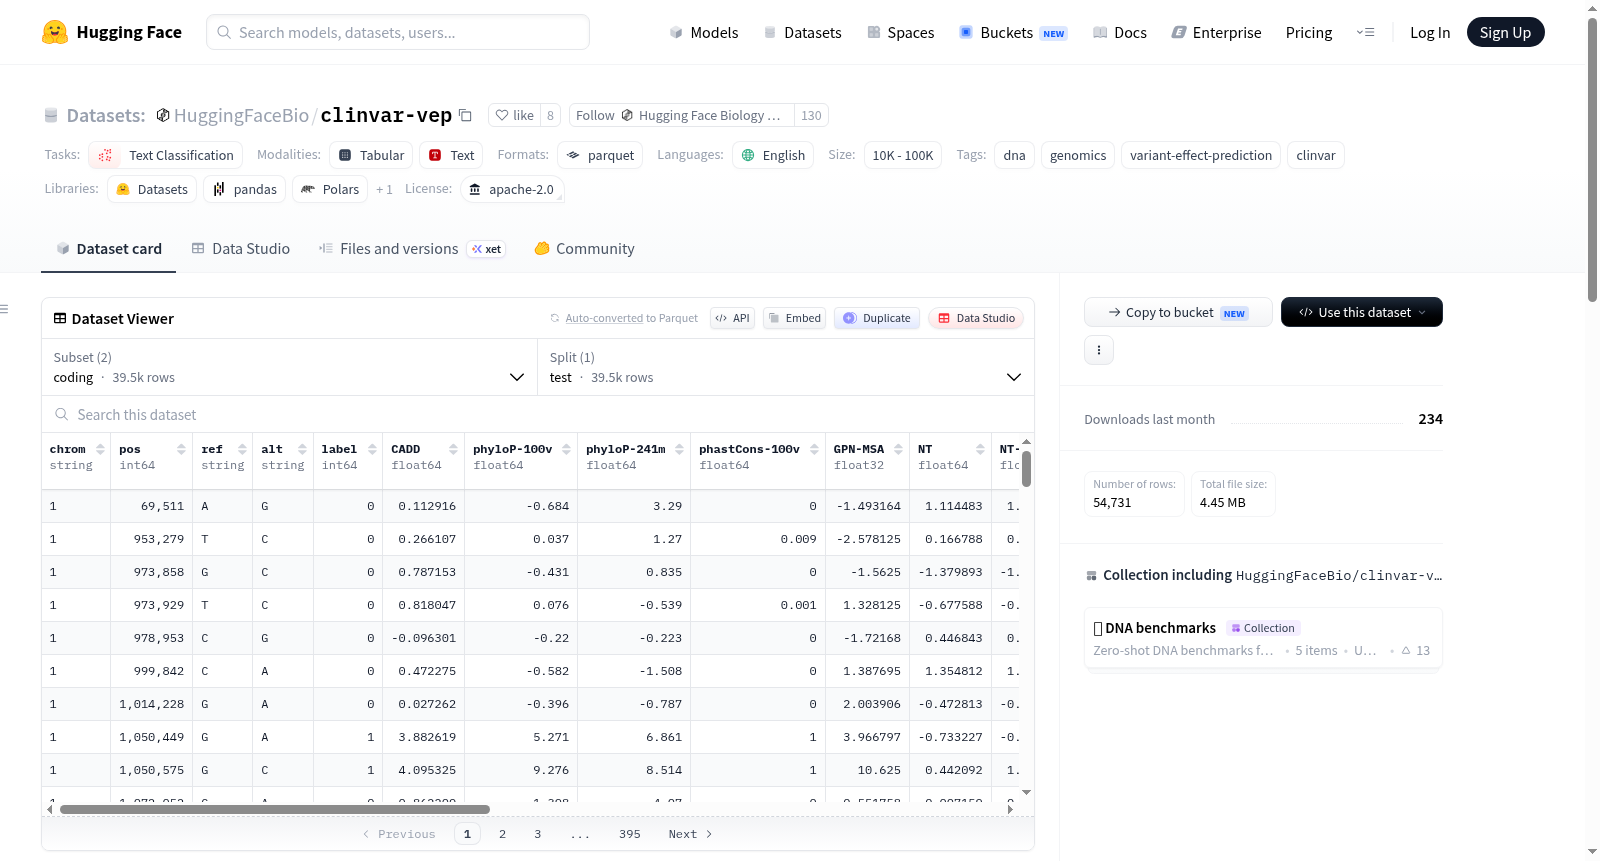
HuggingFaceBio/clinvar-vep
收藏资源简介:
ClinVar VEP是一个用于评估DNA语言模型在临床变异致病性上的基准数据集,包含两个子集:coding(39,473个变异)和non-coding(15,258个变异)。每个子集都是一个平衡的二元分类任务,标签1表示致病/可能致病,标签0表示良性/可能良性。coding子集覆盖外显子蛋白编码区域,non-coding子集覆盖内含子及5′/3′非翻译区域(UTR)。数据集基于ClinVar变异数据构建,旨在为基因组学研究提供标准化评估工具。
A ClinVar variant-effect-prediction (VEP) benchmark, for evaluating DNA language models on clinical variant pathogenicity, with two subsets: coding (39,473 variants) and non-coding (15,258 variants). Each split is a balanced binary classification task: label = 1 for pathogenic / likely pathogenic and label = 0 for benign / likely benign. The coding subset covers exonic protein-coding regions, while the non-coding subset covers intronic and 5′/3′ UTR regions. The dataset is constructed from ClinVar variant data and serves as a standardized evaluation tool for genomics research.