
kazi420/ECG_LM_Final_Dataset_V2
收藏官方服务:
资源简介:
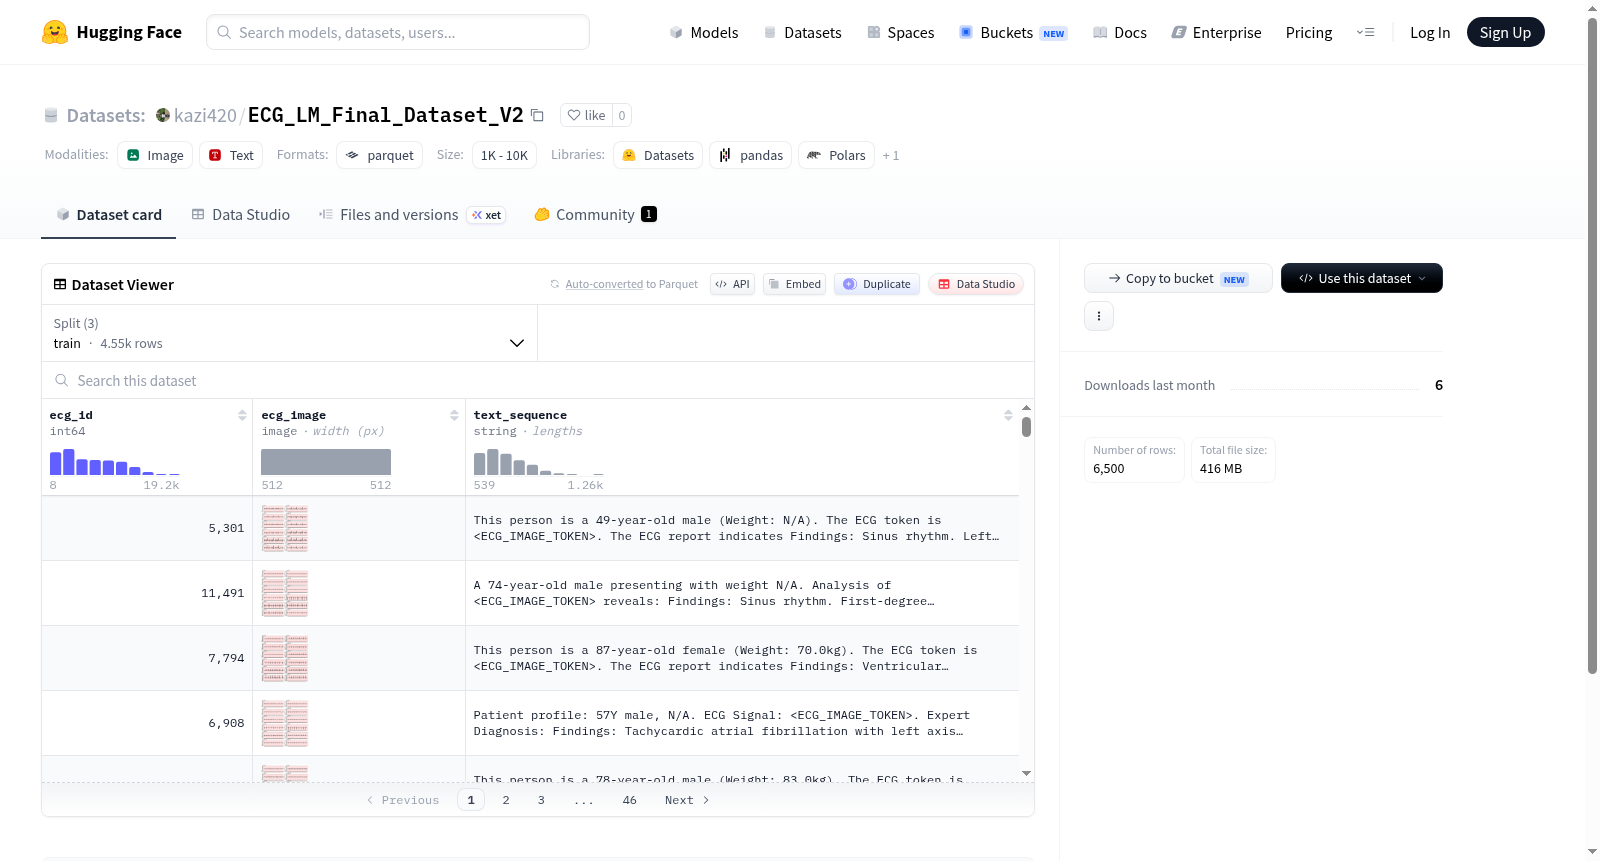
该数据集包含心电图(ECG)图像和对应的文本序列,用于医疗分析或机器学习模型训练。数据集分为训练集(4550个样本)、验证集(650个样本)和测试集(1300个样本),总计6500个样本,特征包括心电图ID、图像数据和文本序列。
This dataset contains electrocardiogram (ECG) images and corresponding text sequences for medical analysis or machine learning model training. It is divided into training set (4550 examples), validation set (650 examples), and test set (1300 examples), totaling 6500 examples, with features including ECG ID, image data, and text sequences.
提供机构:
kazi420搜集汇总
数据集介绍
构建方式
ECG_LM_Final_Dataset_V2数据集专为心电图(ECG)与自然语言处理跨模态研究而构建,其核心设计围绕医学影像与文本序列的配对对齐。该数据集包含4550条训练样本、650条验证样本及1300条测试样本,每条样本由心电图图像(ecg_image)、对应的文本描述(text_sequence)及其唯一标识符(ecg_id)三元组构成。数据构建过程中,首先采集标准化心电图记录,通过专业医师标注描述性文本,确保图像与文本在心脏电生理事件上精准对应,从而形成结构化的多模态语料库。存储格式上,图像以主流高保真格式保存,文本采用字符串类型,整体数据集大小约为420 MB,兼顾了数据质量与存储效率。
使用方法
使用ECG_LM_Final_Dataset_V2时,用户可通过HuggingFace的datasets库便捷加载,指定配置名为'default',并利用数据文件路径'data/train-*'、'data/validation-*'及'data/test-*'分别获取各划分数据。每条样本提供ecg_image(PIL图像对象)与text_sequence(字符串)字段,便于直接输入多模态模型进行训练或评估。典型应用场景包括:将心电图图像作为视觉编码器输入,文本序列作为语言解码器的监督信号,构建端到端的心电图描述模型;或利用对比学习框架对齐图像与文本嵌入空间,实现基于图像的心电图文本检索。建议根据任务需求对文本进行领域分词预处理,如图像则按模型预设尺寸调整,以适配Transformer类架构。
背景与挑战
背景概述
心电图(ECG)作为临床上最常用的心脏功能检查手段,其自动解读对于提高诊断效率和减轻医护人员负担至关重要。ECG_LM_Final_Dataset_V2数据集由研究人员精心构建,旨在为基于多模态学习的心电图自动分析领域提供基础数据支撑。该数据集创建于近年,其核心研究问题在于如何将ECG图像信号与文本序列(如诊断报告)进行有效对齐与联合建模,以推动大语言模型在心电诊断任务中的应用。通过提供包含4550例训练样本、650例验证样本和1300例测试样本的标注数据,该研究为心电信号处理与自然语言处理的交叉融合提供了宝贵的基准资源,对智能医疗诊断领域产生了积极影响。
当前挑战
该数据集所解决的领域问题核心挑战在于ECG图像与对应文本序列之间的异构模态对齐与语义映射。传统心电图分析多依赖单一的波形信号,而缺少对临床文本知识的深度整合,导致模型难以生成符合医学规范的诊断描述。在构建过程中,主要挑战包括:确保ECG图像的高质量采集与标准化预处理,以消除设备差异带来的噪声干扰;准确地将冗长、专业的诊断文本与对应的ECG片段进行时序关联与语义匹配;以及应对医学数据固有的类不平衡问题,特别是罕见心律失常类型的样本量严重不足,这直接制约了模型在真实临床场景中的泛化能力与稳健性。
常用场景
经典使用场景
ECG_LM_Final_Dataset_V2数据集专为心电信号与文本描述的跨模态理解而设计,其经典使用场景聚焦于心电图图像与对应临床文本序列之间的联合建模。研究人员可利用该数据集训练深度学习模型,以自动生成心电图的诊断性文字描述,或将临床记录转化为可视化的心电图像特征,从而搭建起医学影像与自然语言处理之间的桥梁。这一场景在智能医疗辅助系统中尤为关键,能够为医生提供从信号到语义的直观解读,极大提升临床决策的效率与准确性。
解决学术问题
该数据集有效解决了心电数据标注稀缺且格式异构的学术难题,为无监督或弱监督学习框架提供了标准化基准。它助力研究界攻克心电图自动报告生成中的文本-图像对齐问题,推动了多模态医学信息融合的理论进展。通过提供大规模配对的信号与语言对,ECG_LM_Final_Dataset_V2使得开发可泛化的心电认知模型成为可能,显著降低了传统依赖专家手工标注的高昂成本,其影响在于加速了可解释性人工智能在心血管疾病诊断中的实证研究。
实际应用
在实际临床场景中,ECG_LM_Final_Dataset_V2赋能了便携式心电监测设备的智能化升级,使得实时心电数据能够被转化为通俗易懂的文本预警,例如在远程监护系统中自动生成异常节律的分析报告。此外,该数据集还支持医学教育工具的构建,通过图像与文字的双向检索,帮助医学生快速掌握心电图解读技能。在公共卫生领域,其应用可扩展到大规模人群筛查,实现从心电信号到结构化电子病历的全自动流水线,从而优化医疗资源分配。
数据集最近研究
最新研究方向
随着多模态学习在临床决策支持系统中的崛起,ECG_LM_Final_Dataset_V2数据集将心电图图像与文本序列对齐,为心电信号与自然语言描述的联合建模提供了坚实基础。当前前沿研究方向聚焦于利用视觉-语言预训练范式,通过大规模对比学习实现心电图像特征与临床文本语义的跨模态对齐,从而在少样本疾病诊断、临床报告自动生成等任务中取得突破。该数据集与近期心脏健康智能监测热潮紧密相连,其包含的丰富标注图像与文本对,不仅降低了模型对大量人工标注的依赖,更推动了可解释性心电AI的发展,有望在远程医疗和基层筛查中实现智能化、精准化的心电判读,对提升心血管疾病早期预警能力具有深远影响。
以上内容由遇见数据集搜集并总结生成


