softcatala/Europarl-catalan
收藏资源简介:
该数据集包含两个数据集对,对应Europarl语料库。英语和德语版本与加泰罗尼亚语翻译对齐,加泰罗尼亚语翻译是通过Apertium的基于规则的机器翻译系统从西班牙语-英语对齐的西班牙语版本获得的。加泰罗尼亚语-德语对齐是通过使用对齐查找器从德语-英语和加泰罗尼亚语-英语数据中通过枢轴语言对齐过程获得的。具体数据量:加泰罗尼亚语-英语有1,965,735个片段,加泰罗尼亚语-德语有1,734,644个片段。该数据集可用于训练神经机器翻译和统计机器翻译系统,并已用于Softcatalà机器翻译引擎的训练语料库。数据集支持加泰罗尼亚语、德语和英语,主要基于欧洲议会会议记录,覆盖正式、制度、政治和立法语言,但可能不适用于日常加泰罗尼亚语的广泛样本。加泰罗尼亚语侧是机器生成的,可能包含翻译错误或不自然的表达,对齐也可能存在噪音。
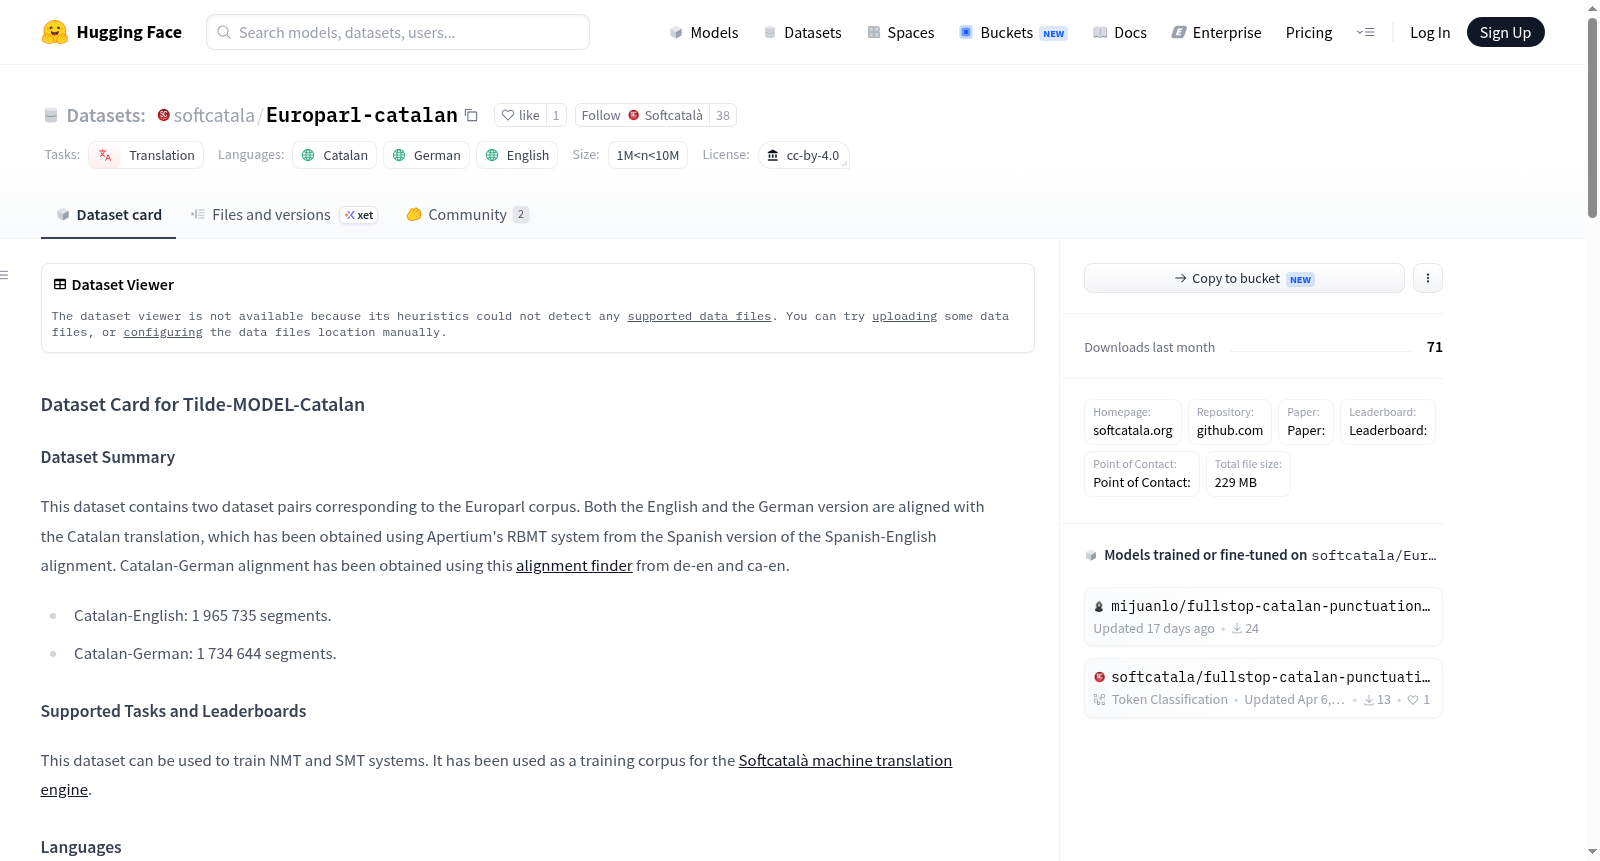
This dataset contains two dataset pairs corresponding to the Europarl corpus. Both the English and the German version are aligned with the Catalan translation, which has been obtained using Apertiums RBMT system from the Spanish version of the Spanish-English alignment. Catalan-German alignment has been obtained using an alignment finder from de-en and ca-en through a pivot-language alignment process. Specific data volumes: Catalan-English has 1,965,735 segments, and Catalan-German has 1,734,644 segments. The dataset can be used to train NMT and SMT systems and has been used as a training corpus for the Softcatalà machine translation engine. It supports Catalan, German, and English, primarily based on European Parliament proceedings, covering formal, institutional, political, and legislative language, but may not be suitable as a broad sample of everyday Catalan. The Catalan side is machine-generated and may contain translation errors or unnatural phrasing, and alignment may also contain noise.
数据集概述
数据集名称
- 名称: Tilde-MODEL-Catalan
- 别名: Catalan-English and Catalan-German aligned corpora to train NMT systems.
数据集描述
- 摘要: 该数据集包含两个数据集对,对应于Europarl语料库。英语和德语版本均与加泰罗尼亚语翻译对齐,其中加泰罗尼亚语-德语对齐是通过使用对齐查找器从de-en和ca-en获得的。
- 支持的任务: 用于训练NMT和SMT系统。
- 语言: 加泰罗尼亚语 (
ca), 德语 (de), 英语 (en)。
数据集结构
- 数据实例: 待补充。
- 数据字段: 原始文本。
- 数据分割: 每种语言一个文件。
数据集创建
- 源数据: 扩展自Europarl双语数据集。
- 许可证: CC BY 4.0。
数据集大小
- 大小类别: 1M<n<10M。
多语言性
- 多语言性: 翻译。
数据集创建者
- 注释创建者: 无注释。
- 语言创建者: 机器生成。
数据集使用考虑
- 社会影响: 待补充。
- 偏见讨论: 待补充。
- 其他已知限制: 待补充。
附加信息
- 数据集管理员: @softcatala, @jordimas, @davidcanovas。
- 贡献: 待补充。