
遇见数据集

corti/med-dictate

收藏
Hugging Face2026-06-10 更新2026-06-14 收录
官方服务:

资源简介:

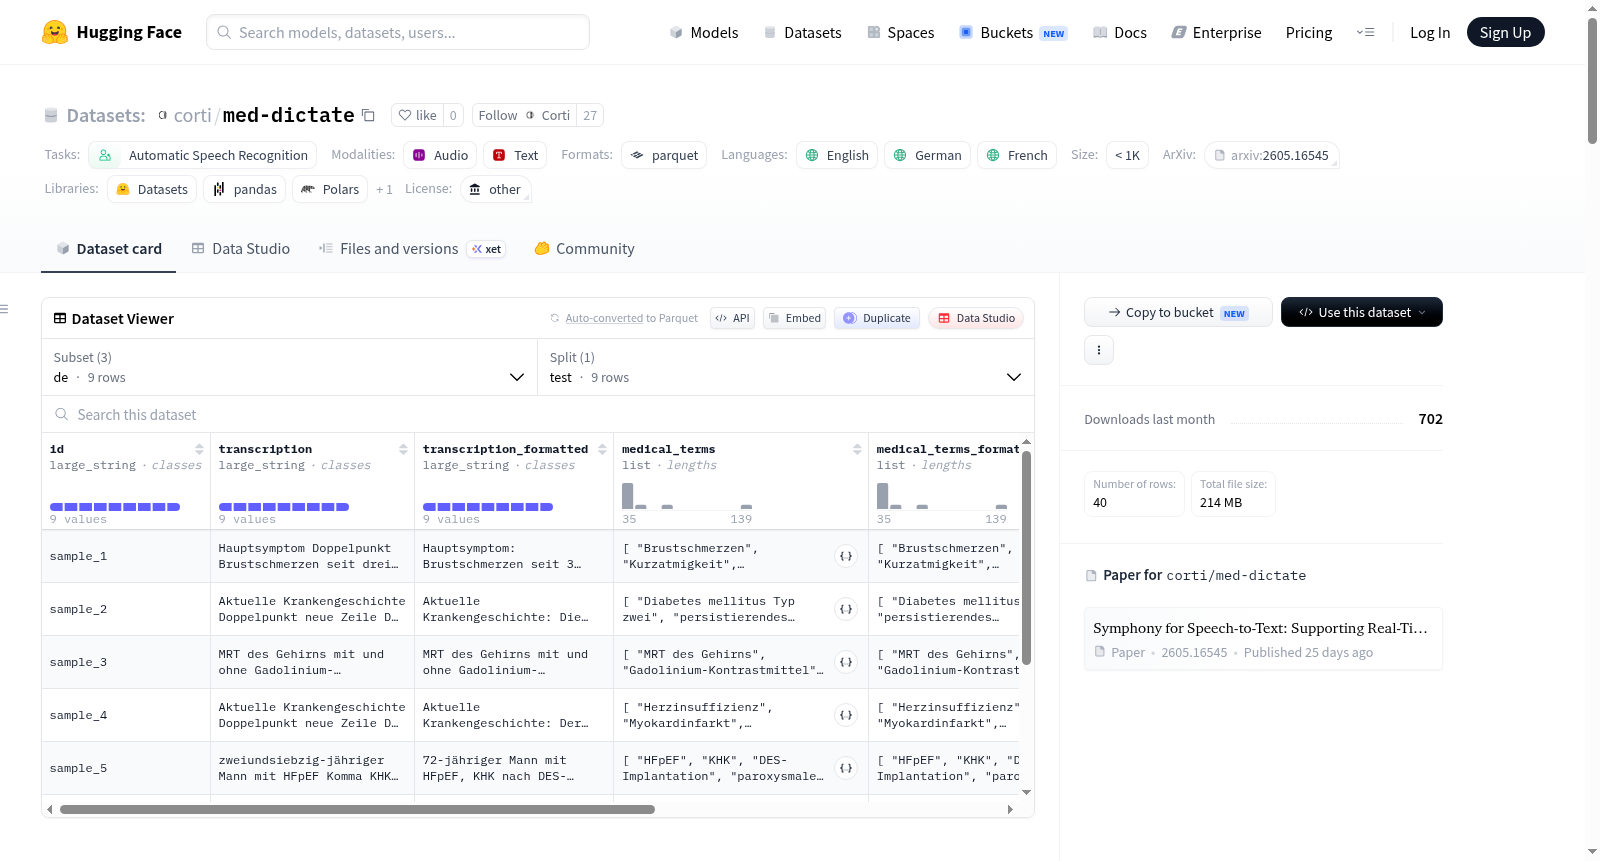
Med-Dictate是一个由Corti ApS发布的评估数据集,旨在为医疗领域的自动语音识别(ASR)和相关NLP系统提供基准测试。数据集包含英语、法语和德语的医疗笔记录音,由Corti团队成员和一名承包商在获得书面同意后录制,不涉及真实患者数据、个人健康信息(PHI)或可识别的第三方内容。数据集仅包含测试集,每个语言配置都有音频文件、原始转录、格式化转录、医学术语列表等特征。音频采样率为16kHz,单声道。数据集专门用于评估和测试预训练模型,禁止用于模型训练、语音克隆、临床决策或其他商业竞争用途。许可证基于CDLA-Permissive-2.0和Corti使用限制附加条款,并允许贡献者随时撤回同意。

Med-Dictate is an evaluation dataset released by Corti ApS for benchmarking automatic speech recognition (ASR) and related NLP systems in the medical domain. It contains medical notes dictated by Corti team members and one contractor, with their written consent, in English, French, and German. The dataset includes no real patient data, PHI, or identifiable third-party content. It consists only of a test split, with features such as audio recordings, transcriptions, formatted transcriptions, medical terms, and formatting terms. Audio is sampled at 16kHz in mono. The dataset is intended solely for evaluating pre-existing models and prohibits use for training, voice cloning, clinical decisions, or commercial competition. It is licensed under CDLA-Permissive-2.0 with Cortis Use Restrictions Addendum, and voice contributors can withdraw consent at any time.
提供机构:
corti
搜集汇总
数据集介绍
corti/med-dictate 数据集图片
构建方式
Med-Dictate数据集由Corti ApS团队及其合作者基于真实医疗场景口述构建而成,成员在知情同意下以英语、法语和德语三种语言录制了临床笔记。数据采集过程严格规避真实患者信息与任何可识别第三方内容,确保无受保护健康信息(PHI)泄露。所有音频均以16kHz单声道格式存储,并附带原始转录文本、格式化后的转录文本以及医学实体术语序列等多维标注信息,形成一套专用于医疗领域自动语音识别(ASR)系统评测的基准数据集。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据集,默认加载英语配置,亦可通过指定语言参数'fr'或'de'获取法语与德语版本。数据集仅提供测试集划分,专用于对已有ASR或自然语言处理模型的性能评估与基准测试。需特别注意,该数据集严禁用于任何形式的模型训练、微调或开发活动,也不得用于临床诊断决策或语音克隆等用途,遵循Corti ASR评测数据集的特定许可协议,确保贡献者权益与应用的伦理合规性。
背景与挑战
背景概述
医学领域的自动语音识别(ASR)系统在临床文档处理、实时医患交互及医疗数据录入中扮演着日益关键的角色。然而,医疗场景下专业术语密集、多语言需求迫切且音频环境复杂,对ASR模型的鲁棒性提出了严苛要求。Med-Dictate数据集由丹麦医疗AI公司Corti ApS于2026年推出,其核心研究问题是评估ASR及自然语言处理系统在医疗领域音频上的表现,而非用于模型训练。该数据集依赖团队成员及承包商的授权听写,覆盖英语、法语和德语三种语言,总计40个样本、逾两小时音频时长,每个样本包含原始转录、格式化转录及医学专用术语标注。作为Corti白皮书《Symphony for Speech Recognition》的配套基准,Med-Dictate填补了医疗领域多语言ASR评估标准的空白,为检验模型在真实临床听写场景中的准确性提供了可复现的测试框架。
当前挑战
Med-Dictate所解决的领域问题聚焦于医疗ASR评估中的核心挑战:通用模型常因缺乏专业术语覆盖和语境理解而在医学转录中表现不佳,例如误识别药物名称、解剖结构或病理描述,导致临床文档质量下降。该数据集通过提供带有精确医学术语的标注数据,推动研究者量化模型在专业词汇识别上的误差。构建过程中,数据集面临多重挑战:首先,确保音频隐私绝对安全,禁止包含真实患者数据或可识别第三方内容,所有记录均来自知情同意的内部人员;其次,实现多语言均衡覆盖,但英语样本(24条)远超法语(7条)和德语(9条),可能导致跨语言评估偏差;最后,严格限定使用范围——仅用于评测而禁止模型训练或音频克隆,这种RAIL风格许可条款在法律和技术上均需精心设计以平衡开放性与伦理限制。
常用场景
经典使用场景
Med-Dictate 数据集专为评估医疗领域自动语音识别(ASR)系统而构建,其经典使用场景在于对预训练语音模型在医学听写任务上的性能进行标准化基准测试。数据集中包含英语、法语和德语三语种的医疗笔记音频,并提供了精准的转录文本、结构化格式化版本以及标注的医学术语序列。研究者利用该数据集对比不同 ASR 模型在医学词汇识别、口音鲁棒性及多语言泛化能力上的表现,尤其适用于检验系统能否在噪声环境下准确捕捉长尾专业术语,从而推动医疗语音交互技术的标准化评估流程。
解决学术问题
该数据集解决了医疗语音识别领域长期缺乏高质量、可公开评估的跨语言基准数据问题。过往学术研究常受限于患者隐私法规(如 HIPAA 或 GDPR)而难以获取真实临床音频,导致模型验证多依赖合成数据或模拟场景。Med-Dictate 通过招募团队成员并取得书面知情同意,在不涉及真实患者或受保护健康信息的前提下,提供了涵盖丰富医学术语的听写样本。这为学术社区带来了去标识化、且包含深层结构化标注(如格式化文本与术语分类)的评估资源,显著促进了多语言医疗 ASR 系统的公正比较与可重复性研究。
实际应用
在实际应用中,Med-Dictate 主要服务于医疗语音转录软件的质量保障与商业化基准测试。临床环境中,医生常通过口述生成电子病历,而 ASR 模型的精确度直接关系到诊疗记录的准确性。该数据集允许医院信息系统供应商或医疗科技公司在部署前,对内部研发的语音识别模块进行客观的跨语言性能检测。例如,评估模型能否正确区分同音异义的药品名称或解剖学术语,从而确保生成的临床摘要不会因识别错误而引发医疗风险。此外,数据集明确禁止用于模型训练,这种使用限制也模拟了真实部署中无法窥见训练数据的场景,提升了测试的公平性。
数据集最近研究
最新研究方向
在医疗语音识别领域,Med-Dictate数据集的发布标志着专用域评估基准的重要革新。该数据集由Corti ApS团队与《Symphony for Speech Recognition》白皮书同步推出,聚焦于英、法、德三语种的医疗听写音频,为自动语音识别系统的医学场景性能评估提供了稀缺的标准化资源。当前前沿研究正借助这一数据集,探索临床语境下专业医学术语识别的精准度优化、多语言医疗语音模型的跨域泛化能力,以及实时医疗语音界面中语义格式化的鲁棒性。其独特的多维度标注——包含原始转录、格式化文本及医疗术语序列——不仅推动了ASR系统在噪声环境、术语歧义等方面的鲁棒性评估,更催化了医疗语音接口从实验室走向真实临床部署的验证进程,对于实现高效、安全的智能辅助诊疗系统具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

