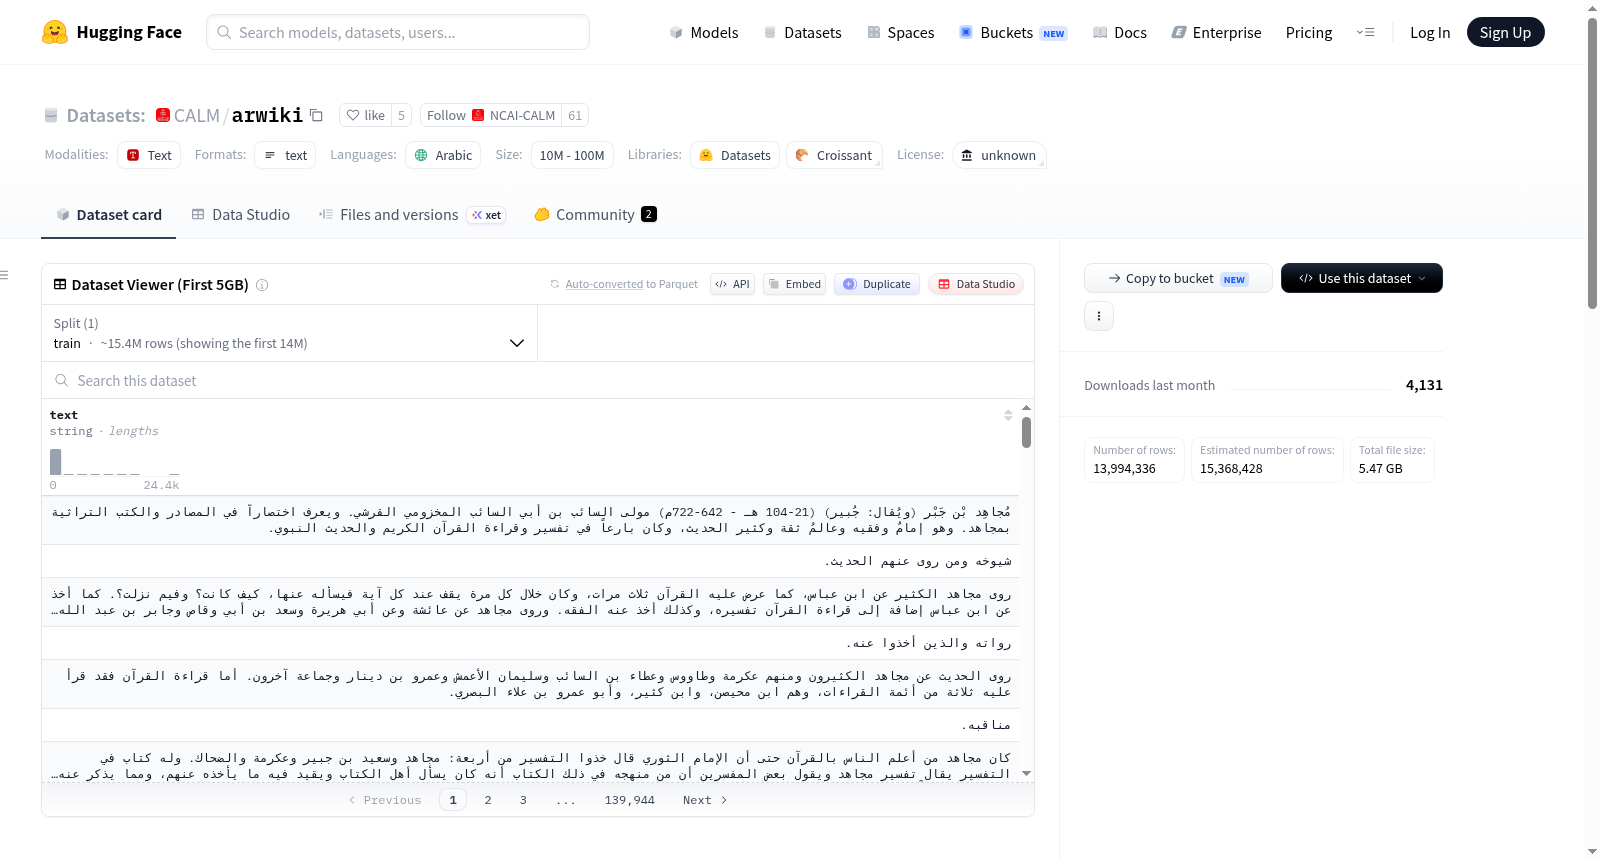
CALM/arwiki
收藏资源简介:
--- pretty_name: Wikipedia Arabic dumps dataset. language: - ar license: - unknown multilinguality: - monolingual --- # Arabic Wiki Dataset ## Dataset Summary This dataset is extracted using [`wikiextractor`](https://github.com/attardi/wikiextractor) tool, from [Wikipedia Arabic pages](https://dumps.wikimedia.org/arwiki/). ## Supported Tasks and Leaderboards Intended to train **Arabic** language models on MSA (Modern Standard Arabic). ## Dataset Structure The dataset is structured into 2 folders: - `arwiki_20211213_txt`: dataset is divided into subfolders each of which contains no more than 100 documents. - `arwiki_20211213_txt_single`: all documents merged together in a single txt file. ## Dataset Statistics #### Extracts from **December 13, 2021**: | documents | vocabulary | words | | --- | --- | --- | | 1,136,455 | 5,446,560 | 175,566,016 | ## Usage Load all dataset from the single txt file: ```python load_dataset('CALM/arwiki', data_files='arwiki_2021_txt_single/arwiki_20211213.txt') # OR with stream load_dataset('CALM/arwiki', data_files='arwiki_2021_txt_single/arwiki_20211213.txt', streaming=True) ``` Load a smaller subset from the individual txt files: ```python load_dataset('CALM/arwiki', data_files='arwiki_2021_txt/AA/arwiki_20211213_1208.txt') # OR with stream load_dataset('CALM/arwiki', data_files='arwiki_2021_txt/AA/arwiki_20211213_1208.txt', streaming=True) ```
--- 数据集名称:维基百科阿拉伯语转储数据集。 语言: - 阿拉伯语(ar) 许可协议: - 未知 多语言属性: - 单语 --- # 阿拉伯语维基百科数据集 ## 数据集概述 本数据集通过[`wikiextractor`](https://github.com/attardi/wikiextractor)工具,从[维基百科阿拉伯语页面转储](https://dumps.wikimedia.org/arwiki/)提取得到。 ## 支持任务与排行榜 本数据集旨在针对现代标准阿拉伯语(MSA,Modern Standard Arabic)训练阿拉伯语语言模型。 ## 数据集结构 本数据集分为两个文件夹: - `arwiki_20211213_txt`:数据集被划分为若干子文件夹,每个子文件夹包含不超过100份文档。 - `arwiki_20211213_txt_single`:所有文档合并为一个纯文本文件。 ## 数据集统计信息 #### 2021年12月13日提取的统计数据: | 文档数 | 词汇量 | 总词数 | | ---- | ---- | ---- | | 1,136,455 | 5,446,560 | 175,566,016 | ## 使用方法 从单个纯文本文件加载完整数据集: python load_dataset('CALM/arwiki', data_files='arwiki_2021_txt_single/arwiki_20211213.txt') # 或采用流式加载方式 load_dataset('CALM/arwiki', data_files='arwiki_2021_txt_single/arwiki_20211213.txt', streaming=True) 从分块文本文件加载较小子集: python load_dataset('CALM/arwiki', data_files='arwiki_2021_txt/AA/arwiki_20211213_1208.txt') # 或采用流式加载方式 load_dataset('CALM/arwiki', data_files='arwiki_2021_txt/AA/arwiki_20211213_1208.txt', streaming=True)
数据集概述
数据集名称
- 名称:Wikipedia Arabic dumps dataset
- 语言:阿拉伯语(ar)
- 许可证:未知
- 多语言性:单语种
数据集摘要
- 提取工具:
wikiextractor - 来源:Wikipedia Arabic pages
支持的任务和排行榜
- 目的:训练现代标准阿拉伯语(MSA)语言模型
数据集结构
arwiki_20211213_txt: 分为多个子文件夹,每个子文件夹包含不超过100个文档。arwiki_20211213_txt_single: 所有文档合并为一个txt文件。
数据集统计
- 提取日期:2021年12月13日
- 文档数量:1,136,455
- 词汇量:5,446,560
- 单词总数:175,566,016
使用方法
-
加载整个数据集: python load_dataset(CALM/arwiki, data_files=arwiki_2021_txt_single/arwiki_20211213.txt)
或使用流式加载: python load_dataset(CALM/arwiki, data_files=arwiki_2021_txt_single/arwiki_20211213.txt, streaming=True)
-
加载小部分数据集: python load_dataset(CALM/arwiki, data_files=arwiki_2021_txt/AA/arwiki_20211213_1208.txt)
或使用流式加载: python load_dataset(CALM/arwiki, data_files=arwiki_2021_txt/AA/arwiki_20211213_1208.txt, streaming=True)