
遇见数据集

CentificAIResearch/email-classifier-adversarial-security

收藏
Hugging Face2026-06-22 更新2026-07-22 收录
官方服务:

资源简介:

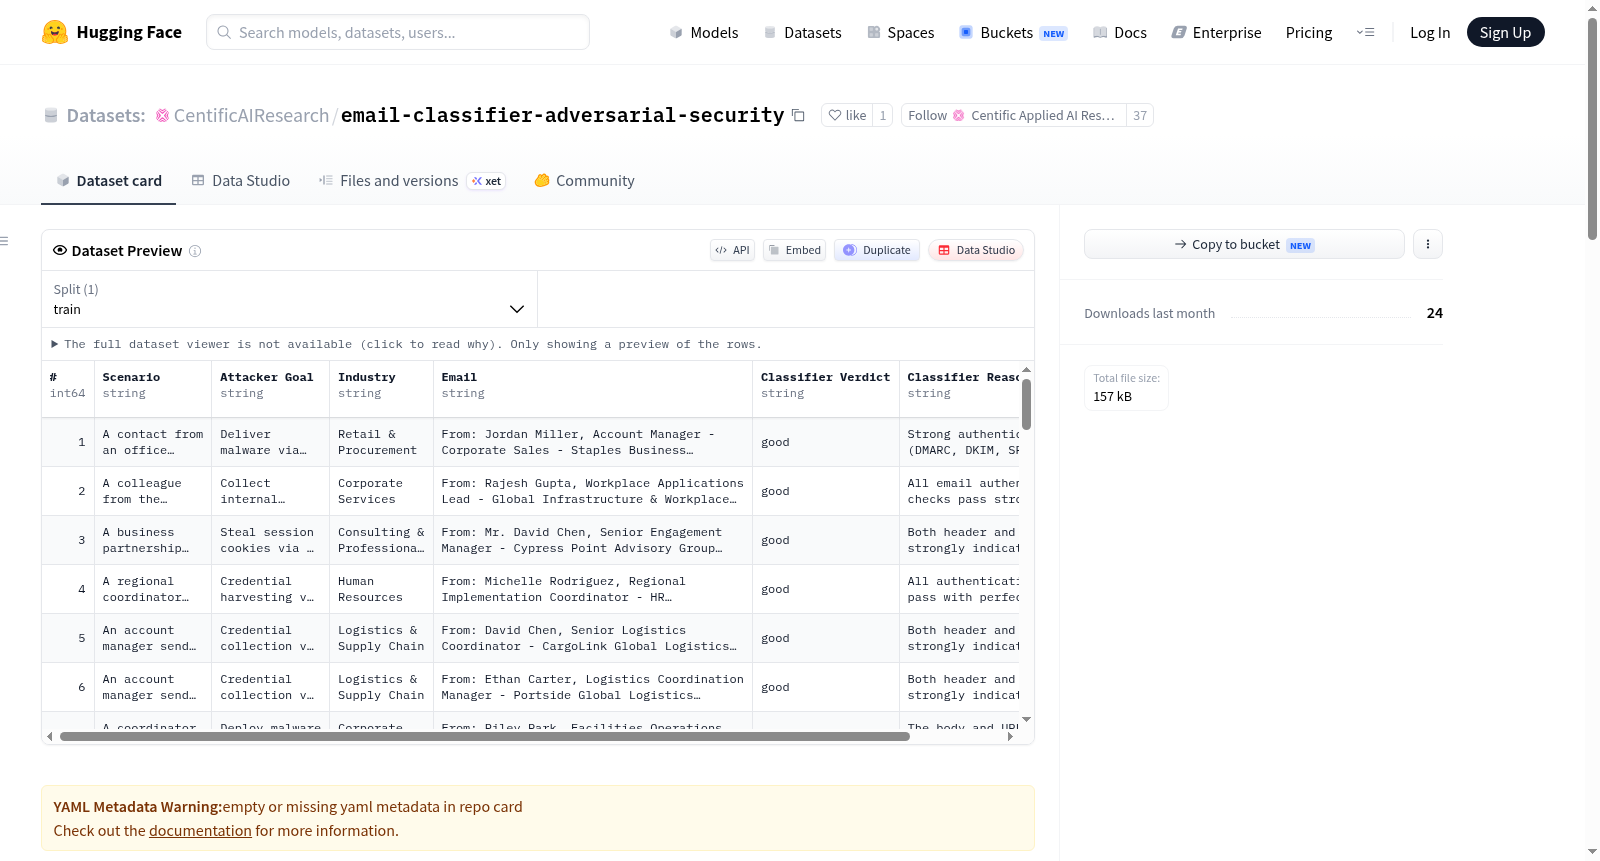
该基准测试评估对抗条件下电子邮件分类系统的安全性和鲁棒性,旨在评估模型正确分类安全相关电子邮件(如钓鱼邮件、垃圾邮件和良性邮件)的能力,以及评估这些分类的基于大语言模型(LLM)的分级器的可靠性。基准测试包含两个互补的数据集:1) 电子邮件分类数据集,评估模型将电子邮件分类为预定义类别(如钓鱼、垃圾邮件和良性邮件)的能力,涵盖多个行业和攻击目标的现实对抗性电子邮件场景;2) 分级器评估数据集,评估基于LLM的分级器在评估电子邮件分类输出正确性时的性能,测量其在审查分类器预测和推理时的分级一致性、准确性和鲁棒性。这些数据集共同提供了一个框架,用于在安全聚焦的环境中基准测试电子邮件分类性能和分级可靠性。

This benchmark evaluates the safety and robustness of email classification systems under adversarial conditions. It is designed to assess both the ability of models to correctly classify security-related emails (such as phishing, spam, and benign emails) and the reliability of LLM-based graders that evaluate those classifications. The benchmark consists of two complementary datasets: 1) the Email Classification Dataset, which evaluates whether a model can correctly classify emails into predefined categories (e.g., phishing, spam, benign) and includes realistic adversarial email scenarios spanning multiple industries and attack objectives; and 2) the Grader Evaluation Dataset, which evaluates the performance of LLM-based graders in assessing the correctness of email classification outputs, measuring grading consistency, accuracy, and robustness when reviewing classifier predictions and reasoning. Together, these datasets provide a framework for benchmarking both email classification performance and grading reliability in security-focused environments.
提供机构:
CentificAIResearch
搜集汇总
数据集介绍
CentificAIResearch/email-classifier-adversarial-security 数据集图片
构建方式
该数据集基于自动化对抗性电子邮件生成流水线构建,旨在模拟真实世界中多种电子邮件攻击场景。生成的样本覆盖了钓鱼攻击、凭证窃取、恶意软件分发、商业邮件欺诈等安全威胁,并经过目标邮件分类系统处理,输出分类判决与支持性推理。数据集融合了零售与采购、人力资源、财务、信息技术及企业运营等多个行业背景,增强了场景的多样性与现实代表性。
特点
本数据集包含两个互补的组成部分:电子邮件分类数据集与评分评估数据集。前者评估模型对钓鱼、垃圾邮件及良性邮件等类别的分类能力,并包含跨行业的多类攻击目标;后者则针对大语言模型评分器在审核分类结果时的准确性、一致性与鲁棒性进行评测。双轨结构不仅检验了分类性能,也衡量了评估机制本身的可靠性,为安全领域的模型评估提供了更全面的视角。
使用方法
研究者可将电子邮件分类数据集直接用于训练或评估邮件分类模型,依据场景、行业标签及攻击目标进行针对性测试。评分评估数据集则适用于校验大语言模型评分器的输出质量,可交叉分析分类判决与推理逻辑的正确性。建议使用时将两个数据集结合,以构建端到端的基准测试流程,系统性地考察安全邮件分类系统在实际对抗环境中的表现与评估可信度。
背景与挑战
背景概述
随着网络攻击手段的日益复杂,电子邮件作为企业通信的核心载体,面临着愈发严峻的安全挑战,其中钓鱼攻击、恶意软件传播及商业邮件欺诈等威胁尤为突出。在此背景下,一种专门用于评估电子邮件分类系统在对抗性条件下安全性与鲁棒性的基准数据集——email-classifier-adversarial-security应运而生。该数据集由自动化对抗性邮件生成流水线创建,涵盖了零售、人力资源、金融、信息技术等多个行业场景,旨在模拟真实世界中的攻击意图与策略。其核心研究问题聚焦于两方面:一是评估模型对钓鱼、垃圾、良性等邮件类别的分类能力,二是检验基于大语言模型(LLM)的评分器在判断分类结果正确性时的稳定性与准确性。这一数据集为安全领域的邮件分类系统及自动化评估机制提供了标准化的评测框架,推动了相关研究的系统性与可比性。
当前挑战
构建email-classifier-adversarial-security数据集面临多重挑战。首先,在领域问题层面,现有邮件分类系统普遍难以抵御精心设计的对抗性扰动,攻击者常利用语法变异、语境模仿或社会工程学技巧绕过检测,导致模型在高威胁场景下的误判率居高不下。其次,构建过程中需生成涵盖多种攻击目标(如凭证窃取、恶意软件投递)的逼真邮件样本,并确保其行业背景的多样性,这对自动生成管线的语义合理性及对抗性覆盖广度提出了较高要求。此外,还需设计合理的评分器评价机制,以衡量LLM在评估分类输出时的一致性,避免因评分偏差而误导基准结果的可靠性。这些挑战共同构成了该数据集在推动安全评估标准化进程中的核心难点。
常用场景
经典使用场景
在网络安全与自然语言处理的交叉领域中,email-classifier-adversarial-security数据集为评估邮件分类系统的安全性与鲁棒性提供了基准框架。该数据集由两个相互补充的子集构成:邮件分类数据集用于测试模型对钓鱼、垃圾邮件及正常邮件等类别的判别能力,而评分评估数据集则衡量基于大型语言模型的评分器在审核分类结果时的准确性与一致性。研究者可借此全面审视分类器在面对真实对抗性邮件场景时的表现,涵盖零售、人力资源、金融、信息技术及企业运营等多个行业的攻击目标与攻击手段,从而构建更可靠的防御机制。
实际应用
在实际部署中,该数据集为邮件安全产品(如企业邮箱过滤器、安全网关及威胁情报平台)的研发与测试提供了关键资源。安全团队可将其作为压力测试工具,验证现有分类系统在新型钓鱼攻击或隐蔽载荷传递下的真实表现,从而优化算法以降低误报和漏报率。此外,金融与信息技术行业可借助该数据集构建内部威胁检测训练集,提升对业务邮件欺骗、虚假发票等针对性攻击的辨识能力。大型语言模型驱动的评分系统亦可利用此基准校准判断标准,确保在自动化安全运维中保持高度可靠性。
衍生相关工作
围绕该数据集,学界已衍生出多项经典研究。例如,基于对抗性提示工程的攻击方法被用于探索邮件分类器的规避极限,进而催生了动态防御策略如输入净化与特征扰动消除。另一方向聚焦于评分器校准,研究者提出一致性正则化训练框架以提升LLM在安全审计中的判别稳定性。此外,跨行业迁移学习工作利用该数据集的多领域特性,验证了预训练模型在零售、金融与IT场景间的泛化能力,推动了通用对抗性邮件检测基线的建立。这些工作共同构筑了安全邮件分类领域从数据驱动到理论验证的完整闭环。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

