
Serenity Watch Dataset
收藏官方服务:
资源简介:
一个基于Serenity(X上的@aleabitoreddit)公开帖子构建的结构化数据集,跟踪900多只股票,涵盖美国、欧洲、日本、台湾和韩国市场,包含13,000多条带有立场标签、原因和原始帖子链接的提及记录,数据以JSON文件存储,适用于分析和研究。
A structured dataset constructed from public posts by Serenity (@aleabitoreddit on X). It tracks over 900 stocks across the U.S., European, Japanese, Taiwanese and South Korean markets, and contains more than 13,000 mention records with stance labels, relevant reasons and links to the original posts. The data is stored in JSON files and is suitable for analytical and research purposes.
创建时间:
2026-06-06
原始信息汇总
数据集概述:Serenity Watch
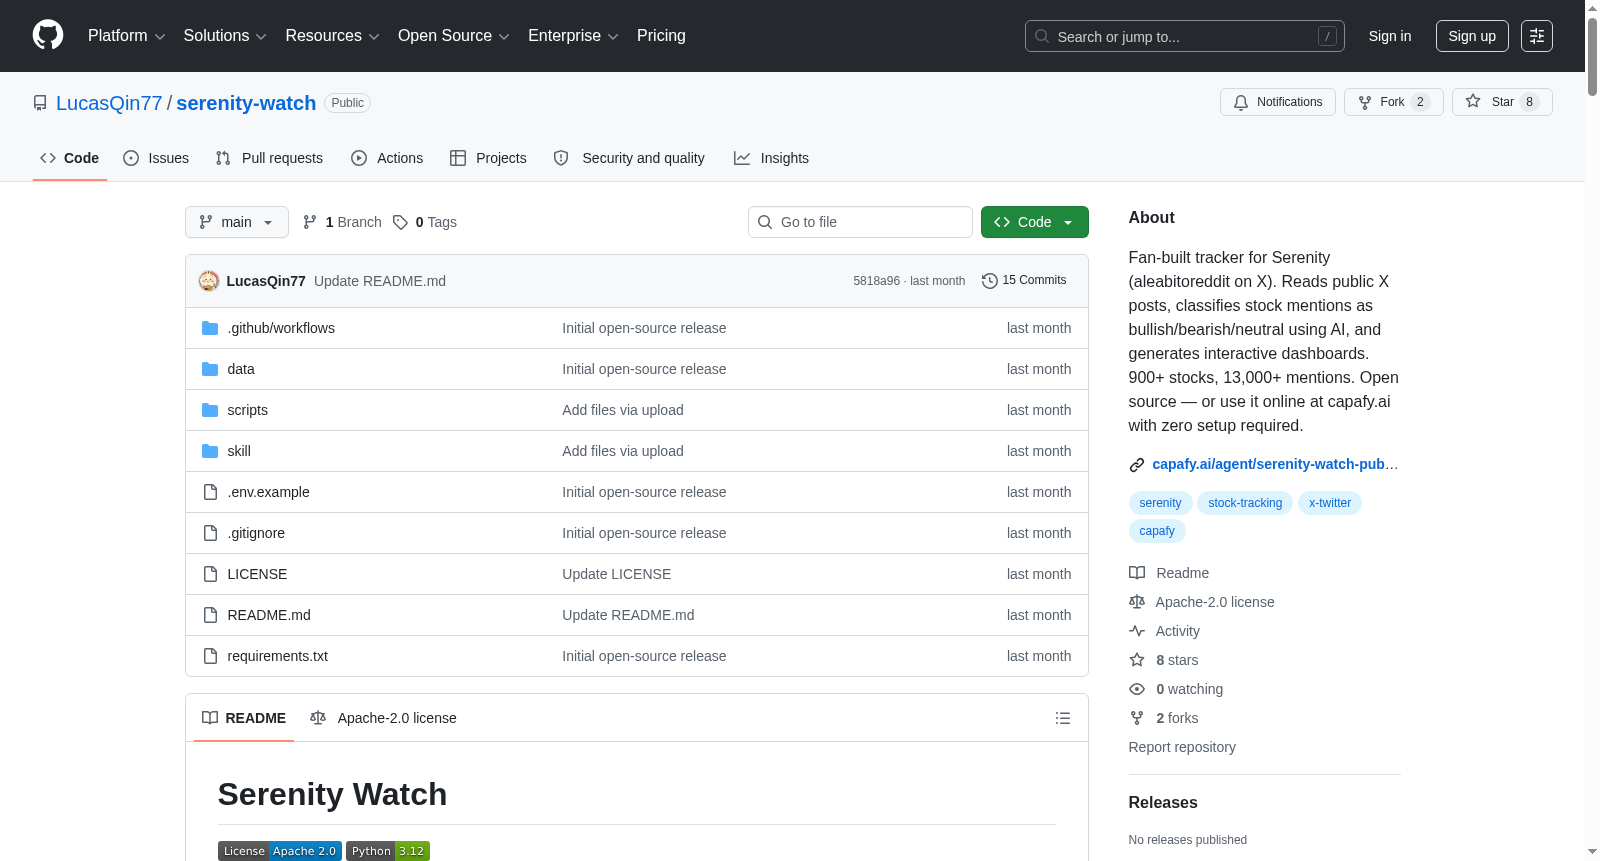
Serenity Watch 是一个开源工具,用于追踪 X(Twitter)平台上的 AI 半导体投资领域有影响力的人物 @aleabitoreddit (Serenity) 的公开帖子。该项目通过 AI 对帖子中提及的股票进行分类和结构化整理。
数据集规模与范围
- 覆盖 900+ 只股票,涵盖美国、欧洲、日本、台湾和韩国市场。
- 从 约 6,200 条帖子(时间范围:2025年7月至2026年6月)中提取出 13,000+ 条结构化提及。
- 每条提及包含立场标签、理由以及指向原始帖子的链接。
- 所有数据以纯 JSON 文件格式存储。
核心功能
- 结构化数据集:包含每个股票提及的日期、立场(看涨/看跌/中性)、提及类型(明确立场/背景提及/比较等)、理由、原始帖子文本、互动数据等。
- 交互式 HTML 仪表盘:支持日/周/月/季度视图,每个股票可点击进入详情页,包含价格图表、立场时间线及原始帖子链接。
- 单股问答脚本:查询任何追踪的股票代码,获得结构化的分析(论点演变、关键意见、看涨/看跌理由)。
- 自动化更新:通过 GitHub Actions 实现每小时自动同步新帖子与 AI 提取(需自备 API 密钥),以及每个交易日收盘后更新股价。
数据模式(Schema)
每个股票文件 (data/db/stocks/{TICKER}.json) 包含:
ticker,company,industry等基本信息。first_mention,last_mention,total_mentions统计。price_series:每日收盘价序列。mentions数组:每个提及对象包含date,stance,mention_type,reasons,text,url,engagement等字段。
技术架构与依赖
- 数据获取:使用官方 X API v2 获取公开推文(需 Bearer Token)。
- AI 提取:使用 Anthropic Claude (
claude-opus-4-6为默认模型) 进行立场提取。提示词针对 Claude 进行了优化。 - 股价数据:使用开源库 AKShare 获取美股收盘价(无需 API 密钥)。非美国股票的价格数据可能不可用。
- 处理流程:
fetch_tweets→extract(LLM) →build_db(聚合) →prices(股价) →verify_data(验证) →render(生成仪表盘)。其中build_db每次完全重建,extract仅处理最近7天数据。
使用方式
- 本地运行:配置好 X Bearer Token 和 Anthropic API 密钥后,可运行完整 pipeline 或单独生成仪表盘、分析个股。
- 托管版本:也可通过 Capafy 平台 在线使用,无需任何设置。
重要声明
- 该项目是粉丝构建的工具,与 @aleabitoreddit (Serenity) 无任何关联。
- 数据由 AI 提取和总结,可能存在错误、遗漏或误解(如比喻、第三方引用可能被错误分类)。
- 不构成投资建议、财务分析或买卖任何证券的推荐。请始终参考原始帖子并独立验证。
- 股价数据来自第三方,可能延迟、不完整或不准确。
- 该项目采用 Apache License 2.0 许可证。
搜集汇总
数据集介绍
构建方式
Serenity Watch Dataset是基于X平台上的AI半导体投资意见领袖Serenity(@aleabitoreddit)公开发布的帖子构建而成的开源结构化数据集。项目通过X API v2获取其约6200条帖子(涵盖2025年7月至2026年6月期间),随后利用Anthropic Claude系列大语言模型对每篇帖子进行自动化语义分析,识别并提取其中提及的股票信息,包括持仓态度(看多、看空、中立)、提及类型(明确表态、背景提及、比较分析、引用他人、行业讨论、风险提示)以及具体理由。这些结构化输出经过聚合脚本处理后,被整理为超过900只个股的独立JSON文件,涵盖美国、欧洲、日本、台湾和韩国等市场。此外,项目还通过AKShare开源金融数据接口获取个股的每日收盘价数据作为补充。整个流程支持GitHub Actions自动触发每小时增量更新,确保数据持续的时效性与完整性。
特点
该数据集的核心特色在于其深度解析了Serenity对AI半导体供应链中上市公司的独到见解,而非简单的股价信息堆积。每个股票条目包含完整的脉络性信息:首次提及与最近提及的日期、所有提及的立场变迁时间线、每一条具体理由原文(保持原始语言,不翻译),以及关联到Serenity原始帖子的链接与互动数据。数据集对提及类型进行精细区分,仅将明确表态计入立场统计,而背景提及和引用他人观点等则单独追踪,避免误判。交互式HTML仪表盘提供了日、周、月、季度等多维度视图,支持每只股票的详情页面,展示价格走势图与立场演变轨迹。单股分析脚本能提取叙事弧线、立场转换节点、看多/看空理由以及频率趋势,将碎片化信息整合为可被大语言模型直接利用的结构化脉络。
使用方法
使用Serenity Watch Dataset的方式灵活多样。最简单的方式是通过Capafy在线平台直接访问预置的仪表盘和股票问答功能,无需任何配置。对于希望深度定制的用户,可以Fork该GitHub仓库,在项目中配置X API的Bearer Token和Anthropic API密钥,即可激活GitHub Actions的自动更新功能,实现每小时同步新帖子、每个交易日更新股价。本地环境使用则更自由:通过pip安装依赖后,可运行脚本生成任意日期的交互式HTML仪表盘,或使用单股分析脚本(analyze_stock.py)查询具体股票的结构化分析结果。全部数据以纯JSON格式存储在data/db/stocks/目录下,可直接接入自定义的分析工具、可视化面板或研究管线。对于希望运行完整本地管线的用户,项目提供了从抓取帖子、LLM提取、数据库重建到价格更新和仪表盘生成的完整脚本序列。
背景与挑战
背景概述
Serenity Watch数据集诞生于人工智能与半导体投资交织的浪潮之中,由一位名为Serenity(@aleaboreddit)的X平台意见领袖持续构建,其影响力横跨全球金融市场,关注者逾70万。该数据集的创建旨在系统性地追踪并结构化呈现Serenity对AI半导体供应链的深度剖析,聚焦于那些在主流视野之外却至关重要的核心组件制造商。数据集核心涵盖2025年7月至2026年6月间约6,200条公开帖子,从中提取出超过13,000条涉及900余只股票的机构化提及,横跨美国、欧洲、日本、台湾及韩国等多个市场。研究团队借助Claude等大型语言模型对每一条提及进行立场标注(看涨、看跌、中性等),并附带具体的推理依据与原文链接,从而将分散于社交媒体中的非结构化信息转化为可检索、可分析的结构化知识资产。该数据集在AI投资社区中产生了广泛反响,为供应链研究、金融市场情绪分析以及投资者决策支持提供了独特的数据源泉。
当前挑战
该数据集所面对的挑战首先根植于金融社交内容的本质特性:分析师在帖文中大量使用隐喻、修辞性反问及第三方引述,使得大语言模型在精准判定立场时面临极高的语义混淆风险,模型选择与提示词优化成为构建过程中的核心难题。其次,X平台API对于公开帖子的历史获取存在约3,200条的上限,完整回溯6,200条帖子需要跨多次增量拉取与本地缓存整合,数据获取的完整性与实时性之间存在天然的张力。此外,跨市场股票的价格数据获取,尤其是非美国上市标的,受限于数据源的覆盖范围,部分标的的价格序列可能标注为“未覆盖”,从而影响分析面板的完整性。最后,数据集的持续更新依赖于每小时一次的自动流水线,这要求工作流能够在有限API配额下高效运行,并妥善处理提取失败的帖子进行最多7次重试,系统架构的健壮性与资源消耗之间需要精细平衡。
常用场景
经典使用场景
在人工智能与半导体投资这一前沿交叉领域,Serenity Watch Dataset为研究者提供了一套系统化的数据集,用于追踪和分析X平台上关键意见领袖(KOL)Serenity公开提及的超过900只股票信息。该数据集尤其适用于量化投资策略研究、金融情感分析以及信息传播动力学探索,研究人员可基于其中包含的13,000余条结构化工单分类数据(看涨、看跌、中性等),结合所附的股票价格序列与互动数据,深入剖析KOL言论对市场行为的潜在影响路径。
解决学术问题
该数据集巧妙地弥合了计算社会科学与金融投资研究之间的鸿沟。它有效解决了长期以来困扰学界的两个核心问题:一是如何从海量社交媒体文本中,精准提取针对特定股票的立场观点并形成结构化的标注数据;二是如何实证量化社交媒体上专业意见领袖的公开言论与金融市场动态之间的关联模式。其意义在于为金融科技、行为金融学及自然语言处理领域提供了高信度、可复现的研究基座,推动了融合社会信号挖掘与市场分析的方法论创新。
衍生相关工作
该数据集衍生出了一系列标志性的算法工具与分析范式。其构建的基于Claude大语言模型的高精度立场抽取流程(extract.py)以及可确定性生成的交互式HTML看板(serenity_render.py),已成为同类金融社交媒体研究项目中广泛参考的技术模板。此外,所配套的个股叙事弧线分析脚本(analyze_stock.py)开创性地提出了对单只股票舆论历程的结构化建模方法,为后续关于叙事金融学、市场情绪周期以及信息级联效应等方向的实证研究铺设了重要的实验路径与数据基础设施。
以上内容由遇见数据集搜集并总结生成


