
遇见数据集

ChristianYang/Env-TTS-Clean

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

环境感知文本到语音训练语料库(清洁版本)。每行数据配对四个短24 kHz单声道FLAC音频剪辑及其对齐的转录:一个环境样本(不同说话者,相同声学场景)、一个说话者参考(与目标话语相同说话者)、说话者参考的增强版本(使用MossFormer2语音增强技术)以及要合成的目标语音。这样,模型可以学习生成具有指定语音和指定环境的话语。此版本取代了早期的Env-TTS-SD-Corpus,具有更丰富的模式、更高的采样率、所有三个上下文的每剪辑ASR以及两个额外的会议来源(AMI和AliMeeting)。数据集包含189,918行数据,总语音时长为1,542,868.6秒(约428.6小时),总音频时长为4,507,421.5秒(约1,252.1小时),来源包括M3SD、AISHELL-4、AliMeeting、AMI、MSDWILD和CHiME-6等语料库。

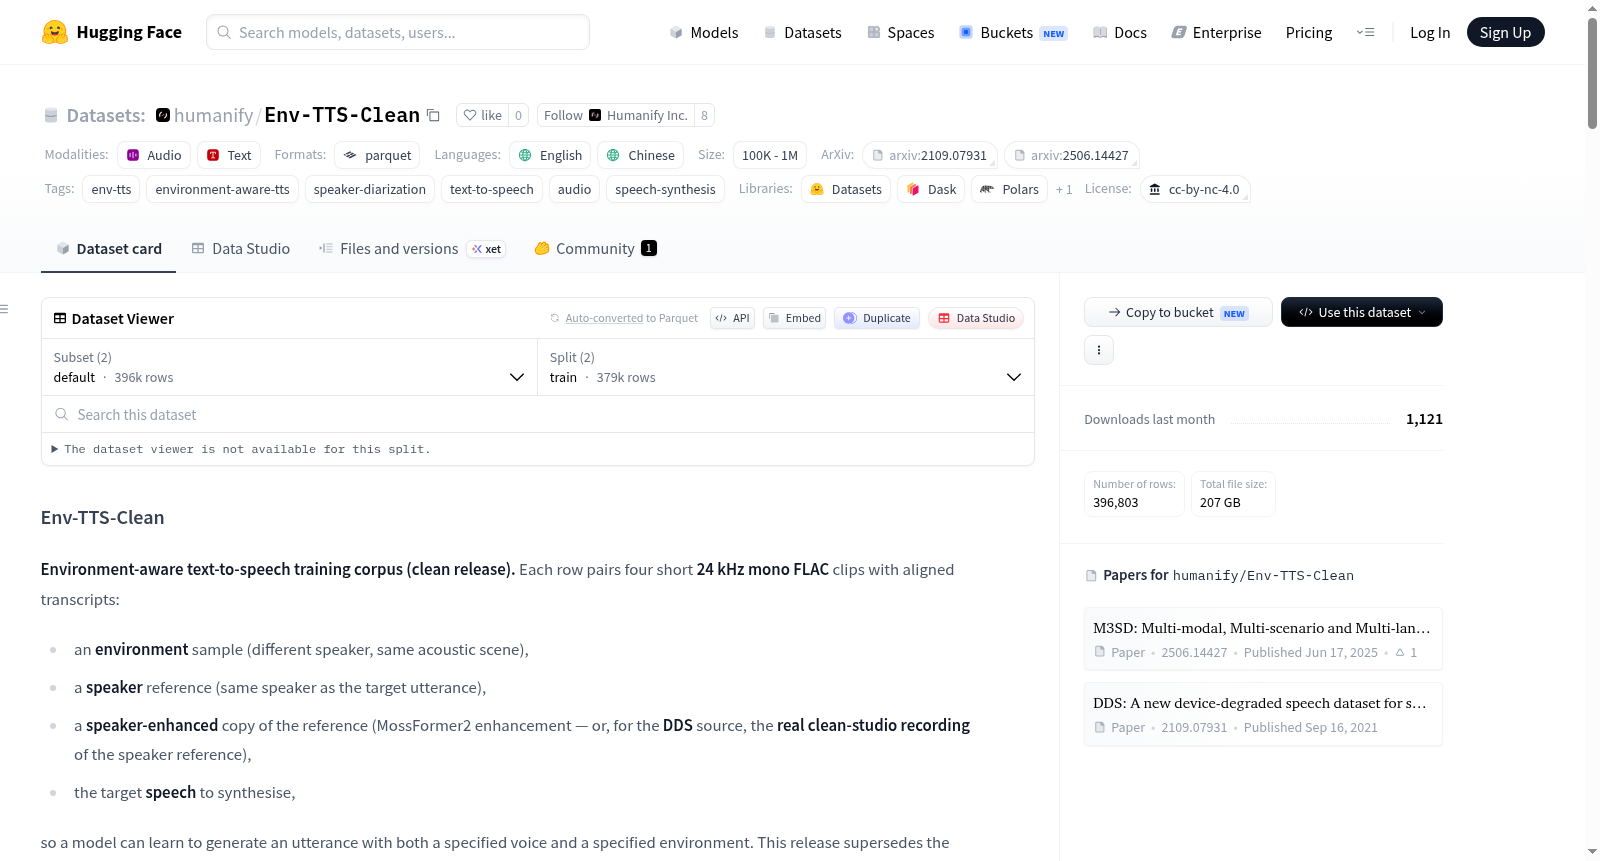
Environment-aware text-to-speech training corpus (clean release). Each row pairs four short 24 kHz mono FLAC clips with aligned transcripts: an environment sample (different speaker, same acoustic scene), a speaker reference (same speaker as the target utterance), a speaker-enhanced copy of the reference (MossFormer2 speech enhancement), and the target speech to synthesise, so a model can learn to generate an utterance with both a specified voice and a specified environment. This release supersedes the earlier Env-TTS-SD-Corpus with a richer schema, higher sample rate, per-clip ASR for all three contexts, and two additional meeting sources (AMI, AliMeeting).
提供机构:
ChristianYang
搜集汇总
数据集介绍
ChristianYang/Env-TTS-Clean 数据集图片
构建方式
Env-TTS-Clean数据集由Humanify研究团队构建,旨在服务于环境感知文本转语音任务。其构建过程依托于一个流式处理流水线,涵盖下载、处理与上传三大并行阶段。对于源自会议或自然场景的说话人日志数据,首先从HuggingFace镜像或OpenSLR等源端流式下载对话音频,经重采样至24 kHz单声道后,依据说话人日志切分出时长3至15秒的目标语音片段,同时提取同一说话人的参考片段(不低于2.5秒)与不同说话人的环境片段(不低于2.5秒)。缺失或分割后的文本转录由Qwen3-ASR-1.7B模型重新标注,形成Snappy压缩的Parquet分片。特别地,DDS子集采用专用并行通道,将同一房间、设备与位置条件下不同说话人的设备退化录音与对应干净录音直接配对,其中增强参考片段直接采用真实录音室录音,而非模型估计结果。所有数据最终以分组形式上传至HuggingFace仓库。
使用方法
该数据集可通过HuggingFace的datasets库便捷加载,支持流式读取以节省本地存储空间。加载时只需指定数据集名称与划分集(如'train'或'test'),即可迭代获取包含所有音频与文本字段的样本。音频列在访问时自动解码为24 kHz单声道NumPy数组。用户可利用'language'、'dataset'、'speaker_id'等字段实现灵活的过滤操作,例如筛选出DDS子集以进行特定场景的语音合成训练。数据集中预训练的Qwen3-ASR转录及MossFormer2增强参考音频,可直接用于环境感知的说话人条件建模、语音增强与语音合成联合学习等任务。对于需要处理大规模数据的场景,建议采用流式加载并搭配按需解码策略,以平衡内存与计算效率。
背景与挑战
背景概述
Env-TTS-Clean数据集由研究机构humanify于2025年发布,旨在解决环境感知文本到语音合成(TTS)中的核心挑战——如何在特定声学场景下生成具有目标说话人音色且与背景噪声环境一致的语音。该数据集整合了AMI、AliMeeting等七个来源的会议和朗读语音数据,包含约38.4万条样本,总时长近2000小时,覆盖中英文双语。其独特之处在于每条样本均提供环境音频、说话人参考、增强后的说话人参考及目标语音四段对齐音频,使模型能同时学习说话人特征与环境声学特性。该数据集通过引入DAPS数据集的真实干净录音作为增强基准,并采用MossFormer2进行噪声处理,显著提升了环境感知TTS的训练质量,在语音合成领域具有重要影响力。
当前挑战
该数据集面临的核心挑战包括:1)多源异构数据的统一处理,需从不同格式的会议记录中提取说话人轮次,并对缺失或分割的转录文本通过Qwen3-ASR进行重新标注,确保文本与语音对齐;2)声学环境与说话人身份的联合建模难度大,需在同一场景中分离不同说话人的语音,并确保环境参考与目标语音的音色独立性;3)数据构建中需解决大规模流式处理与存储效率问题,采用分布式管道分阶段下载、处理和上传,并压缩为Snappy格式的Parquet分片,以平衡计算资源与数据可用性;4)许可证兼容性复杂,需协调多种开源及研究许可协议,最终以CC-BY-NC-4.0发布以限制非商业用途。
常用场景
经典使用场景
Env-TTS-Clean是面向环境感知文本到语音合成(Environment-aware TTS)领域的经典训练语料库,其独特之处在于每条样本精心配对四段24kHz单声道FLAC音频片段,分别涵盖环境声学场景采样、目标说话人身份参考、经增强处理的说话人参考以及待合成的目标语音。这一结构使得模型能够同时学习指定音色与指定环境的联合生成条件,是探索多模态语音合成、声场迁移及鲁棒性语音生成任务的核心数据基础。
解决学术问题
该数据集系统性地解决了语音合成中环境鲁棒性与说话人-场景解耦的学术难题。传统TTS模型往往假设纯净录音环境,难以泛化至实际声学条件。Env-TTS-Clean通过在同一场景中采样不同说话人的环境片段与目标语音,为模型提供了显式的声学场景监督信号,使研究者能够探索环境噪声建模、说话人特征分离以及跨场景语音生成等关键问题。其发布不仅填补了环境感知TTS领域大规模配对数据的空白,还推动了语音合成从实验室静音环境迈向真实声学场景的学术范式转变,对提升合成语音在复杂环境下的自然度与可懂度具有深远影响。
实际应用
在实际应用中,Env-TTS-Clean可用于开发具有环境自适应能力的语音助手、有声读物生成系统及通讯增强设备。例如,智能家居设备可依据实时声学场景(如厨房嘈杂、卧室安静)动态调整合成语音的音色与背景融合度,提升用户沉浸感。此外,该语料库还支持构建多说话人、多环境的个性化语音克隆系统,在虚拟主播、辅助沟通工具及游戏角色配音等领域展现出广阔前景,尤其适用于需要兼顾说话人身份保持与声场匹配的复杂场景。
数据集最近研究
最新研究方向
Env-TTS-Clean数据集代表了环境感知文本到语音合成领域的重大进展,其核心价值在于构建了规模宏大、结构精密的声学场景与说话人身份联合建模训练语料。该数据集开创性地融合了多源会议语音(AMI、AliMeeting)与受控朗读语音(DDS/DAPS),通过精心设计的四通道并行音频对(环境、说话人、增强参考及目标语音),为解决真实场景中语音合成面临的噪声鲁棒性与个体音色保真度这一根本矛盾提供了宝贵资源。基于MossFormer2增强与Qwen3-ASR标注的技术路线,该语料库为探索解耦化声学环境迁移、零样本语音克隆以及多说话人多场景自适应合成等前沿热点奠定了数据基石,推动了语音交互系统向更高层次的环境智能化演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

