
stefanocarrera/autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.25_g4_run2
收藏数据链接:
官方服务:
资源简介:
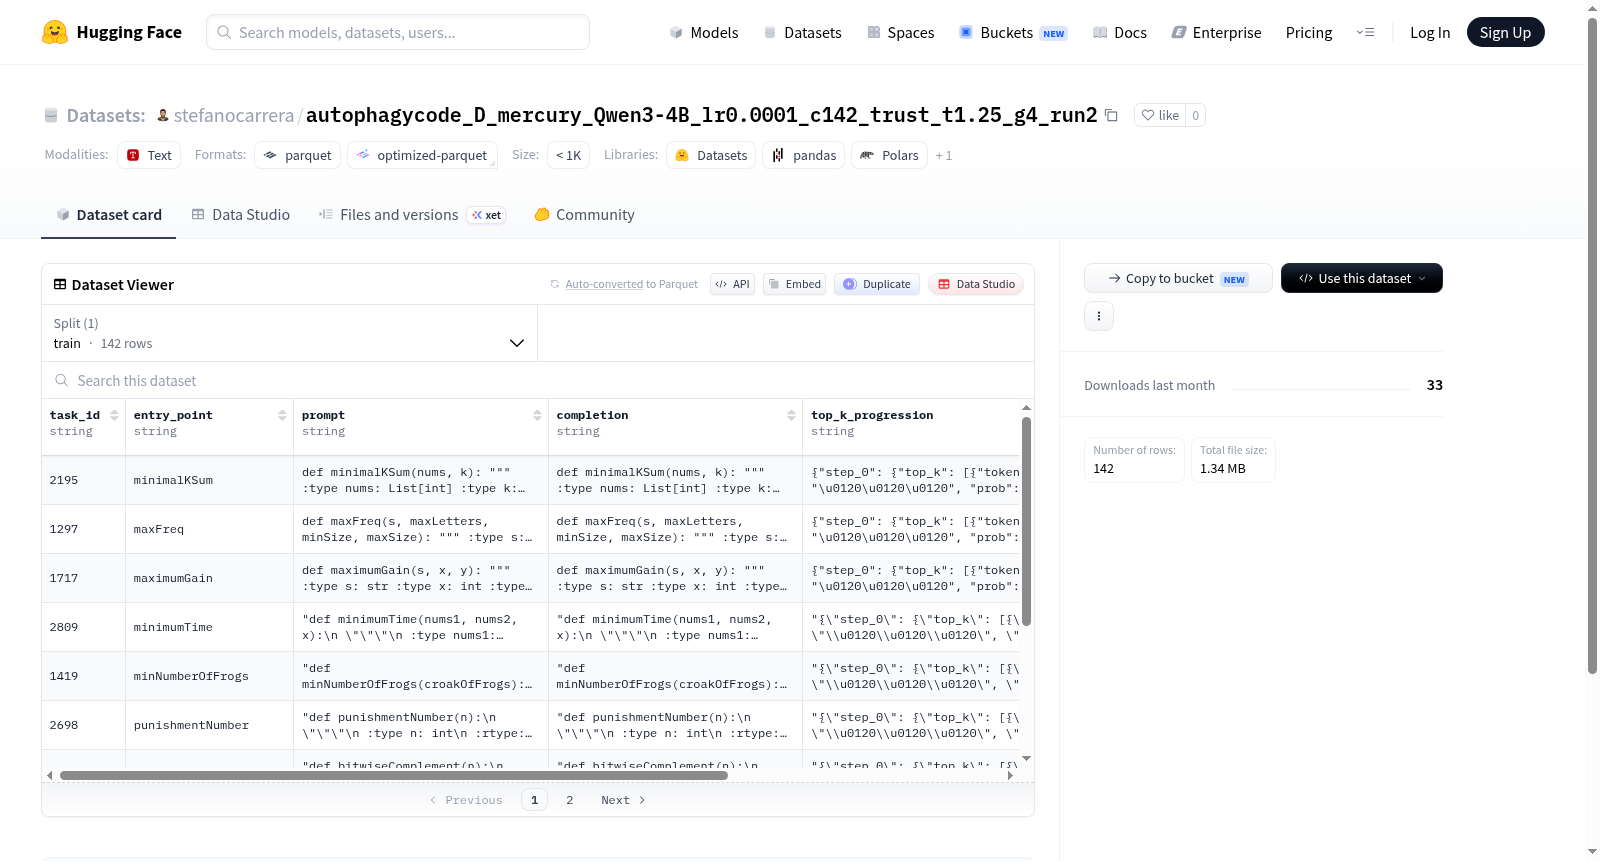
--- dataset_info: features: - name: task_id dtype: string - name: entry_point dtype: string - name: prompt dtype: string - name: completion dtype: string - name: top_k_progression dtype: string - name: test dtype: string splits: - name: train num_bytes: 5121756 num_examples: 142 download_size: 1334288 dataset_size: 5121756 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集以自噬相关编码任务为背景,基于Qwen3-4B模型在特定超参数配置下构建。通过设置学习率0.0001、信任阈值1.25及生成轮数4等参数,对142个代码任务实例进行采样与优化,最终生成包含任务ID、入口点、提示、补全、Top-K进展及测试字段的结构化数据,以JSON格式存储于训练集中。
特点
数据集专注于代码生成与补全领域,融合了多粒度推理过程(Top-K进展)与标准测试用例,兼具训练与评估双重属性。其规模精巧(142条样本),适合快速迭代验证;字段设计兼顾任务标识、代码上下文与生成轨迹,为自噬生物学相关的算法开发提供了可追溯的中间状态记录。
使用方法
用户可通过HuggingFace数据集库加载config名称为'default'的配置,并指定split为'train'来获取数据。每条样本包含任务提示与标准补全,可直接用于监督微调;Top-K进展字段支持对模型生成路径进行分析,测试字段则适用于评估模型在特定代码任务上的精准度,适用于代码智能与生物信息学交叉研究。
背景与挑战
背景概述
该数据集名为autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.25_g4_run2,由研究人员或机构基于Qwen3-4B模型,通过特定超参数配置(学习率0.0001、信任阈值1.25、生成轮次4)生成,旨在探索大语言模型在代码生成任务中的自我修正与迭代优化能力。数据集包含142个训练样本,每个样本由任务标识、入口点、提示、补全内容、顶层进展序列及测试用例构成,聚焦于模型如何通过内部反馈机制逐步改进输出代码。其研究核心在于利用“自噬”或自我进化范式,解决代码生成中多步推理与错误纠正的难题,为提升大语言模型在编程领域的自主性与鲁棒性提供实验基础,对代码智能与模型自我优化方向具有潜在推动作用。
当前挑战
该数据集所面对的领域挑战在于代码生成任务中模型依赖单次输出而缺乏纠错机制,导致生成的代码在复杂逻辑或边界条件下容易产生语法错误或语义偏差,需要模型具备多步推理与自我修正能力。构建过程中,挑战包括如何设计合理的信任阈值与生成轮次以平衡探索与利用,确保模型在有限样本(142个)下有效学习修正策略;同时,依赖单一模型(Qwen3-4B)可能引入偏见,且缺乏外部验证集,需谨慎评估数据集的泛化性与过拟合风险。
常用场景
经典使用场景
autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.25_g4_run2 数据集专为代码生成与自动补全任务设计,尤其在细粒度代码补全场景中表现卓越。其核心用途在于训练语言模型根据给定的代码片段(prompt)生成语义完整、语法正确的后续代码(completion),同时记录模型在生成过程中的top-k逐步推进信息(top_k_progression)。该数据集特别适用于需要高精度代码续写的场景,如函数内部逻辑补全、条件分支填充或循环结构自动生成,为模型在局部代码上下文中捕捉编程语义提供了天然的训练素材。
解决学术问题
该数据集有效解决了代码生成领域中模型对局部代码上下文理解不足的关键学术问题。传统代码生成任务常因缺乏细粒度逐步推理信息而陷入全局模式匹配,难以应对复杂控制流与数据依赖。通过引入top_k_progression字段,该数据集记录了模型在生成每一步时的候选分布,为研究代码生成中的逐步决策机制与置信度校准提供了数据支撑,推动了对代码语义空间内渐进式推断能力的深入理解。此外,其有限的样本量(142例)反而激励研究人员探索小样本学习、数据增强及知识蒸馏等高效训练范式,对低资源场景下的代码模型优化具有显著启发意义。
衍生相关工作
基于该数据集的特性,衍生出一系列值得关注的工作方向。例如,研究者可将其作为基准,对比不同规模模型(如Qwen3-4B与更大参数量模型)在逐步代码补全任务上的性能差异,探索模型容量与推理深度的关系。top_k_progression的引入激发了针对代码生成中的置信度校准研究,催生了基于信任阈值的拒绝采样策略(如trust_t1.25参数所暗示)。此外,该数据集与代码表示学习、对比预训练及代码结构感知的注意力机制等方向结合,有望推动代码智能中可解释性与可控性的前沿探索。
以上内容由遇见数据集搜集并总结生成


