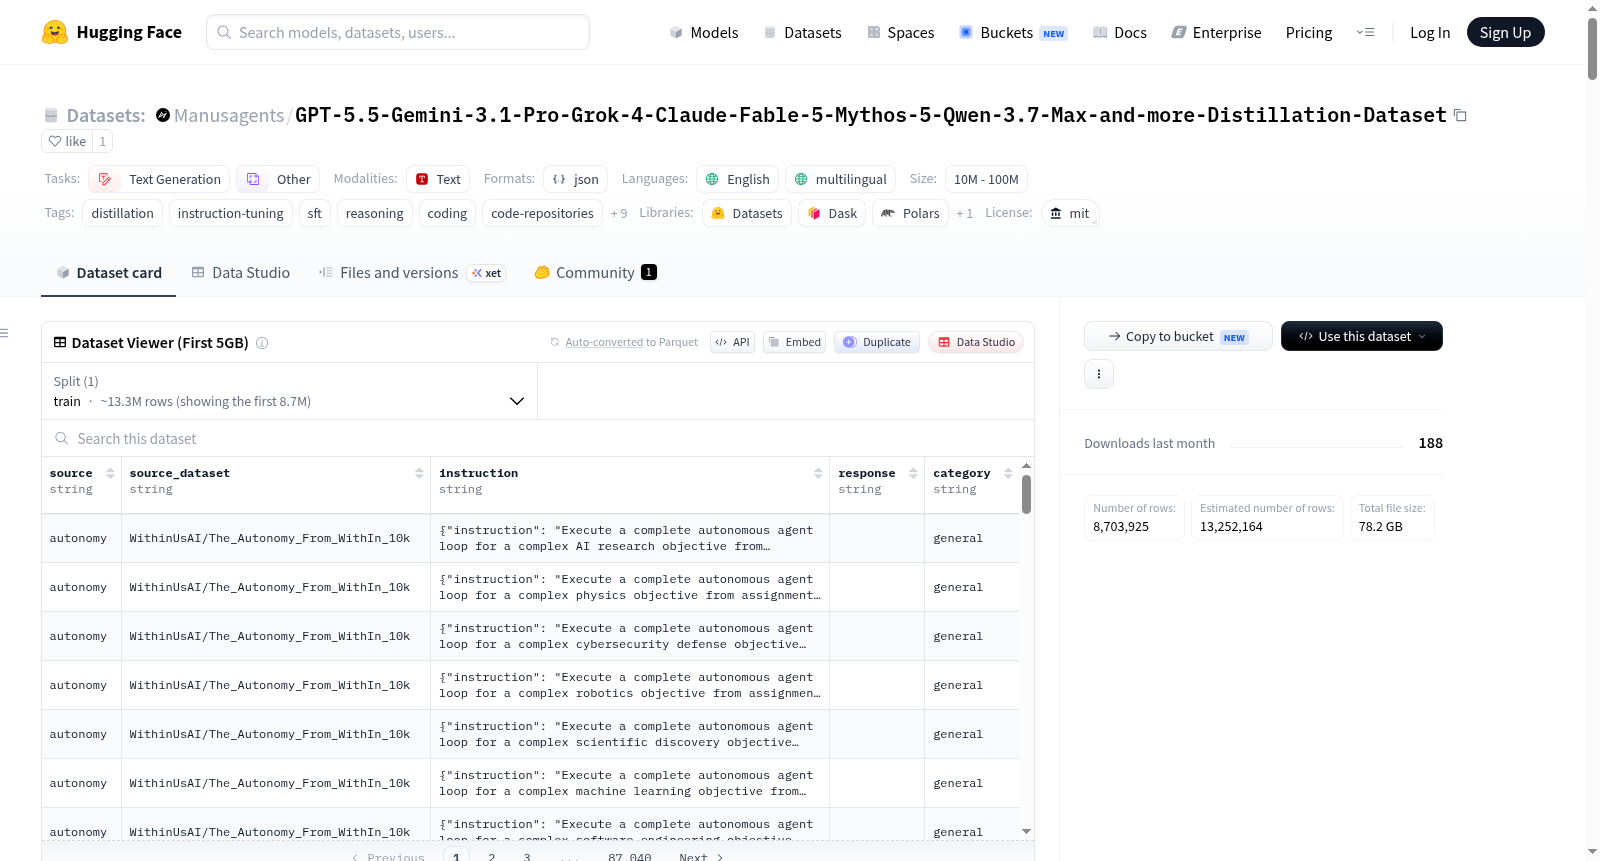
GPT-5.5-Gemini-3.1-Pro-Grok-4-Claude-Fable-5-Mythos-5-Qwen-3.7-Max-and-more-Distillation-Dataset
收藏资源简介:
The Open Distillation Codex 是一个大规模、统一格式的开源数据集集合,整合了来自49个上游数据集的20,617,503个样本,总大小约14GB,分为106个分片。该数据集旨在为人工智能模型训练提供一个单一、标准化的数据流,特别专注于代码生成、推理蒸馏和指令微调任务。数据集内容涵盖六个主要类别:1) 智能编码轨迹(约11.4M样本):来自前沿编码智能体的真实会话记录,呈现为指令/响应对;2) 蒸馏推理轨迹(约2.7M样本):来自WithinUsAI Mythos系列的模型蒸馏数据,覆盖量子化学到超自然哲学等29个学科;3) 代码仓库库(475,467个样本):完整提取了7,090个GitHub仓库的每个文件,每个文件作为一个样本,其中instruction字段为文件路径,response字段为文件内容;4) 前沿数学与证明(27,503个样本):DeepSeek Prover-V1的形式化定理证明轨迹;5) 智能体SFT(159,972个样本):来自Nexlab Fable-5 SFT发布的精心策划的多轮智能体轨迹;6) 经典公共指令(约47K样本):包括OpenAssistant、Databricks Dolly等公共指令数据集。所有数据都遵循统一的五字段JSONL格式:source(上游数据集短标识)、source_dataset(完整HuggingFace仓库ID)、instruction(用户端内容,如提示、问题或文件路径,≤4000字符)、response(助手端内容,如回答、完成或文件内容,≤4000字符)、category(自由形式类别标签,通常为general或code)。数据集支持流式加载,便于大规模处理。该数据集适用于多种人工智能任务,包括但不限于:代码补全预训练、代码生成、跨文件依赖学习、工具使用SFT、智能体文件编辑训练、知识蒸馏、指令微调、推理能力训练和存储库级上下文训练。数据集整体采用MIT许可证,但每个上游样本保留其原始许可证,可通过source_dataset字段追溯。
The Open Distillation Codex is a large-scale, uniformly formatted open-source dataset collection that integrates 20,617,503 samples from 49 upstream datasets, with a total size of approximately 14 GB and split into 106 shards. This dataset aims to provide a single, standardized data stream for artificial intelligence model training, with a particular focus on code generation, reasoning distillation, and instruction fine-tuning tasks. The dataset content covers six main categories: 1) Intelligent Coding Trajectories (~11.4M samples): Real conversation logs from cutting-edge coding AI Agents, formatted as instruction-response pairs; 2) Distilled Reasoning Trajectories (~2.7M samples): Model distillation data from the WithinUsAI Mythos series, covering 29 disciplines ranging from quantum chemistry to supernatural philosophy; 3) Code Repositories (475,467 samples): Each file from 7,090 complete GitHub repositories is fully extracted as an individual sample, where the `instruction` field stores the file path, and the `response` field stores the file content; 4) Cutting-edge Mathematics and Proofs (27,503 samples): Formal theorem proving trajectories from DeepSeek Prover-V1; 5) AI Agent SFT (159,972 samples): Curated multi-turn AI Agent trajectories released by Nexlab Fable-5 SFT; 6) Classic Public Instruction Datasets (~47K samples): Includes public instruction datasets such as OpenAssistant, Databricks Dolly, and others. All data adheres to a unified five-field JSONL format: `source` (short identifier for the upstream dataset), `source_dataset` (full HuggingFace repository ID), `instruction` (user-side content such as prompts, questions, or file paths, with a maximum length of 4000 characters), `response` (assistant-side content such as answers, completions, or file contents, with a maximum length of 4000 characters), and `category` (free-form category label, typically `general` or `code`). The dataset supports streaming loading to facilitate large-scale processing. It is applicable to a wide range of artificial intelligence tasks, including but not limited to: code completion pre-training, code generation, cross-file dependency learning, tool use SFT, AI Agent file editing training, knowledge distillation, instruction fine-tuning, reasoning capability training, and repository-level contextual training. The entire dataset is licensed under the MIT License, while each upstream sample retains its original license, which can be traced via the `source_dataset` field.
数据集概述
数据集名称:The Open Distillation Codex
版本:v5.0
许可证:MIT(集合许可证,各上游数据集保留其原始许可证)
语言:英语及多语言
任务类别:文本生成、其他
数据集大小:约 74 GB,包含 20,679,506 个样本
配置:默认配置,仅训练集(数据文件路径:data/train-*.jsonl)
一、架构与规模
该数据集采用双层架构:
- A 层(
data/目录):约 14 GB,包含 20,679,506 个样本,分布在 107 个 JSONL 分片(每片约 200,000 个样本),采用统一的五字段格式,可直接用于训练。 - B 层(
archives/目录):约 60 GB,包含 7,090 个原始.tar.gz归档文件,源自notune/fable5-repos,每个归档是一个完整的 GitHub 仓库快照,保留完整的仓库结构、二进制文件和未截断的文件内容(A 层每个文件内容上限为 4 KB)。
二、数据字段与模式
每个样本包含五个字段:
| 字段 | 类型 | 说明 |
|---|---|---|
source |
字符串 | 上游数据集的简短标识符 |
source_dataset |
字符串 | 上游数据集的 Hugging Face 完整仓库 ID |
instruction |
字符串(≤ 4,000 字符) | 用户侧内容(提示、问题或文件路径) |
response |
字符串(≤ 4,000 字符) | 助手侧内容(完成、回答或文件内容) |
category |
字符串(≤ 200 字符) | 自由分类标签(如 general、code) |
三、数据内容分布(A 层)
该数据集整合了 51 个开源数据集,主要分为以下几类:
1. 智能体编码轨迹(约 1140 万样本)
vibe_instruct_v2(CodeDevX/Vibe-Coding-Instruct-V2):8,152,510 个样本fable5_2m(Crownelius/Complete-FABLE.5-traces-2M):2,406,487 个样本vibe_instruct_v1(CodeDevX/Vibe-Coding-Instruct):1,100,000 个样本vibe_coding(attentionAllYouNeed/Vibe-Coding-Claude-Fable-5):1,100,000 个样本
2. 蒸馏推理轨迹(约 270 万样本)
- Royal Ghost & Citation 系列:约 2,683,513 个样本
- 29 个 WithinUsAI 25K 主题(涵盖数学、物理、化学、生物、医学、计算机科学、机器人、纳米技术、材料、地球气候等):约 725,000 个样本
- 前沿模型蒸馏(Claude、Gemini、Grok、GPT-5.5):约 178,000 个样本
- Coder 系列(Genesis、GOD、Omega、Legend、HyperScholar):约 150,000 个样本
3. 代码仓库库(475,467 个样本)
来自 notune/fable5-repos 的所有 7,090 个仓库,每个文件对应一个样本(instruction 为 <仓库名>/<路径>,response 为文件内容,上限 4 KB)。
4. 经典指令数据集(约 67,000 个样本)
alpaca(tatsu-lab/alpaca):52,002 个样本oasst(OpenAssistant/oasst1):32,141 个样本dolly(databricks/databricks-dolly-15k):15,011 个样本
5. 数学与证明 + 智能体 SFT
deepseek_prover_v1(deepseek-ai/DeepSeek-Prover-V1):27,503 个样本fable5_agentic_sft(Nexlab/fable5-agentic-coding-sft):159,972 个样本
四、部分上游数据集清单
以下为部分主要来源(共 51 个):
| 序号 | 来源标识符 | 上游数据集 | 样本数 |
|---|---|---|---|
| 1 | vibe_instruct_v2 |
CodeDevX/Vibe-Coding-Instruct-V2 |
8,152,510 |
| 2 | fable5_2m |
Crownelius/Complete-FABLE.5-traces-2M |
2,406,487 |
| 3 | vibe_instruct_v1 |
CodeDevX/Vibe-Coding-Instruct |
1,100,000 |
| 4 | vibe_coding |
attentionAllYouNeed/Vibe-Coding-Claude-Fable-5 |
1,100,000 |
| 5 | royal_ghost_1m |
WithinUsAI/Royal_Ghost_Coder_1M |
1,000,000 |
| 6 | citation_ground |
WithinUsAI/CitationGround-1M |
980,064 |
| 7 | royal_ghost_501k |
WithinUsAI/Royal_Ghost_Coder_501k |
703,449 |
| 8 | fable5_repos_full |
notune/fable5-repos |
475,467 |
| 9 | fable5_agentic_sft |
Nexlab/fable5-agentic-coding-sft |
159,972 |
| 10 | alpaca |
tatsu-lab/alpaca |
52,002 |
| 11 | alpca_gpt55 |
GabrielFreeze-2/alpca-mlt-gpt-5.5_chatml |
49,099 |
| 12 | oasst |
OpenAssistant/oasst1 |
32,141 |
| 13 | deepseek_prover_v1 |
deepseek-ai/DeepSeek-Prover-V1 |
27,503 |
| 14 | dolly |
databricks/databricks-dolly-15k |
15,011 |
| 15 | gpt55_distilled |
WithinUsAI/GPT_5.5_Distilled |
18,197 |
| 16 | kimi_coding |
trjxter/Kimi-K2.7-CodingTraces-9000x |
9,014 |
| 17–46 | 30 × WithinUsAI 25K 主题 | 多个 | 约 750,000 |
| 47–51 | Genesis 及 Coder 变体 | WithinUsAI/Genesis_AI_Code_* 等 |
约 75,000 |
五、未纳入的数据集
部分上游数据集因源数据本身格式问题未能纳入:
WithinUsAI/P_P_GHOST_1Million:仓库无支持的数据文件WithinUsAI/HyperScholar-OmniPython-50K:仓库无支持的数据文件WithinUsAI/GPT-2-to-GPT-5-5k:缺少训练文件Glint-Research/Fable-5-traces:模式转换错误(嵌套结构不匹配)WithinUsAI/Genesis_v1_1_Update_Instruct_Thinking_Reasoning:模式转换错误(仅部分恢复)WithinUsAI/Sports_25k、Human_25k、All_Known_Species_Index_25k:pyarrow.list_()调用错误WithinUsAI/GOD_Coder_100k、python_GOD_coder_100k、Elite_GOD_Coder_100k、Omega_Genesis_Coder_100k:上游数据 JSON 格式错误(仅部分恢复)
六、版本历史
| 版本 | 日期 | 说明 |
|---|---|---|
| v1.0 | 2026-07-01 | 初始发布,117K 样本 |
| v2.0 | 2026-07-02 | 145 万样本,57 个来源 |
| v3.0 | 2026-07-03 | 1060 万样本,44 个来源完整摄入 |
| v3.1 | 2026-07-04 | 新增 5 个用户请求的数据集,2010 万样本 |
| v4.0 | 2026-07-05 | fable5-repos 完整提取(7,090 个归档) |
| v5.0 | 2026-07-05 | 新增 B 层(7,090 个原始 tar.gz 归档,约 60 GB),恢复部分数据集,双层架构 |
七、引用信息
bibtex @misc{open_distillation_codex_2026, title = {The Open Distillation Codex: 20.7M unified samples + 7,090 raw code repositories from 51 open-source datasets}, author = {Manusagents}, year = {2026}, url = {https://huggingface.co/datasets/Manusagents/GPT-5.5-Gemini-3.1-Pro-Grok-4-Claude-Fable-5-Mythos-5-Qwen-3.7-Max-and-more-Distillation-Dataset}, note = {v5.0 — 107 JSONL shards + 7090 archive files, 20,679,506 samples, ~74 GB} }