
遇见数据集

fetch_huggingface_terminal_9123_89cwuq_published_review_summaries

收藏
Hugging Face2026-08-24 更新2026-08-25 收录
官方服务:

资源简介:

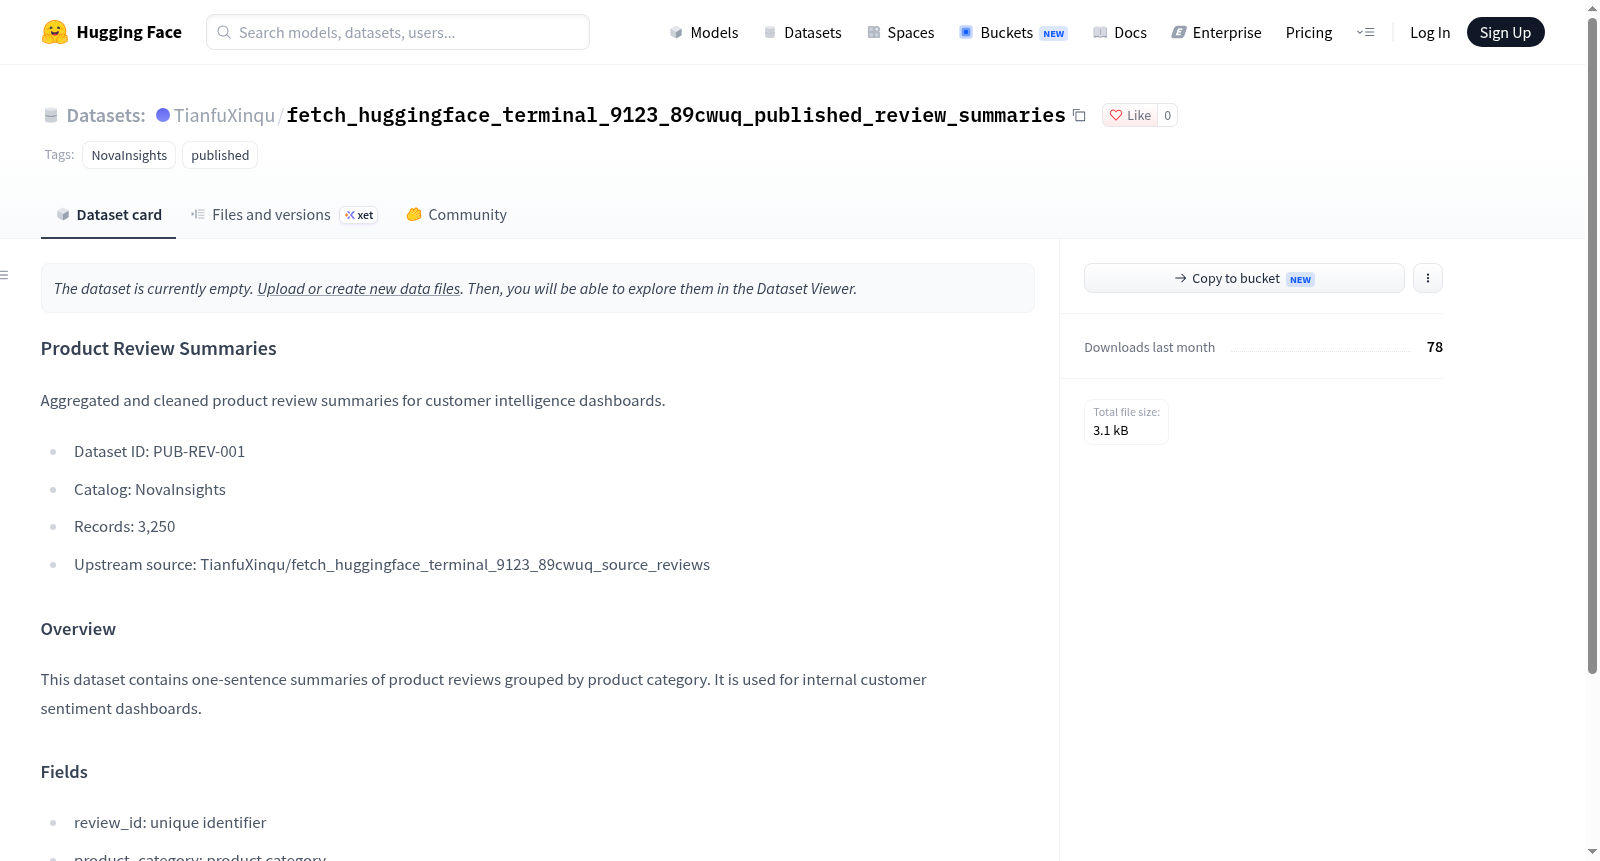
该数据集名为Product Review Summaries,属于NovaInsights目录,数据集ID为PUB-REV-001。它包含3250条记录,每条记录由产品评论的单句摘要构成,并按产品类别进行分组。数据来源于上游数据集TianfuXinqu/fetch_huggingface_terminal_9123_89cwuq_source_reviews。该数据集主要用于内部客户情感分析仪表板,帮助分析不同产品类别下的客户反馈。字段包括:review_id(唯一标识符)、product_category(产品类别)、summary(评论的单句摘要)。

The dataset is named Product Review Summaries, under the NovaInsights catalog, with dataset ID PUB-REV-001. It contains 3250 records, each consisting of a single-sentence summary of a product review, grouped by product category. The data originates from the upstream dataset TianfuXinqu/fetch_huggingface_terminal_9123_89cwuq_source_reviews. This dataset is primarily used for internal customer sentiment analysis dashboards to help analyze customer feedback across different product categories. Fields include: review_id (unique identifier), product_category (product category), summary (single-sentence summary of the review).

创建时间:
2026-08-15
原始信息汇总

数据集概述

内容说明

该数据集包含按产品类别分组的单句产品评论摘要,主要用于内部客户情绪仪表板分析。

字段结构

  • review_id: 唯一标识符
  • product_category: 产品类别
  • summary: 评论的单句摘要

用途

适用于客户情报仪表板中的情感分析、趋势监控及产品类别层面的评论聚合展示。
搜集汇总
数据集介绍
fetch_huggingface_terminal_9123_89cwuq_published_review_summaries 数据集图片
构建方式
该数据集源于上游评论原始数据TianfuXinqu/fetch_huggingface_terminal_9123_89cwuq_source_reviews,经聚合与清洗流程后形成面向客户情报仪表盘的评论摘要集合,共收录3,250条记录。构建过程涵盖对原始评论文本的筛选与规范化处理,剔除噪声与冗余信息,并以产品类别为分组维度,为每条评论生成单句摘要,最终形成结构统一、字段明确的发布版本,以支持后续的客户情绪分析与洞察呈现。
使用方法
该数据集可用于内部客户情绪仪表盘的构建与维护,使用时可依据review_id进行记录定位,借助product_category实现按产品类别的分组统计与对比分析,并通过summary字段快速获取评论核心内容。结合NovaInsights目录体系与发布标签,使用者能够在客户情报分析流程中将其作为摘要级数据源,与上游评论数据配合使用,从而支持情绪监测、类别洞察与仪表盘展示等任务。
背景与挑战
背景概述
在客户体验经济勃兴与产品迭代周期急剧缩短的背景下,产品评论摘要成为企业感知市场脉动的关键触点。该数据集由NovaInsights团队于近年构建发布,隶属于PUB-REV-001目录,收录三千二百五十条经聚合清洗的产品评论单句摘要,上游数据源自TianfuXinqu/fetch_huggingface_terminal_9123_89cwuq_source_reviews。其核心研究问题在于如何将非结构化、多类别的客户反馈凝练为简洁摘要,以支撑内部客户情绪仪表盘的实时洞察。该数据集为产品情感分析、类别感知摘要生成及商业智能仪表盘研究提供了结构化基准,对推动客户智能领域的可复现研究具有基础性影响。
当前挑战
该数据集所面对的领域问题在于产品评论摘要需在极短文本内保留情感极性、产品属性与用户意图,对摘要生成模型的语义保真与类别泛化能力构成严峻考验。构建过程中,上游评论来源多样、口语化表达与噪声交织,需经聚合、清洗与单句压缩等多重工序,同时确保类别标签一致性与摘要忠实度。具体挑战涵盖:跨产品类别的语义偏移、单句摘要的信息压缩与情感守恒、小规模样本下的模型过拟合风险,以及内部仪表盘场景对摘要实时性与可解释性的双重约束。
常用场景
经典使用场景
在客户智能与产品反馈分析领域,该数据集最经典的使用场景在于为仪表板提供高效的情感与主题摘要。通过按产品类别聚合的评语单句摘要,研究者和分析师能够快速洞察不同品类下的用户核心关切,而无需逐条阅读冗长的原始评论。此类摘要数据通常被用于构建实时监控面板,辅助产品团队追踪口碑趋势并识别突发的体验问题。
解决学术问题
该数据集有效缓解了学术研究中评论文本冗余与标注成本高昂之间的张力。在情感分析和观点挖掘任务中,研究者常受限于原始评论的非结构化与噪声干扰,而经过清洗和摘要的短文本为模型训练提供了高质量监督信号。它使得跨品类情感迁移、摘要生成评估以及少样本意图识别等课题得以在可控规模下展开,推动了文本摘要与情感计算交叉领域的可复现研究。
实际应用
在实际业务中,该数据集直接服务于客户体验管理平台和产品运营决策。企业可利用这些按类别组织的摘要,自动生成周度或月度客户情绪报告,定位需要优先改进的产品线。同时,摘要内容可嵌入客服辅助系统,帮助一线人员迅速把握用户反馈要点。其结构化字段也为自动化告警和趋势预测模型提供了便捷的输入格式,降低了从原始评论到可执行洞察的转化门槛。
数据集最近研究
最新研究方向
在客户智能分析领域,产品评论摘要数据集正推动着情感计算与细粒度意见挖掘的深度融合。围绕该数据集的前沿探索集中于利用大语言模型生成可解释的摘要,并借助提示学习与对比学习提升跨品类情感极性迁移能力,以应对评论摘要中隐含的讽刺与多义词挑战。与此同时,基于该数据集的轻量化蒸馏模型研究成为热点,旨在平衡摘要质量与推理效率,为实时仪表盘部署提供支撑。此类研究不仅提升了客户体验洞察的自动化水平,也为电商平台优化产品策略和舆情监控提供了可复用的数据基准,对推动可解释情感分析在工业界的落地具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

