
遇见数据集

HebArabNlpProject/abstractive-qa-llm-eval

收藏
Hugging Face2026-07-19 更新2026-07-22 收录
官方服务:

资源简介:

一个希伯来语数据集,包含132个问答记录,用于测试语言模型的生成答案是否基于源文档而非产生幻觉。每个记录包含一个问题、源文本和一个参考答案,参考答案中的每个主张都有来自源文本的精确引用跨度支持。数据集旨在帮助用户评估自己的模型:生成答案后,将其分解为主张,并检查每个主张是否可追溯到源文档中的真实文本。数据集还包括类型分布(对话、百科全书式、新闻式)、难度级别(检索、简单、复杂)和人类注释者的质量评分,但注释者一致性较弱。数据集以JSON格式提供,字段包括id、源任务ID、类型、难度、文档ID、问题、源文本、参考答案、主张数组和人类评分数组。

A Hebrew-language dataset of 132 question-answer records, built for testing whether a language models generated answer is grounded in its source document rather than hallucinated. Each record has a question, a source_text, and a reference_answer whose individual claims are each backed by exact quoted spans from source_text. Use it to check your own model the same way: generate an answer, break it into claims, and see whether each claim traces back to real text in the source. The dataset includes genre distribution (dialogue, encyclopedic, journalistic), difficulty levels (retrieval, simple, complex), and human ratings with weak annotator agreement. It is provided in JSON format with fields such as id, source_task_id, genre, difficulty, document_id, question, source_text, reference_answer, claims array, and human_ratings array.
提供机构:
HebArabNlpProject
搜集汇总
数据集介绍
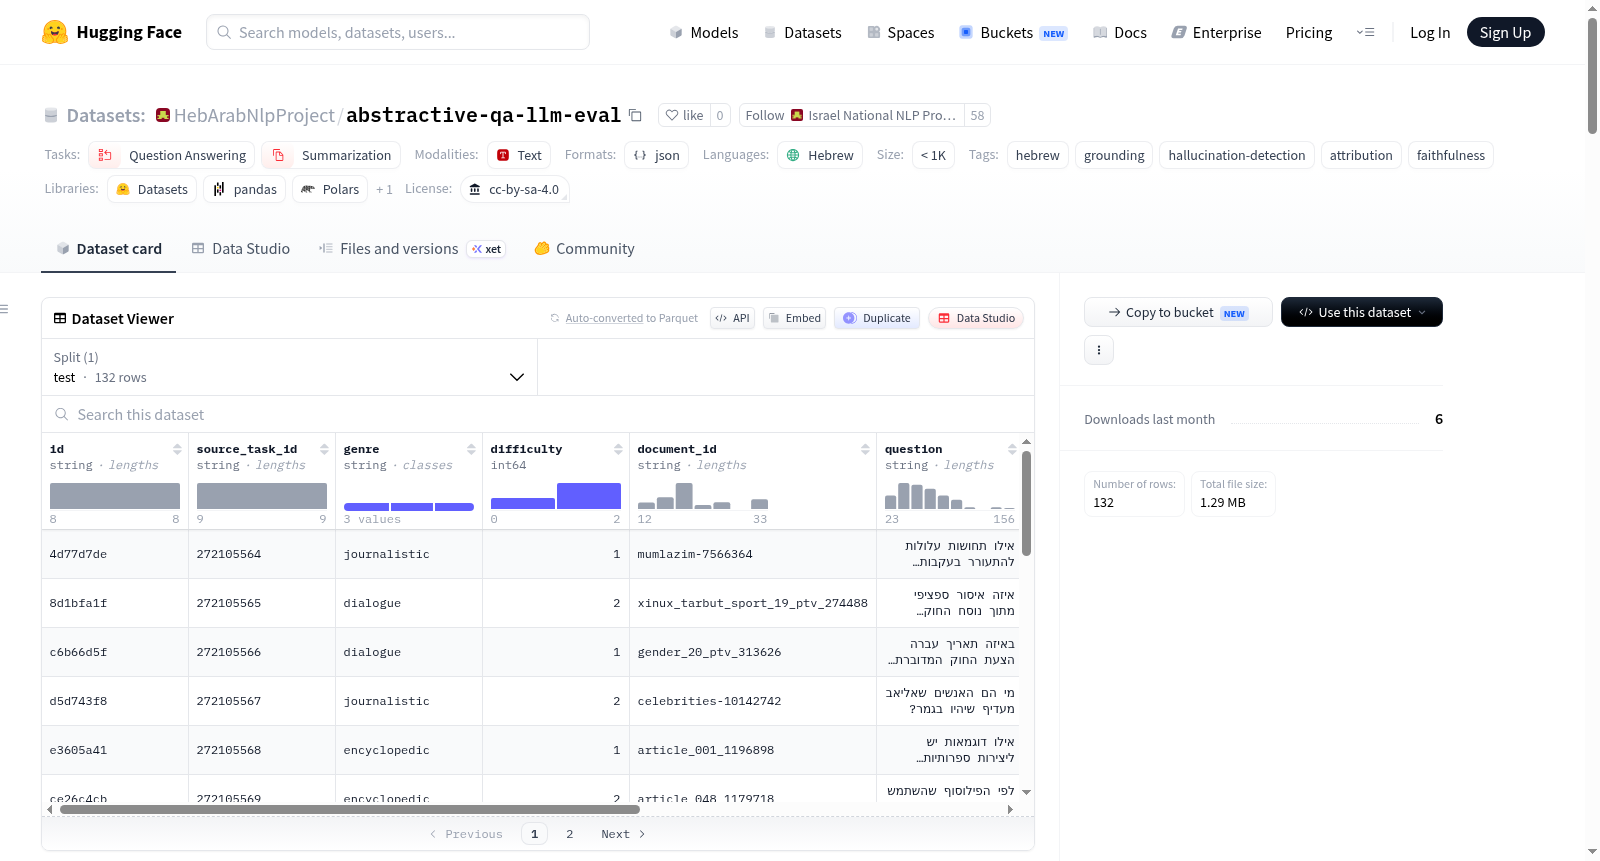
HebArabNlpProject/abstractive-qa-llm-eval 数据集图片
构建方式
该数据集专为评估大语言模型在希伯来语环境下的抽象问答能力而构建,聚焦于检验生成答案是否忠实于源文档。构建过程基于132条精心设计的问题-答案记录,每条记录包含问题、源文本及参考答案。参考答案被细分为句子级别的声明(claims),每个声明均配有源自源文本的精确引用片段(attribution spans),并标注了字符级起始与结束位置。所有引用片段均经过验证,确保与源文本字符完全一致。数据集涵盖对话、百科和新闻三种文本体裁,并设置了检索、简单和复杂三级难度,以实现对模型性能的全面评估。
特点
该数据集的核心特色在于其细粒度的归因机制,能够有效检测模型生成的幻觉和归因错误。每条参考答案被拆分为多个声明,每个声明对应一个或多个从源文本精确截取的引用片段,从而为模型输出的忠诚度评估提供了可量化的基准。此外,数据集还收录了四位人工标注者对每条记录在连贯性、相关性、完整性、忠实性和归因五个维度上的评分(0-2分制),为研究者提供了多维度的参考标准。尽管标注者间的完美一致性达到37.9%,但Krippendorff's alpha值显示各维度的一致性较弱,提示在使用评分数据时需谨慎。
使用方法
使用时,研究者可加载包含132条记录的JSON数组,通过遍历每条记录的问题和源文本来评测模型。具体流程为:让模型基于源文本生成答案,然后将模型输出拆解为独立的声明,并为每个声明在源文本中查找匹配的字符级引用片段。若某一声明无法在源文本中找到确凿支持,则可能为模型幻觉。该数据集还提供了标准的Python加载示例,支持直接按索引访问记录中的各个字段,包括问题和参考答案。然而,由于人工评分的一致性有限,建议将评分数据作为辅助参考,而非绝对的真理标准。
背景与挑战
背景概述
抽象问答(Abstractive QA)作为自然语言处理领域的前沿方向,旨在评估模型从给定文档中生成忠实摘要式回答的能力。该数据集发布于2024年,由以色列研究团队构建,聚焦于希伯来语这一低资源语言,核心研究问题在于如何系统性地检测大语言模型在生成式问答中的幻觉现象。数据集通过对132条问答记录中的244个声明进行细致标注,每个声明均与源文本中的精确片段形成映射,为评估模型输出的忠实性提供了可量化的基准。这一工作不仅填补了希伯来语在可控性生成评估领域的空白,更通过开放式的声明级归因框架,推动了多语言环境下幻觉检测技术的发展。
当前挑战
数据集所解决的领域问题是大语言模型在生成式问答中的事实忠实性评估,传统方法难以细粒度区分模型输出的真实与幻觉部分。构建过程中面临多重挑战:首先,希伯来语复杂的形态句法特征使得声明切分与跨句子归因标注极为困难;其次,286个归因片段的字符级精确匹配要求标注者具备极高的一致性,而实际标注者间的Krippendorff's alpha值仅为0.348,远低于0.667的可靠阈值,说明评分标准主观性显著;此外,数据集规模仅132条,虽能支持初步验证,但较难覆盖问答任务中多样的语义漂移与知识边界情况,对泛化性的验证构成制约。
常用场景
经典使用场景
在自然语言处理领域,抽象式问答与摘要生成任务的核心挑战在于确保模型输出忠实于源文档,避免产生幻觉。该数据集专为评估语言模型在希伯来语环境下的生成内容是否基于源文本而设计。每个样本包含一个问题、一段源文本以及一个参考答案,参考答案被细化为多个声明性语句,每条声明均附有从源文本中精确截取的支持引文及其字符偏移。使用者可生成本模型答案后,将其拆解为声明,逐一检查每条声明能否在源文本中找到对应证据,从而量化模型的接地性与忠实度。这一结构化的评估范式为研究者提供了无需人工干预的自动化验证框架,尤其适合评估模型在复杂推理、跨句整合及事实一致性方面的表现。
衍生相关工作
该数据集衍生了一系列关于细粒度归因评估的研究工作。例如,有研究者基于其声明级标注设计出自动化的归因评分指标,通过对比模型生成声明的引用覆盖率与参考答案的一致性,建立忠诚度量化模型。另有工作将其作为基准,开发了旨在减少幻觉的对抗训练方法,通过最大化生成声明与源文本的证据匹配概率来优化模型。在模型解释性领域,该数据集被用作测试平台,验证注意力机制能否正确指向支持性源文本片段。还有研究团队将其扩展至多语言场景,构建了跨语种的归因评估框架,推动了全球化语言模型事实性保障的学术探索。
数据集最近研究
最新研究方向
该数据集聚焦于希伯来语环境下大语言模型生成答案的忠实性与归因能力评估,属于自然语言处理领域中抽象问答与幻觉检测的前沿研究方向。通过细粒度的声明级归因标注与人工评分体系,样本虽仅132条但覆盖对话、百科与新闻三类文本及复杂推理难度,为评估模型是否基于源文本进行回答提供了高精度的测试基准。结合近期业界对生成内容可信度与可靠性的强烈关注,该数据集在希伯来语的高资源与低资源语料边界之间填补了关键空白,其公开的归因验证机制与标注者间一致性数据的披露,为推动多语言环境下可解释、可归因的文本生成系统发展具有重要参考意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

