
遇见数据集

OpenVoiceOS/ovos-intent-template-bench-intents-for-eval

收藏
Hugging Face2026-06-11 更新2026-06-14 收录
官方服务:

资源简介:

该数据集是OVOS意图模板基准的预测数据集,专门用于评估意图分类模型。它基于OpenVoiceOS/intents-for-eval数据集,包含了OVOS Plugin Arena中模板范式意图联盟竞争者的每个样本预测结果。数据集按语言分割(如加泰罗尼亚语、丹麦语、德语、英语等),每个分割下提供JSONL文件,存储了竞争者的预测数据。这些数据遵循竞技场的标准合同,包括固定的数据集版本、插件版本、管道阶段以及精确匹配指标。数据集通过可复现的基准脚本生成,用于创建基准板、盲战池和基于基准的ELO阶梯。该项目由NGI0 Commons Fund和NLnet资助。

This dataset contains per-sample predictions for the template-paradigm intent league fighters of the OVOS Plugin Arena, based on the OpenVoiceOS/intents-for-eval dataset. It is designed for benchmarking intent classification models. The data is split by language (e.g., Catalan, Danish, German, English, etc.), with JSONL files for each competitor under predictions/<lang>/. Rows adhere to the arenas contract, including pinned dataset revision, plugin version, pipeline stage, and exact match metrics. Generated via a reproducible benchmark script, it supports the creation of benchmark boards, blind battle pools, and an ELO ladder. Funded by the NGI0 Commons Fund and NLnet.
提供机构:
OpenVoiceOS
搜集汇总
数据集介绍
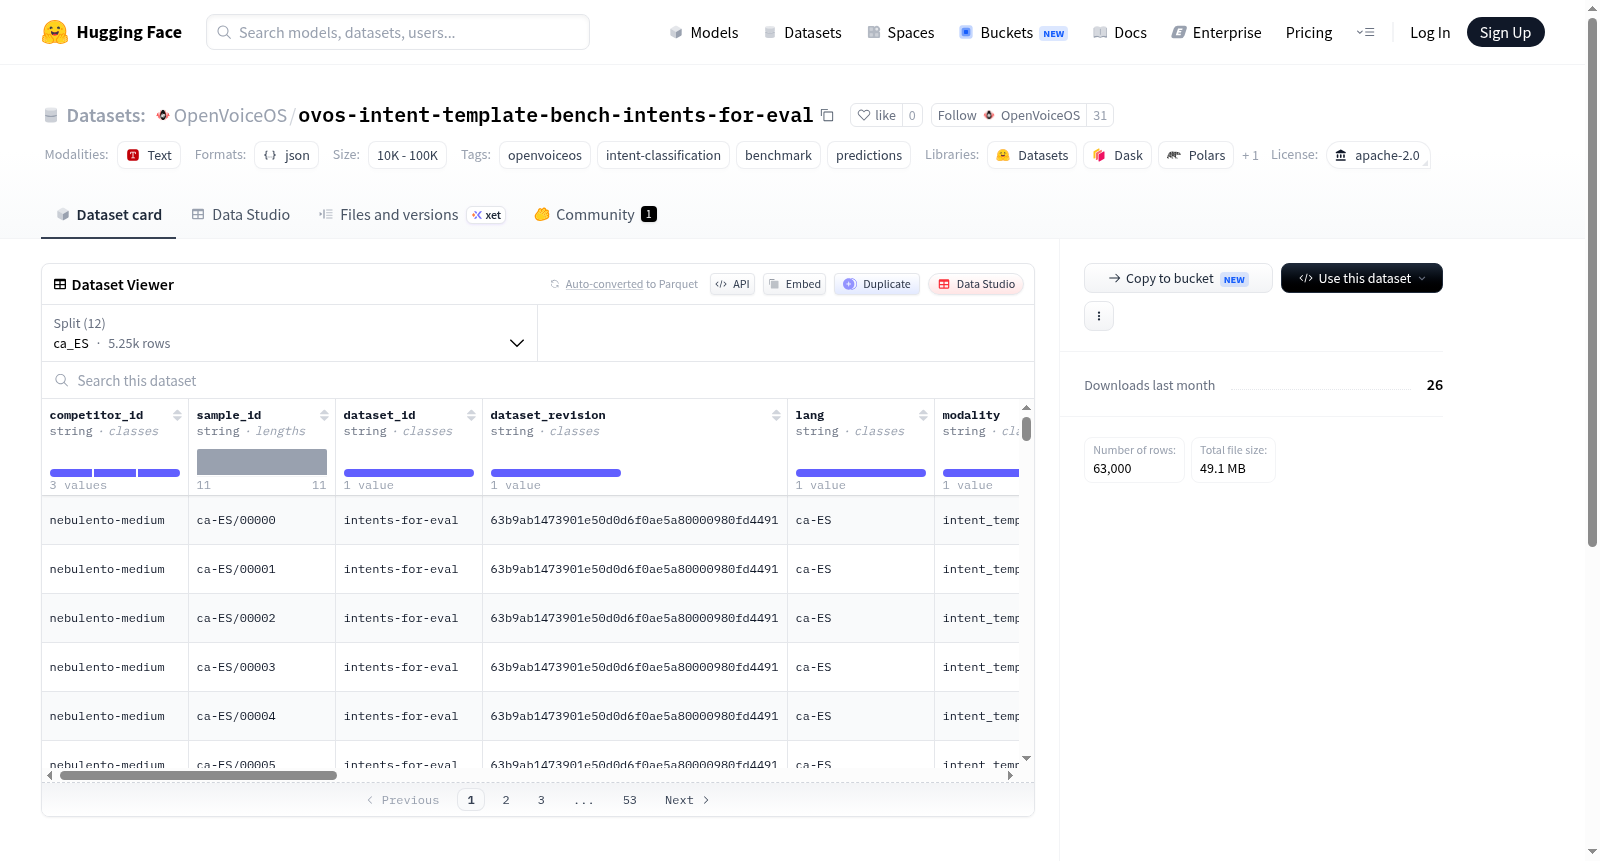
OpenVoiceOS/ovos-intent-template-bench-intents-for-eval 数据集图片
构建方式
本数据集基于OpenVoiceOS生态下的意图模板基准测试构建,汇集了OVOS Plugin Arena中多种模板范式意图分类竞争者的逐样本预测结果。数据来源覆盖加泰罗尼亚语、丹麦语、德语、英语、西班牙语、巴斯克语、法语、加利西亚语、意大利语、荷兰语、巴西葡萄牙语和葡萄牙语共12种语言的评测语料,每种语言作为一个独立的数据集划分。每个竞争者的预测结果以JSONL格式存储,按语言归类于相应的子目录下,文件名由竞争者标识符与语言代码共同构成。数据集的构建遵循了Arena协议第3.2节规定的格式要求,确保了数据集修订版本、插件版本、触发阶段以及精确匹配等字段的完整性与一致性,所有数据均通过可复现的基准测试脚本自动生成。
特点
该数据集的核心特质在于其多语言覆盖能力与标准化评估框架的结合。数据集为每种语言独立划分,支持细粒度的跨语言意图分类性能分析。每条记录严格遵循Arena协议规范,包含数据集修订版本、插件版本、处理阶段标注及精确匹配结果等关键字段,特别针对开放域词汇(OOD)的正误判断提供了明确语义支持。数据集的生成过程完全可复现,其内容直接服务于Arena工作流的基准排行榜构建、盲法对抗池生成及基于基准的ELO等级分排名,为OpenVoiceOS生态中的意图分类系统提供了统一的性能评估基石。
使用方法
研究者可通过HuggingFace Datasets库直接加载本数据集,指定所需的语言划分后即可获取对应语种下各竞争者的预测记录。每条数据记录均包含符合Arena协议的结构化字段,可直接用于对比不同意图分类算法在同等条件下的表现。数据集特别适合进行跨语言意图分类模型的性能基准测试、模板范式与传统机器学习方法的对比分析,以及基于ELO评分系统的模型排名计算。使用者应注意,数据中的精确匹配字段已根据开放域词汇的正确语义进行了标准化处理,可直接作为评估指标的计算依据,无需额外清洗。
背景与挑战
背景概述
OVOS意图模板基准评估数据集(ovos-intent-template-bench-intents-for-eval)诞生于开放语音操作系统(OpenVoiceOS)生态系统的持续演进之中,由NLnet基金会及欧洲下一代互联网计划资助,旨在系统性地评估多语言意图分类模板范式的竞争模型。该数据集围绕OpenVoiceOS精心构建的intents-for-eval基准语料,通过重现性基准脚本生成每个竞争模型的多语言逐样本预测,覆盖加泰罗尼亚语、丹麦语、德语、英语等十余种语言。核心研究问题聚焦于模板范式下的多语言意图分类与领域外(OOD)样本检测,其创新之处在于采用标准化竞技场协议,为模型提供统一的评测维度与胜负判定机制。作为OpenVoiceOS插件竞技场的核心组件,该数据集推动了多语言意图分类模型的公平对比与迭代进步,对开放生态下的语音交互系统发展产生了显著影响。
当前挑战
该数据集所应对的领域挑战主要在于多语言意图分类任务中模板范式模型的评估困境,尤其是跨语言泛化能力与领域外样本准确识别之间的权衡。不同竞争模型在十余种语言上的表现差异巨大,且语义相似的意图在不同语言中可能对应截然不同的词汇和语法结构,为模型判别带来巨大挑战。构建过程中的技术挑战包括:确保每个预测结果严格遵循竞技场协议(如数据集版本锁定、插件版本追踪、处理阶段标记以及完全的精确匹配判定标准),这对脚本复现的一致性和流水线的鲁棒性提出极高要求。此外,多语言JSONL文件的统一管理、盲注对战池的公平调度以及基于benchmark的ELO等级分计算方法的设计与实现,均构成数据构建阶段的显著困难。
常用场景
经典使用场景
该数据集作为OpenVoiceOS生态中意图分类技术的基准测试核心,主要用于评估和比较不同语义解析插件在多语言环境下的意图识别性能。它涵盖加泰罗尼亚语、丹麦语、德语、英语、西班牙语等十余种语言,每个语种均包含独立的评测分片,研究者可借此系统性地测试自然语言理解系统在跨语言场景中的鲁棒性与泛化能力。数据集中的每条样本均严格遵循领域内标准化协议(如ARENA §3.2),记录了模型推理的全链路信息(包括数据集修订版本、插件版本、推理阶段及精确匹配指标),从而为意图分类任务的公正对比提供了可复现的量化基础。
衍生相关工作
该数据集衍生出的经典工作主要围绕OpenVoiceOS插件竞技场(Plugin Arena)展开,其中最为核心的是基于模板范式的意图分类竞赛体系以及ELO等级评定机制。研究者利用该数据集构建了盲法对战池(Blind Battle Pools),通过标准化评测脚本生成多维度排行榜,从而直观对比不同插件的精确匹配率与跨语言泛化能力。此外,该数据集还催生了针对意图分类置信度校准的研究,以及基于竞技场数据的动态模型融合策略探索,这些工作共同丰富了语音交互系统中意图理解模块的评估方法论与优化工具箱。
数据集最近研究
最新研究方向
该数据集聚焦于多语言意图分类与模板范式对话系统的评估基准构建,近期研究前沿集中在利用OpenVoiceOS生态下的插件竞技场(Plugin Arena)对跨语言意图识别模型进行标准化评测。通过引入涵盖加泰罗尼亚语、巴斯克语等低资源语种的预测数据,数据集为验证对话系统在多语言环境下的鲁棒性与泛化能力提供了关键资源。其与欧盟下一代互联网(NGI)计划资助的开放语音操作系统紧密关联,推动了开源社区在意图理解与任务型对话模型公平对抗性评估方面的方法论创新,对实现人机交互的跨语言无缝对接具有重要实践意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

