
honeray/ai-music-comments-1.5M
收藏官方服务:
资源简介:
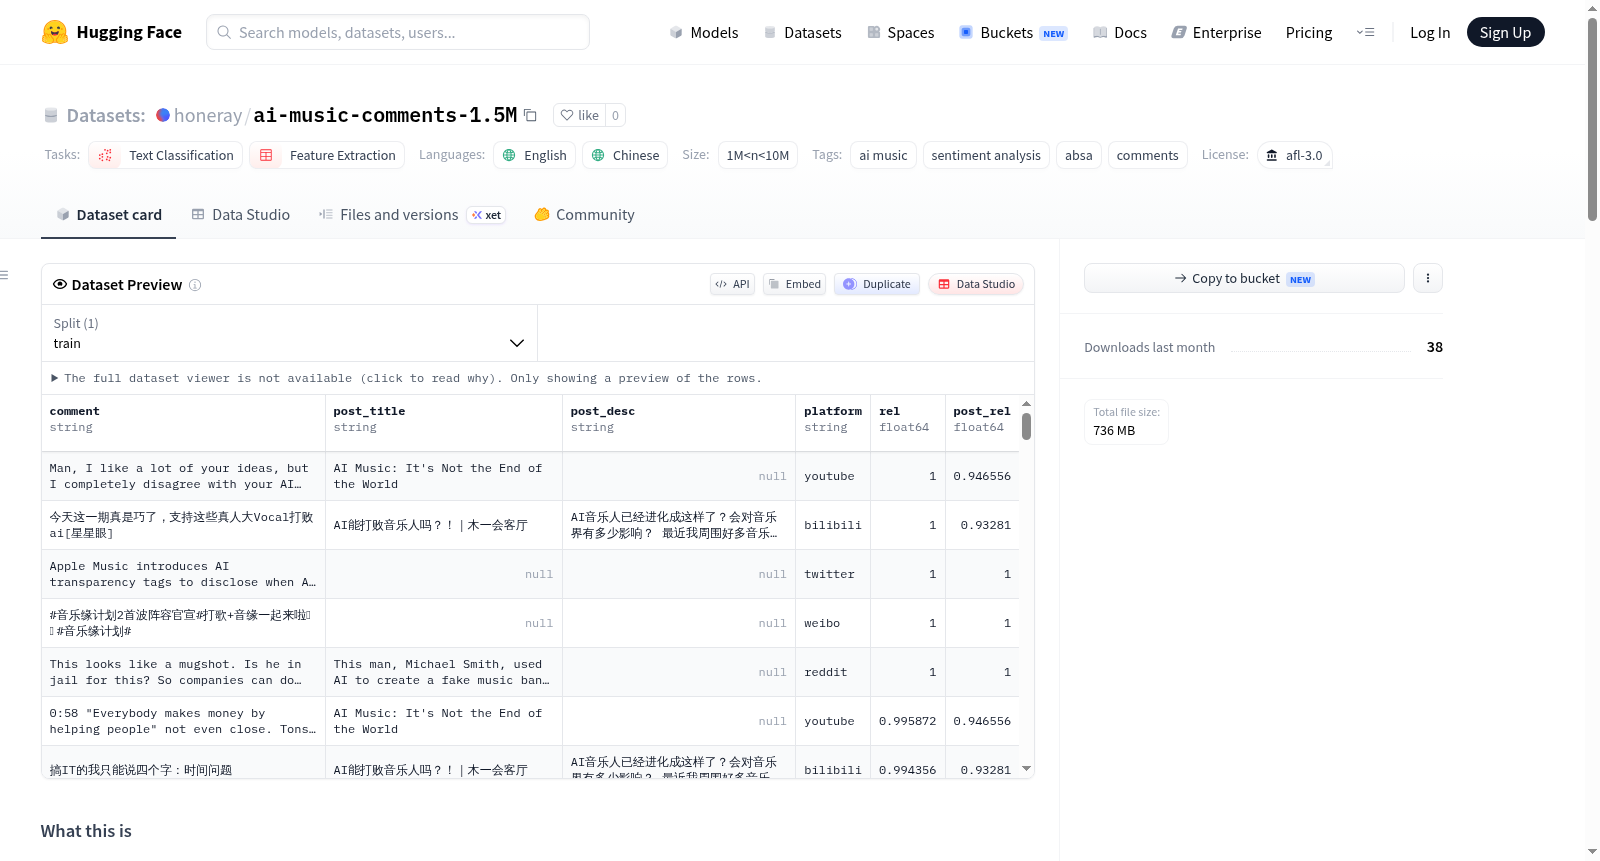
这是一个包含超过150万条关于AI音乐的评论的语料库,这些评论从YouTube、Bilibili、Reddit、Twitter/X和Weibo收集,因此评论主要是英文和中文。
A corpus of >1.5M comments about AI music gathered from YouTube, Bilibili, Reddit, Twitter/X, and Weibo. Due to the nature of the platforms scraped, the comments are largely written in English and Chinese.
提供机构:
honeray搜集汇总
数据集介绍
构建方式
该数据集汇集了来自YouTube、Bilibili、Reddit、Twitter/X及微博等多元社交媒体平台上超过150万条关于AI音乐的评论,构建过程注重数据的原始性与广泛覆盖性。原始数据集raw_data.csv完整收录了所有采集到的评论及其关联的帖子元数据,包括帖子标题、播放量、点赞数、创作者信息、评论互动指标等。为提升数据质量,研究者进一步筛选出包含至少5个点赞且帖子播放量与评论比不低于0.001的约9.5万条评论,形成final_data.csv,并额外引入了每条评论及所属帖子的相关性评分。
特点
该数据集的核心独特之处在于其规模庞大且跨平台、跨语言的特性,评论内容以英文和中文为主,能够真实映射全球用户对AI音乐的态度与讨论。数据集提供了丰富的字段,不仅涵盖评论内容、点赞、回复、转发等互动指标,还包括帖子层面的元数据如描述、关键词、收藏数等,尤其Bilibili平台中弹幕的纳入拓展了评论的多样性。final_data中的相关性评分为用户研究AI音乐话题的聚焦分析提供了量化基础,使得从海量噪声中提取有意义的见解成为可能。
使用方法
用户可灵活利用该数据集开展多种自然语言处理任务,例如基于评论内容的文本分类、情感分析,或面向AI音乐相关特定方面的细粒度情感分析。对于raw_data.csv,适合进行大规模语料探索、主题建模和跨平台对比研究;而final_data.csv因筛选和标注了相关性,更适用于模型的精准训练与评估。研究者亦可依托帖子元数据探索评论互动与帖子热度之间的关联,或基于语言特征分析中英文用户对AI音乐接受度的差异。
背景与挑战
背景概述
随着生成式人工智能在音乐创作领域的迅猛发展,公众对AI音乐的态度与反馈成为理解技术社会影响的关键窗口。ai-music-comments-1.5M数据集由研究团队于2023年创建,系统性地从YouTube、Bilibili、Reddit、Twitter/X和微博五大跨文化平台采集了超过150万条关于AI音乐的评论,覆盖英文与中文两大语系。该数据集的核心研究问题聚焦于公众对AI音乐的情感倾向与细粒度观点挖掘,为情感分析、基于方面的情感分析(ABSA)及特征提取任务提供了大规模、多源的基准语料。其发布填补了AI音乐领域缺乏大规模公众评论数据的空白,对推动计算社会学、人机交互及音乐科技交叉研究具有重要影响力。
当前挑战
该数据集面临的挑战具有双重维度。在领域问题层面,AI音乐作为新兴产物,其公众讨论常混杂技术认知、审美价值与伦理争议等多重维度,现有情感分析模型难以精准捕捉其中隐含的细微立场(如“技术惊艳但艺术性不足”),亟需更精细的基于方面的情感分析方法。在构建过程中,跨平台数据整合面临显著异构性:不同平台的点赞数、转发量等互动指标含义不一(如Reddit的点赞可为负值),且Bilibili弹幕与常规评论需统一处理;此外,数据清洗需平衡噪声过滤与信息保留,仅5.9%的评论(约9.5万条)通过高人气阈值筛选,凸显大规模社交媒体数据在质量保障与代表性之间的权衡之困。
常用场景
经典使用场景
该数据集汇聚了来自YouTube、Bilibili、Reddit、Twitter/X和微博等主流社交平台上超过150万条关于AI音乐的评论,构建了一个多语言、多平台的用户反馈语料库。其经典使用场景在于情感分析与观点挖掘,研究者可借此探索公众对AI生成音乐的态度、情绪倾向及争议焦点。数据集中每条评论均附带点赞数、回复数等元数据,便于进行多层次分析,例如识别高影响力用户或热门话题。此外,经过处理的final_data.csv子集通过筛选高互动评论并标注相关性分数,为精细化研究提供了高质量样本,尤其适合训练情感分类或主题建模模型。
解决学术问题
该数据集有效填补了AI音乐领域大规模、跨平台用户反馈数据的空白,解决了学术界长期面临的样本稀缺与代表性不足问题。通过整合多源异构数据,它支持研究者深入解析公众对AI音乐创作的情感分歧——例如,技术乐观派与艺术保守派之间的观念冲突。同时,数据集中完整的评论互动链(如回复关系)有助于研究信息扩散模式与舆论极化现象。其意义在于为计算社会科学、自然语言处理与音乐认知科学的交叉研究提供了可量化的实证基础,推动了对AI艺术接受度的理论建模。
衍生相关工作
基于该数据集,研究者已衍生出多项经典工作,包括结合评论情感分析与音频特征的AI音乐质量评估模型,以及利用用户评论的立场检测技术追踪技术接受度的动态变化。例如,有工作通过训练主题模型识别出“创造力质疑”“版权争议”等关键讨论簇,进而分析不同平台(如技术论坛Bilibili与社交平台Twitter)的话语差异。另一些研究则引入知识蒸馏框架,将数据集中的粗粒度情感标签转化为细粒度维度(如“惊奇”“厌恶”),为多模态生成模型的反馈学习提供了新范式。这些工作不仅验证了数据集的实用性,也激发了AI伦理与计算创造力的交叉探讨。
以上内容由遇见数据集搜集并总结生成


