
遇见数据集

ConvAI2-Mapping_1k-ERNIE-enhanced

收藏
Hugging Face2026-08-22 更新2026-08-23 收录
官方服务:

资源简介:

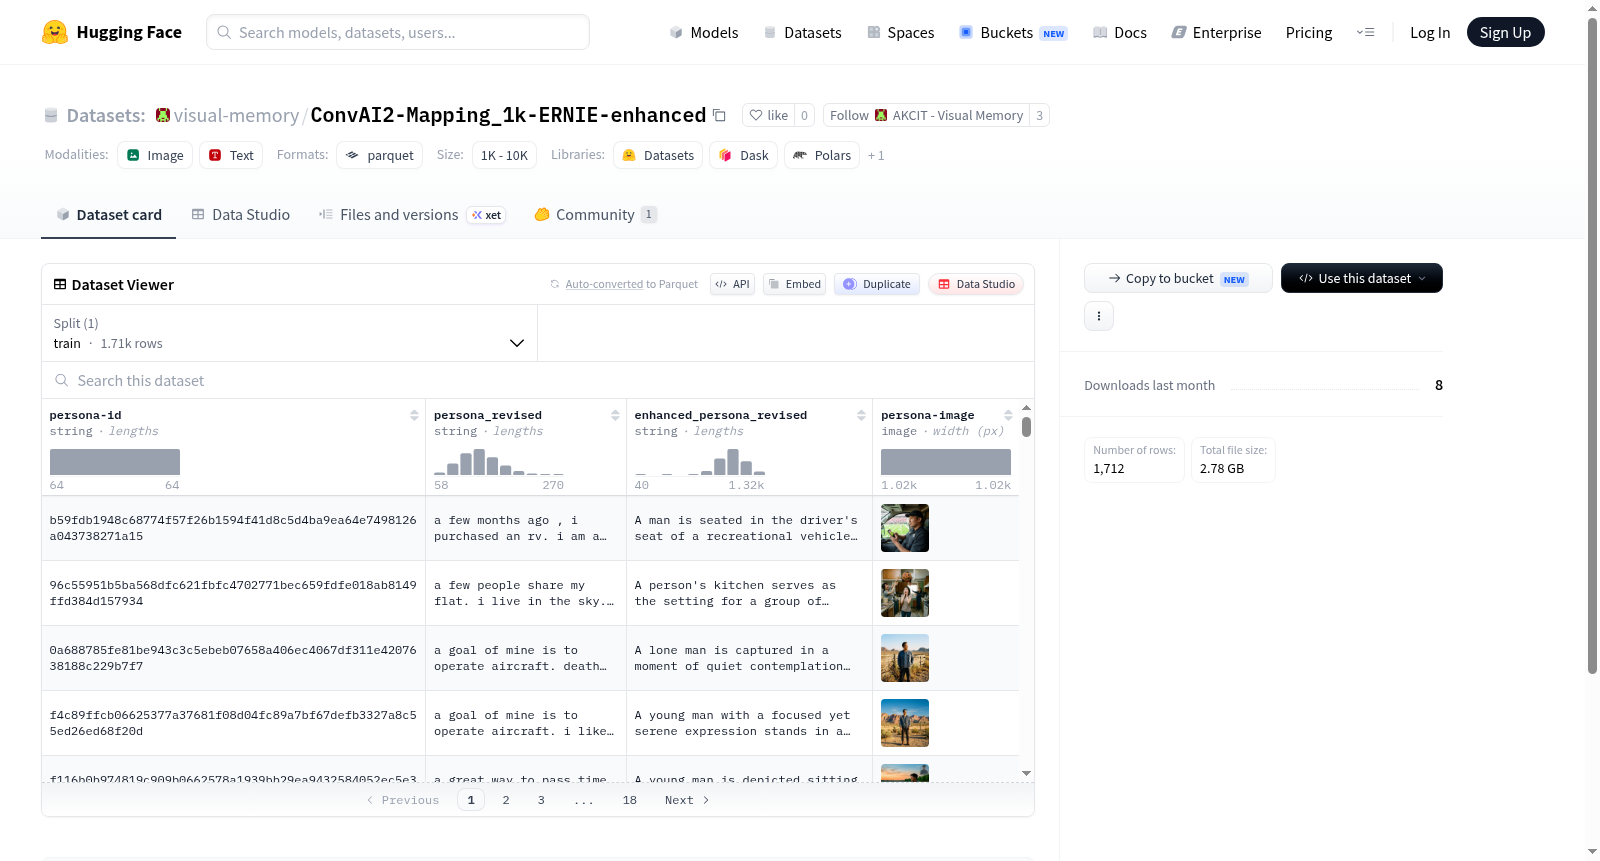
该数据集包含1712个训练样本,每个样本由四个字段组成:persona-id(字符串类型的标识符)、persona_revised(字符串类型的修订后人物角色文本)、enhanced_persona_revised(字符串类型的增强修订后人物角色文本)以及persona-image(图像类型的人物角色图像)。数据集仅提供训练集,总大小约为2.77GB。基于字段名称,该数据集可能用于多模态人物角色建模、文本增强或图像-文本对齐等任务,但具体用途未在README中说明。

The dataset contains 1712 training samples, each consisting of four fields: persona-id (string identifier), persona_revised (string of revised persona text), enhanced_persona_revised (string of enhanced revised persona text), and persona-image (image of persona). Only the training set is provided, with a total size of approximately 2.77GB. Based on the field names, the dataset may be used for multimodal persona modeling, text augmentation, or image-text alignment tasks.

创建时间:
2026-08-22
原始信息汇总

数据集概述

该数据集名为 ConvAI2-Mapping_1k-ERNIE-enhanced,托管于 Hugging Face 平台,地址为:https://huggingface.co/datasets/visual-memory/ConvAI2-Mapping_1k-ERNIE-enhanced

基本信息

  • 数据集大小:约 2.58 GB(2,773,414,421 字节)
  • 下载大小:约 2.59 GB(2,780,459,587 字节)
  • 配置:默认配置(default)
  • 数据文件:位于 data/train-* 路径下

数据划分

  • 训练集(train)
    • 样本数量:1,712 条
    • 大小:2,773,414,421 字节

数据特征(Features)

该数据集包含以下字段:

字段名 类型 说明
persona-id string 人物角色的唯一标识符
persona_revised string 修订后的人物角色描述
enhanced_persona_revised string 增强后的修订人物角色描述(可能经 ERNIE 模型增强)
persona-image image 与人物角色对应的图片

数据集用途推测

该数据集基于 ConvAI2 对话任务构建,对人物角色(persona)进行了修订和增强(可能借助 ERNIE 模型),并关联了图片信息,适用于多模态对话系统、人物角色建模或视觉-文本对齐相关的研究与训练。
搜集汇总
数据集介绍
ConvAI2-Mapping_1k-ERNIE-enhanced 数据集图片
构建方式
该数据集源自ConvAI2对话任务,通过对其中1,000条人物画像(persona)样本进行细致的修订与扩充构建而成。具体而言,原始persona文本经人工或规则化处理得到修订版(persona_revised),随后借助ERNIE模型的语义增强能力,生成语义更为丰富、表达更为自然的增强版(enhanced_persona_revised)。每条样本还关联了对应的人物图像(persona-image),从而实现多模态信息的对齐与融合。数据集划分了训练集,共包含1,712个样本,以支持模型在人物一致性对话场景下的训练与评估。
特点
该数据集兼具多模态性与语义增强特性,是研究个性一致性对话生成的重要资源。其特色在于引入了ERNIE模型进行语义层面的增强,使人物画像的表达更具多样性和上下文适应性。同时,persona-image的引入使得数据不再局限于文本,为多模态对话系统提供了可能。此外,数据规模虽不足两千条,但质量经过精细修订,能够有效支撑小样本学习、提示学习等前沿研究,尤其适用于检测模型对人物特质的捕捉与表达能力。
使用方法
使用时,研究者可依据任务需求选用文本与图像的不同组合。对于纯文本对话模型,可加载persona_revised或enhanced_persona_revised字段作为人物背景输入,与对话历史共同训练生成一致性回复。对于多模态模型,则可结合persona-image进行视觉特征融合,增强对人物情境的理解。该数据集以HuggingFace数据集格式提供,支持通过datasets库直接加载,便于集成到现有的Transformer或PyTorch训练流程中。建议在使用前对图像进行预处理,并设计合理的训练验证集划分以评估泛化能力。
背景与挑战
背景概述
ConvAI2-Mapping_1k-ERNIE-enhanced数据集诞生于对话系统与多模态交互研究的前沿交汇点,由致力于人机对话智能化的研究团队构建,其核心研究问题在于如何通过增强式语义表征模型,提升开放域对话系统中个性化角色一致性的维持能力。该数据集依托ConvAI2基准,精挑细选千余例对话场景,利用ERNIE模型的语义增强技术对人物画像进行深度重构,并辅以人物图像,形成多模态对齐的训练语料。此举不仅丰富了角色对话的上下文表达,更推动了预训练语言模型在个性化对话生成中的有效性验证,对后续研究在角色建模与跨模态理解层面产生了积极的示范效应,成为探索对话系统拟人化与情境感知能力的重要数据支撑。
当前挑战
该数据集所应对的领域挑战集中于开放域对话系统的两个关键难题:一是如何在长序对话中稳定维持角色身份与事实一致性,避免生成偏离用户画像的回应;二是如何高效融合文本与视觉信息,使机器能够理解并复用人物图像中的隐含特征,从而丰富对话的具象表达。在构建过程中,研究者面临了多重现实障碍,包括原始对话样本的筛选与清洗、ERNIE增强后文本与原始画像信息的语义对齐精度控制、以及多模态数据规模与质量间的权衡。此外,训练数据仅含1712例样本,需在有限样本下达到泛化能力,这要求数据增强策略具备高度针对性,对数据集的平衡性与代表性提出了严苛挑战。
常用场景
经典使用场景
该数据集的核心用途在于对话生成与个性一致性建模,尤其聚焦于将抽象人格描述映射为具体、生动的视觉表征。通过提供修订后的人格文本及对应图像,研究者可训练模型在开放域对话中维系稳定的角色身份,提升回应的人格契合度与可想象性。其经典范式包括基于人格嵌入的编码器-解码器架构,以及融合多模态信息的对话生成系统,为个性对话代理的发展奠定了数据基础。
实际应用
在实际应用中,该数据集可赋能虚拟助手、游戏NPC及社交机器人的个性定制。基于此训练的模型能在交互中动态调用视觉化的人格档案,使回应更具亲和力与独特性。例如,在教育陪练机器人中模拟特定历史人物,或在心理疏导应用中保持咨询师的温暖人设。该数据还支持跨模态检索,帮助构建‘以图会意’的个性表达,提升人机交互的自然度与沉浸感。
衍生相关工作
该数据集衍生了多项后续研究,包括基于对比学习的个性表征优化、视觉-文本联合嵌入的对话策略,以及针对人格迁移的生成对抗网络。相关工作还拓展至个性化推荐中的用户画像建模,以及多模态情感分析中的角色-情绪耦合。研究者以此为基础,探索了少样本下的个性化对话微调,并验证了图像增强对长对话一致性的积极作用,形成了从数据集构建到端到端应用的完整研究链条。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

