
遇见数据集

cmu-lti/osim-post-training

收藏
Hugging Face2026-06-09 更新2026-06-14 收录
官方服务:

资源简介:

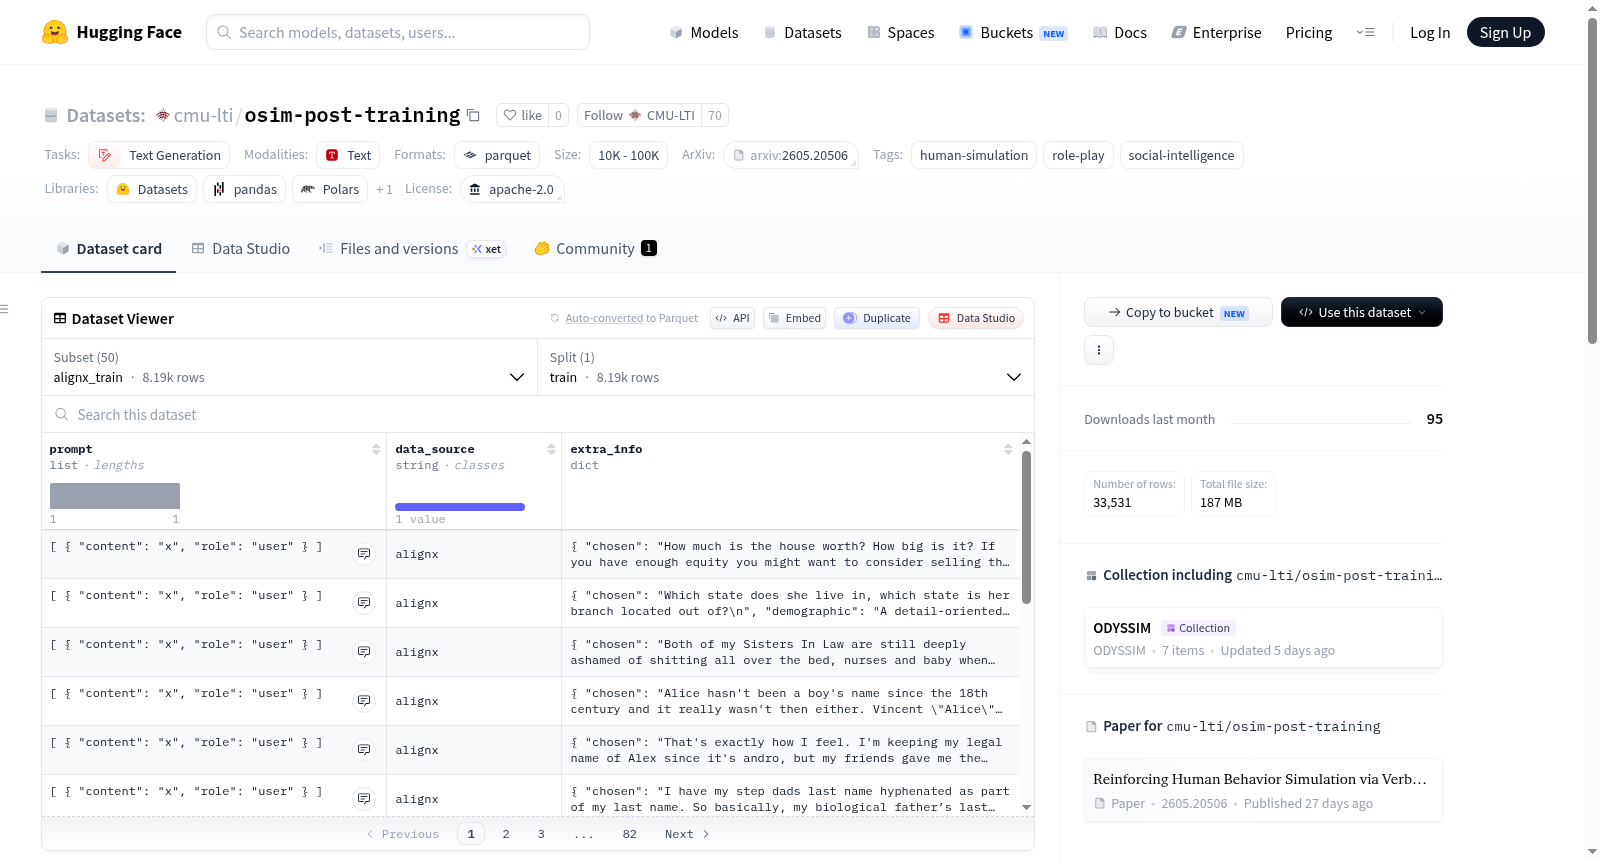
SOUL是一个用于人类行为模拟的数据套件,应用于论文《通过口头反馈强化人类行为模拟》(DITTO),覆盖对话、社交模拟、社交认知、角色扮演和以人为中心的评估。该数据集是CMU-LTI组织对原始sunweiwei/Soul数据集的镜像,包含训练和测试数据,以parquet格式组织,每个任务都有独立的配置。数据用于支持ODYSSIM版本的后续训练,并包括多个任务如alignx、behaviorchain、coser等,旨在模拟人类行为以改进AI模型的社会智能和角色扮演能力。

SOUL is the data suite for human behavior simulation used in Reinforcing Human Behavior Simulation via Verbal Feedback (DITTO), spanning conversation, social simulation, social cognition, role-play, and human-centric evaluation. This CMU-LTI mirror hosts the post-training data used for ODYSSIM releases, mirroring the original sunweiwei/Soul dataset layout. It includes training and test data in parquet format, organized into multiple task configurations such as alignx, behaviorchain, coser, etc., designed to simulate human behavior for enhancing AI models social intelligence and role-play capabilities.
提供机构:
cmu-lti
搜集汇总
数据集介绍
cmu-lti/osim-post-training 数据集图片
构建方式
osim-post-training数据集源自卡内基梅隆大学语言技术研究所(CMU-LTI),是用于人类行为模拟的DITTO模型后训练数据套件SOUL的镜像。该数据集构建围绕强化学习训练与评估框架,将原始数据按任务类型划分为训练集和测试集两个文件夹,每个任务对应一个独立的Parquet文件。共涵盖23个训练配置和22个测试配置,包括AlignX、BehaviorChain、Coser、Fantom等多样化任务,每个任务的extra_info schema在训练与评估阶段存在差异,因此以任务加分割的独立配置形式呈现,确保数据加载的清晰与一致性。
使用方法
使用该数据集时,可通过HuggingFace Datasets库的load_dataset函数按指定配置加载对应任务的数据。例如,加载userllm任务的训练集可执行'load_dataset("cmu-lti/osim-post-training", "userllm_train", split="train")',加载测试集则使用'userllm_test'配置。用户也可直接读取Parquet文件路径,如'train/userllm_rl_train.parquet'。数据加载后可直接用于模型的强化学习训练或性能评估,所有配置均支持标准的split参数以区分训练与测试数据。
背景与挑战
背景概述
在人工智能领域,如何让大语言模型具备可信的人类行为模拟能力,已成为社会智能研究的核心议题。osim-post-training数据集由卡内基梅隆大学语言技术研究所(CMU-LTI)的孙巍巍、周旭辉等研究团队于2026年创建,旨在为ODYSSIM项目提供后训练数据支撑。该数据集围绕强化人类行为模拟中的言语反馈机制(DITTO)展开,涵盖对话、社会模拟、社会认知、角色扮演及以人为本的评估等多元场景,为提升模型在复杂社交互动中的表现提供了系统性的训练与评测基准。其发布不仅填补了人类行为仿真领域高质量后训练数据的空白,也为后续研究者在社会智能方向上的探索奠定了坚实基础。
当前挑战
osim-post-training数据集所应对的核心挑战在于,大语言模型在模拟人类行为时,常面临真实性不足、社交语境理解浅层以及行为一致性缺失等瓶颈。具体而言,模型难以在长程对话中保持连贯的角色身份与社会规范遵循,同时缺乏对细微言语反馈的适应能力,导致模拟行为与真实人类反应之间存在显著偏差。在构建过程中,团队需整合来自多个异构来源(如角色扮演、社会科学问卷、日常对话)的数据,并确保各任务间额外信息(extra_info)格式的兼容性与可复用性,这带来了数据清洗、标准化及跨任务评估一致性等方面的显著技术难度。
常用场景
经典使用场景
在人类行为模拟的研究领域中,osim-post-training数据集以其丰富的多任务配置而引人注目。该数据集汇聚了涵盖对话模拟、社会推理、角色扮演等多元场景的强化学习训练与评估样本,尤其适用于训练具备社会智能的语言模型,使其能够生成更符合人类行为逻辑的交互回应。研究者可借助此数据集对大型语言模型进行后训练,以增强其在不同社会情境下的仿真能力,从而在人与AI的互动中实现更为自然和可信的模拟效果。
解决学术问题
该数据集的核心价值在于填补了现有模型在复杂社会情境中行为模拟的空白。传统语言模型多聚焦于信息传递的准确性,而缺乏对人际互动中隐含规则、情绪变化及社会规范的细腻理解。osim-post-training通过提供涵盖大量社会互动的结构化数据,支持研究者探索如何利用语言反馈机制强化模型的人类行为模拟能力,进而有效提升模型在社会认知、角色适配及情景一致性等维度的表现。
实际应用
从应用层面看,该数据集为构建高性能社会仿真AI提供了坚实的数据基础。其衍生模型可广泛应用于虚拟社交助手的开发、智能客服的情感化交互设计、教育场景中的模拟教学对话,以及游戏环境中具有逼真人格特征的非玩家角色的行为构建。这些应用场景均要求AI能够展现出对社会规则的理解与人类行为模式的模仿,而osim-post-training正是实现此类目标的关键训练资源。
数据集最近研究
最新研究方向
近年来,随着大语言模型在文本生成领域的突破性进展,人类行为模拟与社交智能的强化学习训练成为前沿热点。osim-post-training数据集应运而生,整合了涵盖对话、社交模拟、社交认知、角色扮演及人类中心评估的多元子任务,为构建具有类人社会交互能力的智能体提供了关键训练资源。该数据集基于DITTO框架,通过语言反馈机制强化行为模拟,相关研究在arXiv发布后迅速引起学界关注。其核心意义在于推动人工智能从静态文本生成迈向动态社会情境理解,为构建可信、善解人意的社交智能系统奠定了数据基础,对下一代人机协作与虚拟社会实验具有深远影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

