
遇见数据集

ghananlpcommunity/ghanaian-corpus-generate

收藏
Hugging Face2026-07-08 更新2026-07-22 收录
官方服务:

资源简介:

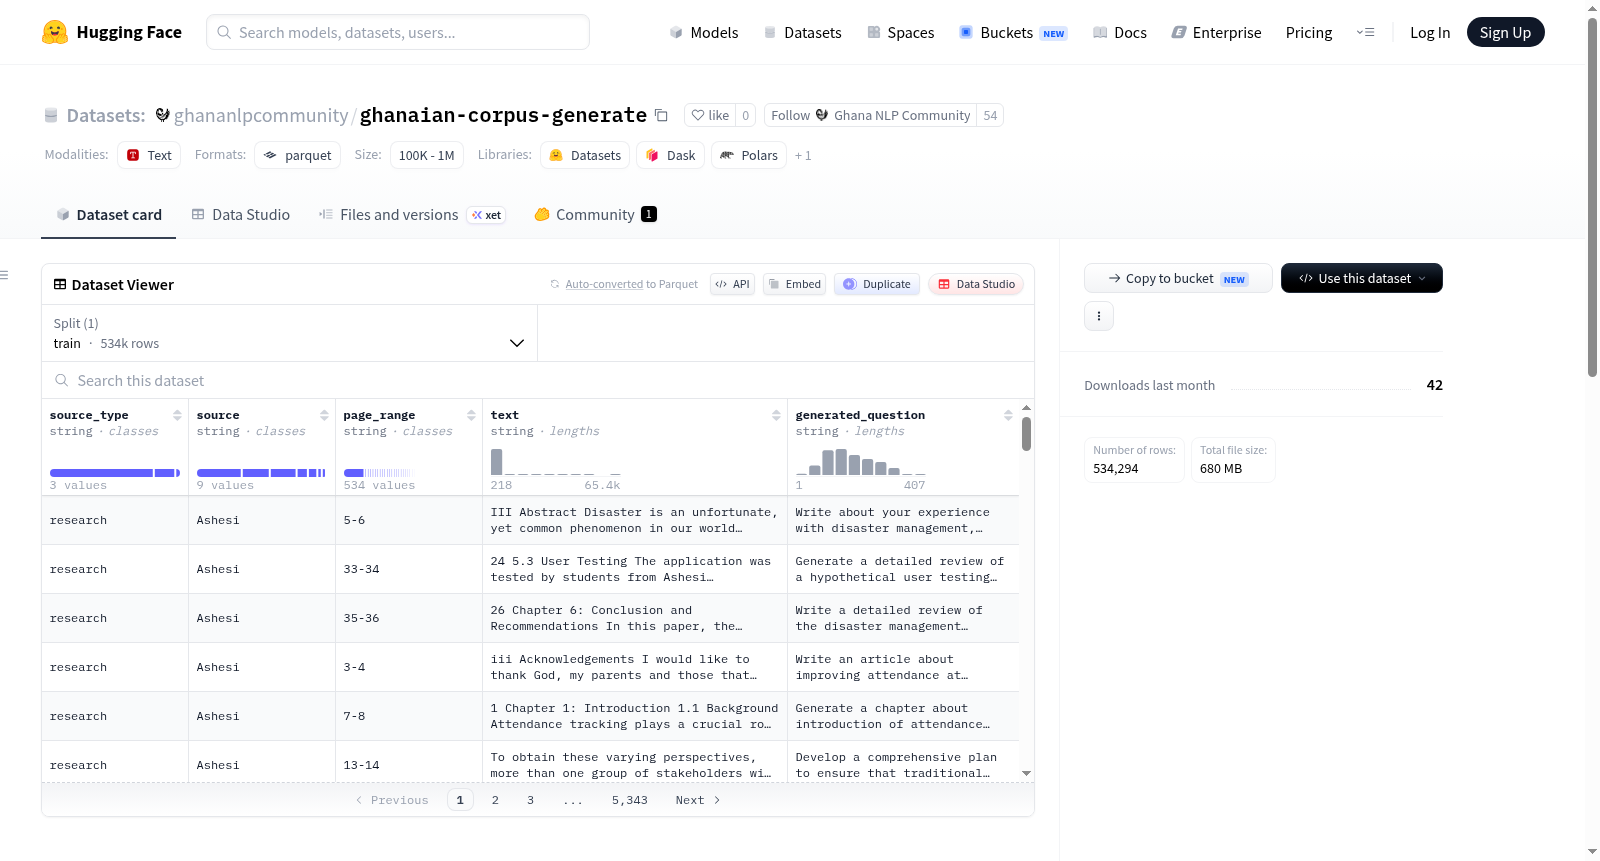
这是一个基于534,294个加纳语料块使用Qwen2.5-0.5B-Instruct模型通过vLLM生成的合成内容编写提示数据集。每个数据行包含:source_type(源文档类别,如议会、新闻、学术等)、source(源文档名称或标识符)、page_range(源文档中的页码范围)、text(原始语料块文本,至少4个句子,每个句子包含6个以上唯一字母单词)和generated_question(合成提示,代表内容编写者输入AI助手以生成类似给定语料块文本的指令)。数据集旨在用于微调大型语言模型,以生成基于加纳语境的文本,其中text列提供目标内容,generated_question列提供指令式提示,适用于指令调优或监督微调。

Synthetic content-writer prompts generated from 534,294 Ghanaian corpus chunks using Qwen2.5-0.5B-Instruct via vLLM. Each row contains: source_type (category of the source document, e.g., parliament, news, academic), source (name or identifier of the source document), page_range (page range within the source), text (the original corpus chunk text with a minimum of 4 sentences, each with 6+ unique alphabetic words), and generated_question (a synthetic prompt representing what a content writer would type into an AI assistant to produce text similar to the given chunk). The dataset is intended for fine-tuning LLMs to generate text grounded in Ghanaian context, with the text column providing target content and generated_question providing instruction-style prompts, suitable for instruction-tuning or supervised fine-tuning.
提供机构:
ghananlpcommunity
搜集汇总
数据集介绍
ghananlpcommunity/ghanaian-corpus-generate 数据集图片
构建方式
该数据集源于加纳语料库的深度加工,初始阶段从加纳议会会议记录、新闻报道、学术论文及书籍中搜集了约116万个文本片段。通过严格的质控筛选,剔除句子数量不足4句或句子中不含至少6个独特字母词的片段,最终保留了534,294个高质量语料块。随后,依托Qwen2.5-0.5B-Instruct模型以128个并发工作流在vLLM框架下为每个语块生成一条内容写作提示,并经过多行模板前缀清除与引号剥离等清洗工序,构建了指令与文本配对的结构化数据集。
特点
该数据集独树一帜地聚焦于加纳本土语境,涵盖议会、新闻、学术等多源类型,每条样本均包含源文档类别、名称、页码范围、原始文本及生成的写作提示,维度丰富。其核心亮点在于通过合成提示模拟内容创作者向AI助手输入指令的场景,使文本与提示形成天然映射,特别适合用于指令微调或监督式微调,为生成式语言模型注入加纳特有的语言文化基因。
使用方法
用户可直接加载数据集进行模型微调,将'generated_question'列作为输入指令,'text'列作为期望输出,适用于指导模型生成加纳背景下的连贯文本。建议将数据划分为训练集与验证集,利用其58万条样本规模开展指令对齐训练。使用时需注意源文本可能包含议会术语或地方性表达,可结合分词器适配非英语语料,同时依据Apache-2.0许可协议确保合规调用。
背景与挑战
背景概述
在自然语言处理领域,针对特定地域与语言背景的语料资源长期匮乏,限制了语言模型在该类场景下的适应性与生成质量。加纳语料生成数据集(Ghanaian Corpus—Generated Content-Writer Prompts)由研究团队于近期构建,基于约116万文本片段,涵盖加纳议会记录、新闻文章、学术论文及书籍等多种来源。核心研究问题在于如何利用合成提示(prompt)技术,将原始语料转化为可用于指令微调或监督微调的成对数据,从而驱动语言模型生成契合加纳文化背景与语境的文本。该数据集包含534,294条高质量样本,每条数据同时提供原始文本与对应的合成内容创作者提示,为低资源区域语言模型的上下文理解与文本生成研究提供了可复用的基础资源,对推动非洲语言与文化的自然语言处理研究具有重要影响力。
当前挑战
该数据集所面临的挑战主要来自两方面。其一,在领域问题层面,加纳语料资源稀少、语言变体多样,且兼具口语与书面语混杂特征,传统通用语料库难以覆盖其独特的社会文化语境;模型在生成加纳相关文本时,容易出现事实偏差或文化不敏感现象,这成为该领域研究的核心痛点。其二,在构建过程中,挑战体现在多个环节:原始语料来源分散、格式不一,需进行大量清洗与格式化处理;引入Qwen2.5-0.5B-Instruct模型进行提示生成时,面临长文本连贯性不足与生成一致性控制困难等问题;此外,多源语料中隐含的噪音与冗余信息增加了质量过滤的难度,需借助严格的句法与词法规则进行筛选,以保证最终数据集的高质量与可用性。
常用场景
经典使用场景
在自然语言处理与低资源语言研究领域,ghanaian-corpus-generate数据集为加纳语境的文本生成任务提供了宝贵的监督信号。该数据集的经典使用场景在于指令微调与监督式微调,研究者可借助其构建的‘内容提示-对应文本’对齐结构,训练生成模型精准理解加纳语境的写作意图。通过将生成问题作为指令、原始语料片段作为目标输出,模型能够学习在非洲本土文化、社会与政治背景下生成风格与内容均具有地域真实性的文本,从而突破大语言模型在低资源语言区域的能力瓶颈。
实际应用
在实际部署中,该数据集可支撑构建面向加纳本地的AI写作助手,辅助议会记录整理、新闻自动生成以及学术摘要撰写等任务。基于该数据集训练的模型能够理解用户以加纳英语表达的写作指令,并生成符合当地议会文体、新闻风格或学术规范的内容。此外,它还能作为非洲跨国企业或非政府组织定制化内容生产工具的核心数据支撑,在保持语言地道性的同时显著降低人工撰写成本,为加纳乃至西非地区的数字化文本服务提供基础设施级别的支持。
衍生相关工作
该数据集衍生出一系列聚焦低资源语言区域指令微调与合成数据增强的经典工作。研究者可基于其‘源数据-合成指令’双列结构,探索不同规模指令模型(如Qwen2.5系列)对非洲语言文本的理解差异,并分析合成提示质量对下游生成任务的衰减规律。此外,该数据集的构建流程——从大型原始语料库中过滤短文本、再生成意图对齐的指令——本身已形成可复现范式,启发了针对尼日利亚语、斯瓦希里语等其他非洲语言类似数据集的自动构建方法,推动了低资源语言指令数据生态的跨语言扩展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

