LukasSonn/DoxygenStrings-Long
收藏资源简介:
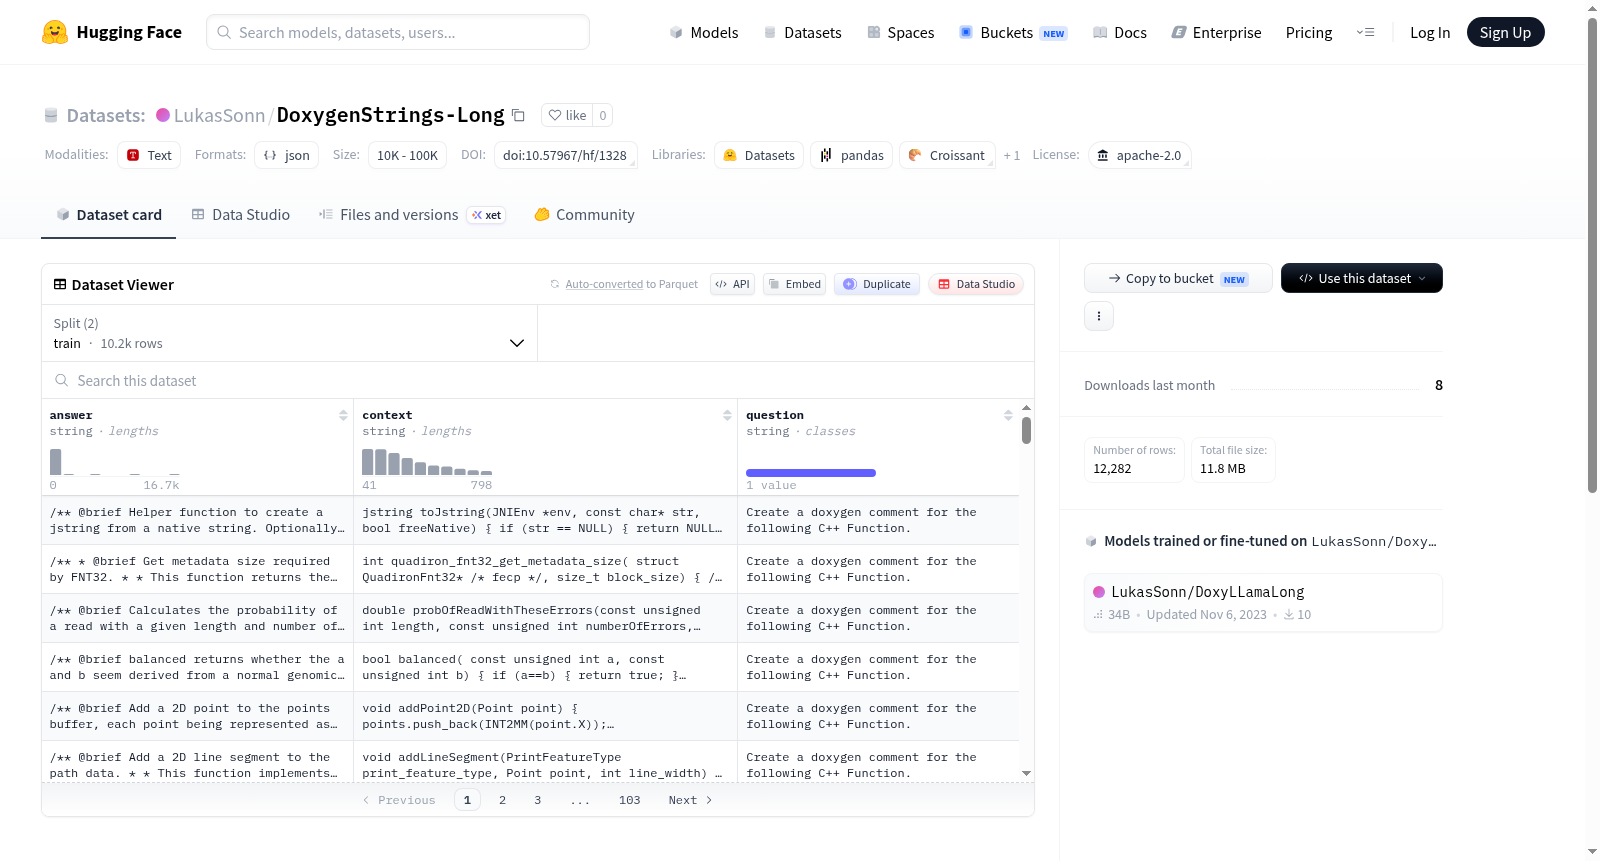
--- license: apache-2.0 --- # Dataset Info C++ + Natural Description -> Doxygen Documentation This dataset was created for my bachelors thesis investigating how LLMs can be fine-tuned to generate doxygen documentation. It was created by using the “Source code analysis dataset” by Gelman, Banjo Obayomi, Jessica Moore und David Slater (doi: 10.1016/j.dib.2019.104712). The following SQL-Statement was used to grab raw data from the dataset: ``` SELECT * FROM all_data WHERE LENGTH(comment) > 300 and LENGTH(code) > 100 AND LENGTH(code) < 80 AND code NOT LIKE '%//%' AND code NOT LIKE '%/*%' AND code NOT LIKE '%*/%' AND filename LIKE '%.cpp%' LIMIT 12000 ``` After selecting the Data Code LLaMa Instruct 34B is tasked to combine the human-written description of the functionality with the function code into a Doxygen-Comment. Any results which included the sample doxygen string or no doxygen string at all where filtered from the set.
--- 许可证:Apache-2.0 --- # 数据集说明:C++代码+自然描述 → Doxygen文档 本数据集专为支撑本科毕业论文构建,用于探究如何对大语言模型(Large Language Model, LLM)进行微调以生成Doxygen文档。本数据集基于Gelman、Banjo Obayomi、Jessica Moore与David Slater发布的「源代码分析数据集」(DOI: 10.1016/j.dib.2019.104712)构建。 我们使用以下SQL语句从原数据集中提取原始数据: sql SELECT * FROM all_data WHERE LENGTH(comment) > 300 AND LENGTH(code) > 100 AND LENGTH(code) < 80 AND code NOT LIKE '%//%' AND code NOT LIKE '%/*%' AND code NOT LIKE '%*/%' AND filename LIKE '%.cpp%' LIMIT 12000 上述SQL语句用于从`all_data`表中查询满足如下条件的全部记录:注释字段长度大于300、代码字段长度介于100至80之间、代码不包含单行注释`//`与块注释`/*`、`*/`,且文件名后缀为`.cpp`,最终限制返回12000条数据。 完成数据筛选后,我们调用Code LLaMa Instruct 34B模型,将人工编写的功能描述与对应函数代码整合为Doxygen注释。随后,我们过滤掉包含示例Doxygen字符串或完全未生成任何Doxygen注释的结果。
数据集信息:C++代码与自然描述生成Doxygen文档
数据集来源
- 数据集基于Gelman, Banjo Obayomi, Jessica Moore和David Slater的“源代码分析数据集”(doi: 10.1016/j.dib.2019.104712)创建。
数据选择标准
- 使用SQL语句从源数据集中筛选数据: sql SELECT * FROM all_data WHERE LENGTH(comment) > 300 and LENGTH(code) > 100 AND LENGTH(code) < 80 AND code NOT LIKE %//% AND code NOT LIKE %/% AND code NOT LIKE %/% AND filename LIKE %.cpp% LIMIT 12000
数据处理
- 使用Code LLaMa Instruct 34B模型将人工编写的功能描述与函数代码结合,生成Doxygen注释。
- 过滤掉包含示例Doxygen字符串或无Doxygen字符串的结果。