
遇见数据集

media-metadata-wikidata-entities

收藏
Hugging Face2026-06-26 更新2026-06-29 收录
官方服务:

资源简介:

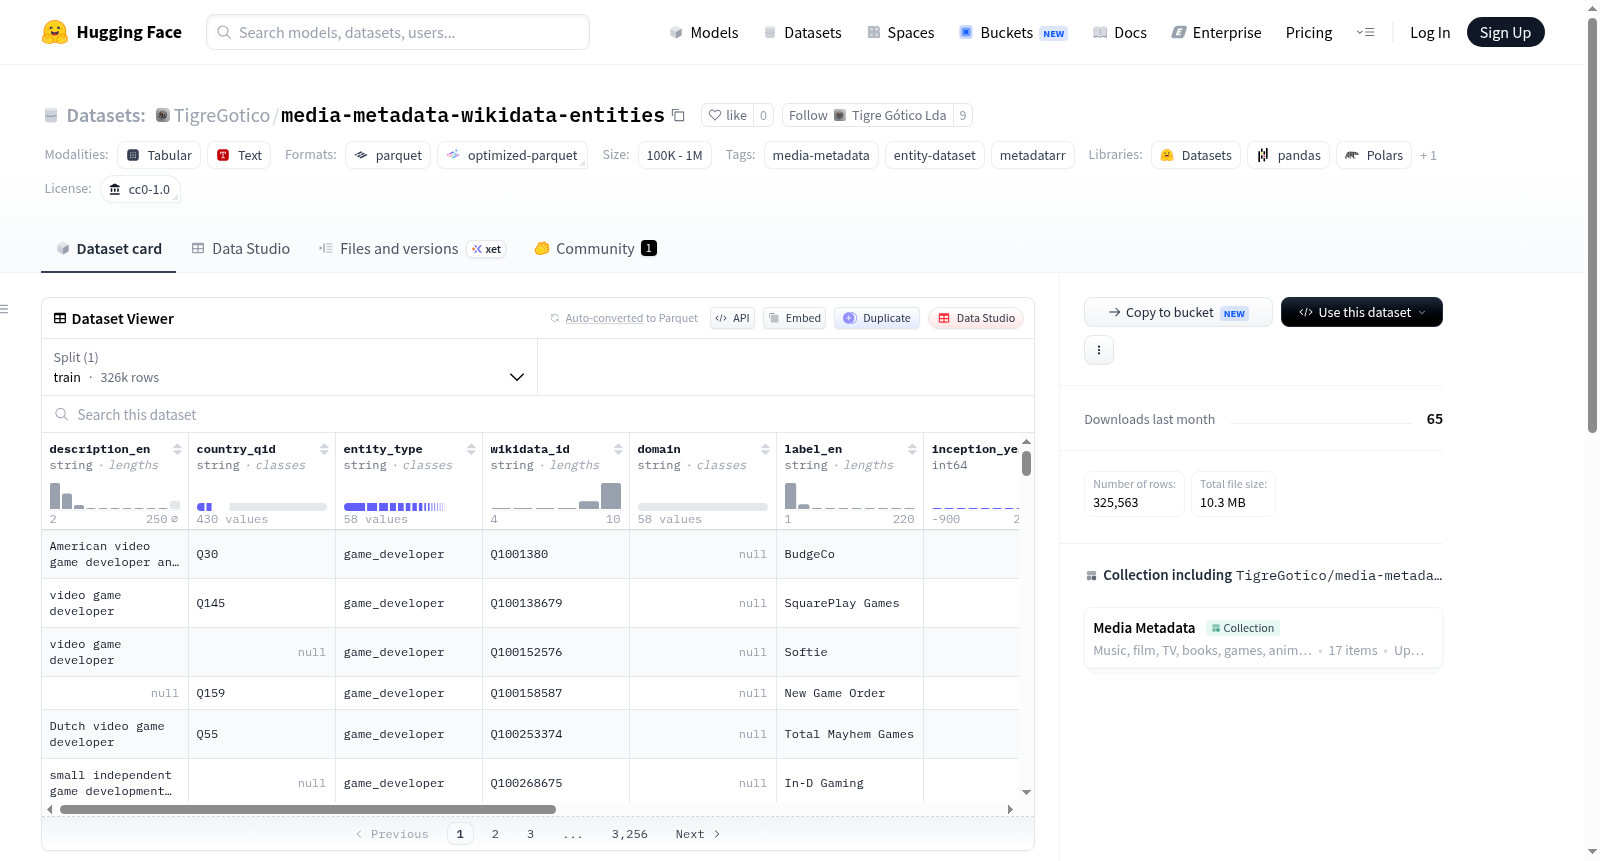
Wikidata Media Entities 是一个从 Wikidata 知识库中通过 SPARQL 查询提取的、专注于媒体行业组织结构的数据集,非通用 Wikidata 数据转储。它精心筛选了与媒体元数据相关的实体,包括公司、工作室和机构,总计约32.6万个条目。数据集覆盖七种核心实体类型:视频游戏开发工作室、电影制作公司、电视网络与流媒体平台、音乐唱片公司、广播电台、图书出版公司以及日本动画工作室。每个实体包含九个结构化字段:Wikidata唯一标识符(QID)、英文名称标签、英文描述、所属国家名称、国家的Wikidata QID、成立年份、解散年份(若活跃则为空)、官方网站URL和实体类型。适用于构建知识图谱、为其他数据集提供信息补充,或作为命名实体识别(NER)任务的训练数据。遵循 CC0 1.0 公共领域贡献许可协议。

Wikidata Media Entities is a dataset extracted from the Wikidata knowledge base through targeted SPARQL queries, focusing on the organizational structure of the media industry. It is not a general Wikidata data dump but a carefully curated collection of entities related to media metadata, including companies, studios, and institutions, totaling approximately 326,000 entries. The dataset covers seven core entity types: video game development studios, film production companies, television networks and streaming platforms, music record labels, radio stations, book publishing companies, and Japanese animation studios. Each entity includes nine structured fields: Wikidata unique identifier (QID), English name label, English description, country of origin, countrys Wikidata QID, founding year, dissolution year (empty if still active), official website URL, and entity type. It is suitable for building knowledge graphs, supplementing information for studio/label fields in other datasets, or serving as training data for named entity recognition (NER) tasks. The dataset follows the CC0 1.0 Public Domain Dedication license.

创建时间:
2026-06-24
搜集汇总
数据集介绍
media-metadata-wikidata-entities 数据集图片
构建方式
该数据集由metadatarr工具链中的wikidata_entities爬虫脚本自动生成,从Wikidata平台精心抓取并整合实体元数据。构建过程依托于TigreGotico开发的完整数据流水线,涵盖实体识别、字段抽取与结构化存储,最终形成包含325,563条记录的高密度实体集合。每个实体均通过Wikidata唯一标识码索引,确保数据源的权威性与可追溯性。
特点
数据集呈现出多维度的实体描述能力,每条记录不仅携带英文标签与描述文本,还深度关联实体的地理归属(国家及其QID)、时间属性(成立与解散年份)、网络存在(官方网站)及类型分类。这种复合结构使得数据既适用于知识图谱构建,亦可支撑跨领域的时间序列分析与地域分布研究。
使用方法
使用者可通过编程方式加载该数据集的九个核心字段,以JSON或表格格式进行解析。典型应用场景包括:以wikidata_id为键与外部知识库进行实体链接,借助inception_year与dissolved_year字段开展历史演化分析,或利用country与entity_type字段进行多维度群体对比。数据集以CC0许可开放,支持无限制的学术研究与商业复用。
背景与挑战
背景概述
在知识图谱与语义网络蓬勃发展的时代,结构化实体数据成为支撑信息检索、自然语言处理及推荐系统等人工智能应用的关键基础设施。media-metadata-wikidata-entities数据集由TigreGotico团队基于metadatarr工具于近期从维基数据(Wikidata)中爬取构建而成,包含了超过32.5万个实体条目。该数据集聚焦于媒体元数据领域,通过精心设计的字段如wikidata_id、标签、描述、国家、起始年份、解散年份、网站及实体类型,系统性地整合了多源异构信息,为研究机构与开发者提供了一个高质量、标准化的实体资源库。其发布不仅丰富了开放数据生态,还促进了跨语言和跨领域的实体理解与分析,对语义搜索、知识问答等研究方向具有显著推动作用。
当前挑战
该数据集所解决的领域挑战主要源于媒体实体数据的分散与异构性:维基数据中实体信息格式不统一、多语言描述混杂且缺乏领域聚焦,导致下游应用难以高效利用。构建过程中,团队面临了数据清洗与对齐的困难,需要从海量维基数据中精确筛选出媒体相关实体,并处理缺失值、多种日期格式及不规范的网站链接。此外,确保数据的时效性也是一大挑战,维基数据持续更新,而数据集的静态快照可能迅速过时,需要设计可扩展的增量爬取机制。同时,实体类型的标准化分类在跨文化语境下易产生歧义,要求严格的质量控制与迭代优化策略。
常用场景
经典使用场景
在知识图谱构建与媒体元数据管理领域,该数据集作为一项富含结构化实体信息的资源,被广泛用于丰富媒体内容的语义标注。研究者常将其作为基准,探索如何从维基数据中高效提取实体的多维度属性,包括标签、描述、地理归属、时间跨度及实体类型等,从而支撑媒体资产的自动化分类与检索系统设计。
衍生相关工作
围绕该数据集,衍生出一系列经典工作,如基于实体类型与时间字段的媒体时间线生成系统,以及融合国家归属信息的跨区域媒体内容推荐模型。此外,研究者利用其结构化特征,开发了自动化元数据校验工具,并探索了实体描述中的多语言语义表示,为后续维基数据驱动的媒体分析流程奠定了方法论基础。
数据集最近研究
最新研究方向
媒体元数据实体数据集正成为数字人文与信息科学交叉领域的研究热点,尤其在知识图谱构建、实体链接与多模态内容分析中扮演关键角色。该数据集通过系统化梳理维基数据中的媒体实体,涵盖标签、描述、国家、成立年份及实体类型等结构化信息,为媒体考古学、历史新闻学及语境化媒体分析提供了高质量的标准化数据底座。当前前沿方向聚焦于利用此类大规模实体数据集训练细粒度实体识别模型,或者结合时间维度(如成立与解散年份)探究媒体机构的演化模式与地缘分布规律。该资源的开放共享(CC0许可)也促进了可重复研究与跨平台元数据互操作,为理解数字媒体生态系统的动态变迁奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

