
US PK–12 Academic Standards & Learning Components Dataset
收藏官方服务:
资源简介:
一个生产级、清洁的PK-12学术标准数据集,涵盖美国所有50个州、华盛顿特区和多州框架,包含数学、英语语言艺术、科学和社会研究四门学科,并嵌入具体的学习组件。
A production-grade, clean PK-12 academic standards dataset covering all 50 U.S. states, the District of Columbia, and multi-state frameworks. It includes four subject areas: mathematics, English Language Arts (ELA), science, and social studies, with embedded specific learning components.
创建时间:
2026-07-21
原始信息汇总
数据集概述
US PK–12 Academic Standards & Learning Components Dataset 是一个生产就绪的数据库,涵盖美国全部50个州、华盛顿特区及多州框架的PK–12学术标准及学习组件。
核心内容
- 学科范围:英语语言艺术(ELA)、数学、科学和社会研究
- 覆盖范围:214个框架,222,340个可达层级条目
- 标准数量:嵌入48,847个已验证技能实例,关联至10,744条标准
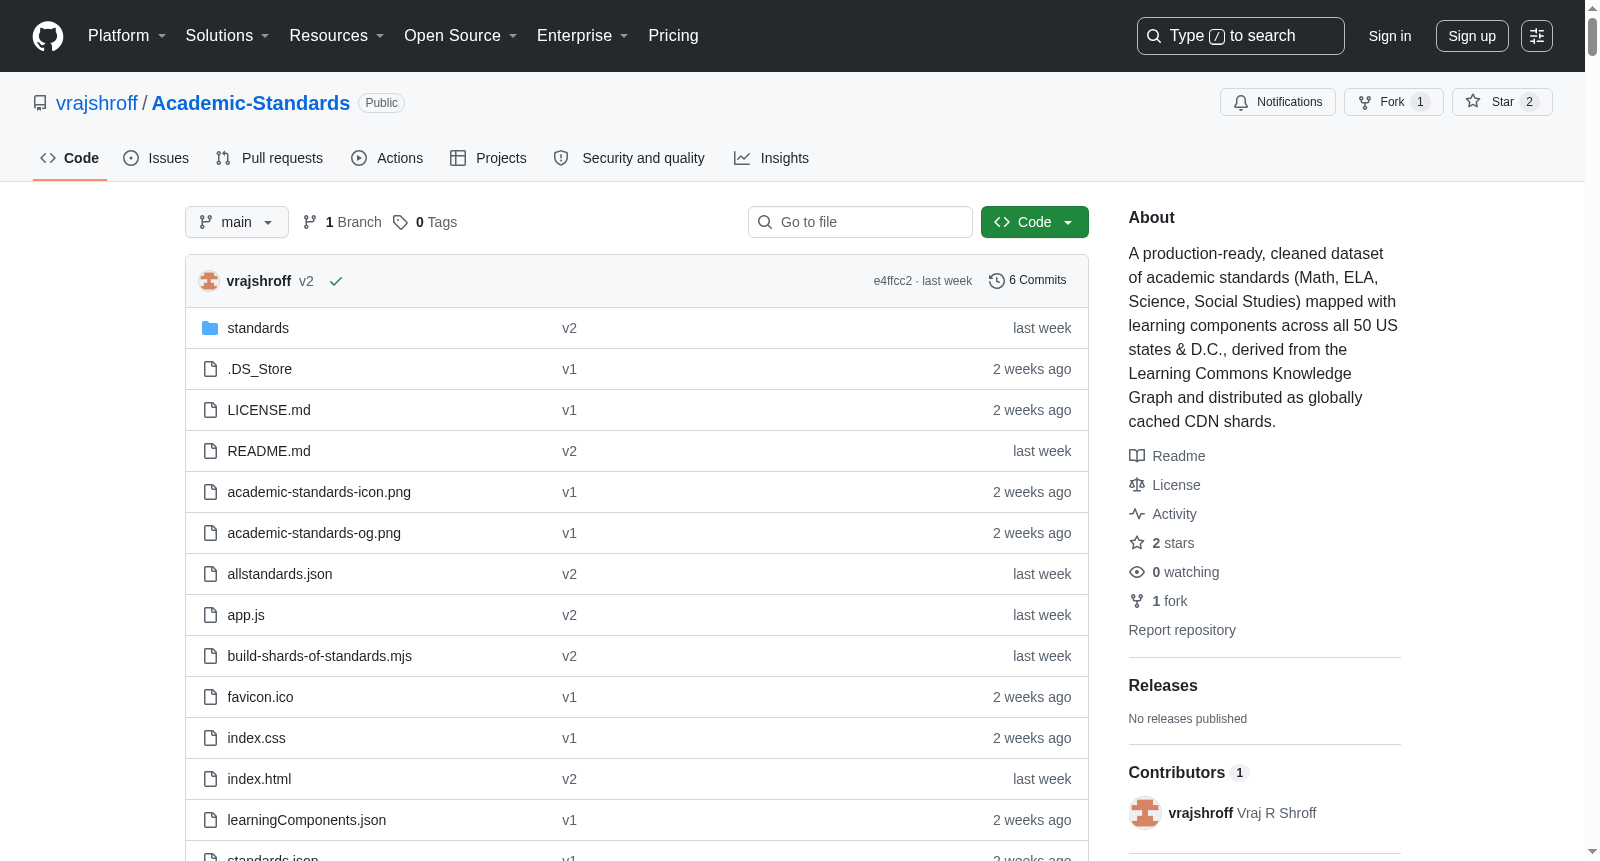
- 数据格式:结构化JSON格式,包含规范化的标准图(allstandards.json)和按州/学科拆分的预编译分片(standards/目录)
关键特性
- 可直接使用:无需解析原始PDF或清理格式,数据以结构化JSON提供
- 可教学学习组件映射:将宽泛的州标准拆分为具体、可操作的学习组件
- CDN就绪且轻量:提供预编译、按管辖区划分的JSON分片,支持客户端按需加载
- 全面修正:程序化清理文本缺陷、移除格式干扰(建模星号、脚注标记)、恢复损坏的数学公式
数据访问方式
- 无代码探索:通过在线Academic Standards Explorer(地址:https://vrajshroff.github.io/Academic-Standards/)可按州、学科、年级浏览、搜索标准及学习组件。
- CDN分片消费(推荐Web应用):通过manifest.json(地址:https://cdn.jsdelivr.net/gh/vrajshroff/Academic-Standards@main/standards/manifest.json)和分片基础URL(https://cdn.jsdelivr.net/gh/vrajshroff/Academic-Standards@main)动态获取数据。
- 直接文件消费(后端/数据科学):加载allstandards.json进行离线分析、数据库播种或后端处理。
数据模式要点
每个分片文件包含:
- frameworks:框架数组,含id、名称、管辖区、学科和子项引用
- items:标准条目字典,每条含类型、代码、标题、适用年级、子项及学习组件列表
数据质量与修复
源数据处理过程中的关键数字:
| 数据指标 | 数量 |
|---|---|
| 源节点记录已读取 | 247,786 |
| 源关系记录已读取 | 456,620 |
| 当前框架数 | 214 |
| 修复后可达条目数 | 222,340 |
修复措施包括:
- 6,022条记录进行了策划字段修正(标题、年级、标准代码、备注等)
- 143条记录进行了定向文本修正(恢复缺失代数变量、数学表达式等)
- 2,838条标准代码格式修复
- 39,943条记录的标题或备注与原始导出存在差异
- 19.72%(约43,841条)发布记录在修复或规范化过程中被修改,涵盖内容更正与展示格式转换(如移除HTML标签、解码实体、转换LaTeX等)
适用场景
- 构建教育平台(标准选择、教案构建器、进度仪表盘)
- 课程与内容映射(自动对齐教材、在线课程、视频、评估题目至官方要求)
- 创建自适应学习路径(利用细粒度学习组件映射推荐练习材料)
- 生成分析与报告(设计标准对齐的进度报告和覆盖范围分析)
搜集汇总
数据集介绍
构建方式
该数据集旨在解决美国各州官方学术标准格式不一、内容杂乱的问题,通过系统化的数据清洗与结构化处理,构建了一个覆盖全美50个州、华盛顿特区及多州共同框架的综合性标准数据库。其构建过程基于Learning Commons的节点与关系导出数据,历经详尽的修复流程,包括对标题、年级、标准代码等字段进行人工校验与修正,应用规则化清洗策略以移除HTML标签、修复Unicode字符及恢复数学公式,并剔除无效或重复条目。最终,数据集整合了214个框架,包含222,340个可达层级条目,并将48,847项经过验证的技能点直接嵌入10,744条相关标准中,形成了统一的JSON格式标准图谱。
特点
该数据集的核心特点在于其高度的结构化、精细化的学习组件映射以及即用性。它将宽泛的州级标准分解为具体的、可操作的学习组件,为教学规划与个性化学习提供了粒度支撑。数据经过彻底的文本矫正与格式清理,确保了内容的准确性与可读性,同时恢复了损坏的数学表达式。此外,数据集提供了预编译的、按州和学科划分的JSON分片,支持通过CDN按需加载,轻量高效,适合前端应用直接集成。其覆盖范围广泛,横跨数学、科学、英语语言艺术和社会研究四大核心学科,为教育科技产品开发、课程对齐及学习分析提供了可靠的数据基础。
使用方法
数据集的获取方式灵活多样,旨在满足不同技术背景用户的需求。非开发者可直接通过在线学术标准浏览器(Academic Standards Explorer)交互式探索数据,无需编程。对于开发者,推荐采用CDN分片消费模式,通过访问manifest.json清单文件定位并获取特定州和学科的JSON数据分片,便于在Web或移动应用中集成。该方式支持前端框架如React的快速接入,并提供了完整的示例代码。对于需要批量处理的后端或数据科学场景,用户可直接下载并解析完整的allstandards.json文件,通过标准ID查找具体条目及其关联的学习组件,便于进行离线分析、数据库填充或构建自适应学习路径。
背景与挑战
背景概述
美国PK-12学术标准与学习组件数据集由Vraj Shroff等人创建,旨在系统化整合美国50个州、华盛顿特区及多州框架的PK-12学术标准,涵盖数学、科学、英语语言艺术和社会研究四大核心学科。该数据集的核心研究问题是解决官方标准在格式、质量和可操作性上的碎片化问题,通过结构化JSON格式提供统一的、经过清洗的标准图谱,并嵌入48,847个可验证的技能点于10,744条标准中。其影响力体现在为教育技术开发者、课程设计者及政策研究者提供了便捷的数据访问途径,显著降低了标准解析和清洗的门槛,推动了精准教学、自适应学习及教育分析等领域的发展。
当前挑战
该数据集面临的挑战主要源于源数据的复杂性与构建过程的艰巨性。领域层面,官方标准常以PDF等非结构化格式发布,存在OCR错误、格式混用及过于宽泛难以直接指导教学等问题,本数据集需将抽象标准映射为具体可操作的学习组件,以实现教育应用的可落地性。构建过程中,需处理超过24万条源记录和45万条关系,面临文本缺陷、标记残留、数学公式损坏及层级断裂等多重问题,通过程序化清洗与人工校正相结合,对约19.72%的记录进行了修正,包括字段纠正、文本修复、层级恢复等,耗时且需高精度验证,确保数据的准确性与一致性。
常用场景
经典使用场景
该数据集为教育技术(EdTech)领域的研究与实践提供了一站式、结构化的PK–12学术标准资源,覆盖全美50州、华盛顿特区及多州共同框架,涵盖数学、科学、英语语言艺术和社会研究四大学科。其经典应用场景聚焦于课程映射与学习路径构建:研究者与开发者可借助其规范的JSON格式及细粒度的学习组件映射,将晦涩冗杂的官方标准转化为可操作的技能清单,从而支撑个性化学习推荐、能力缺口分析与教学进度追踪等核心功能,有效弥合了标准表述与课堂实践之间的鸿沟。
衍生相关工作
该数据集衍生了一系列开创性工作,尤其在教育知识图谱构建与标准自动对齐领域。其清洗流程中记录的详细修复策略(如针对2,838个标准代码的格式修复及151个标题的精确复原)为后续研究提供了可复现的基准方法论。基于此,已有研究探索将学习组件映射至认知层次模型,用于自动生成评估题目;亦有工作利用标准与技能的关联关系,训练机器学习模型以预测跨州标准的语义等价性。此外,数据集中的层级结构促进了课程资源与标准间自动匹配算法的开发,推动了开放教育生态下内容互操作性的标准化进程,成为教育数据科学领域的重要参考资源。
数据集最近研究
最新研究方向
美国K-12学术标准数据集的构建与应用研究正趋向于精细化与智能化,该数据集通过清洗整合全美50州及华盛顿特区的数学、科学、英语语言艺术和社会研究标准,将宽泛的标准分解为可操作的技能点,为自适应学习路径的构建提供了数据基础。当前研究热点聚焦于利用此类结构化标准数据驱动教育技术产品的开发,如智能课程映射、个性化练习推荐及学习进度追踪。同时,也推动了教育数据科学的发展,为政策制定者提供标准对齐的评估分析工具。该数据集的发布标志着教育数据治理向前迈进了一大步,其完整性和可访问性将重塑教育技术生态,加速基于标准的教学实践向数字原生模式的转型。
以上内容由遇见数据集搜集并总结生成


