
Xiaoc2026/anime-dataset-v1.0
收藏搜集汇总
数据集介绍
构建方式
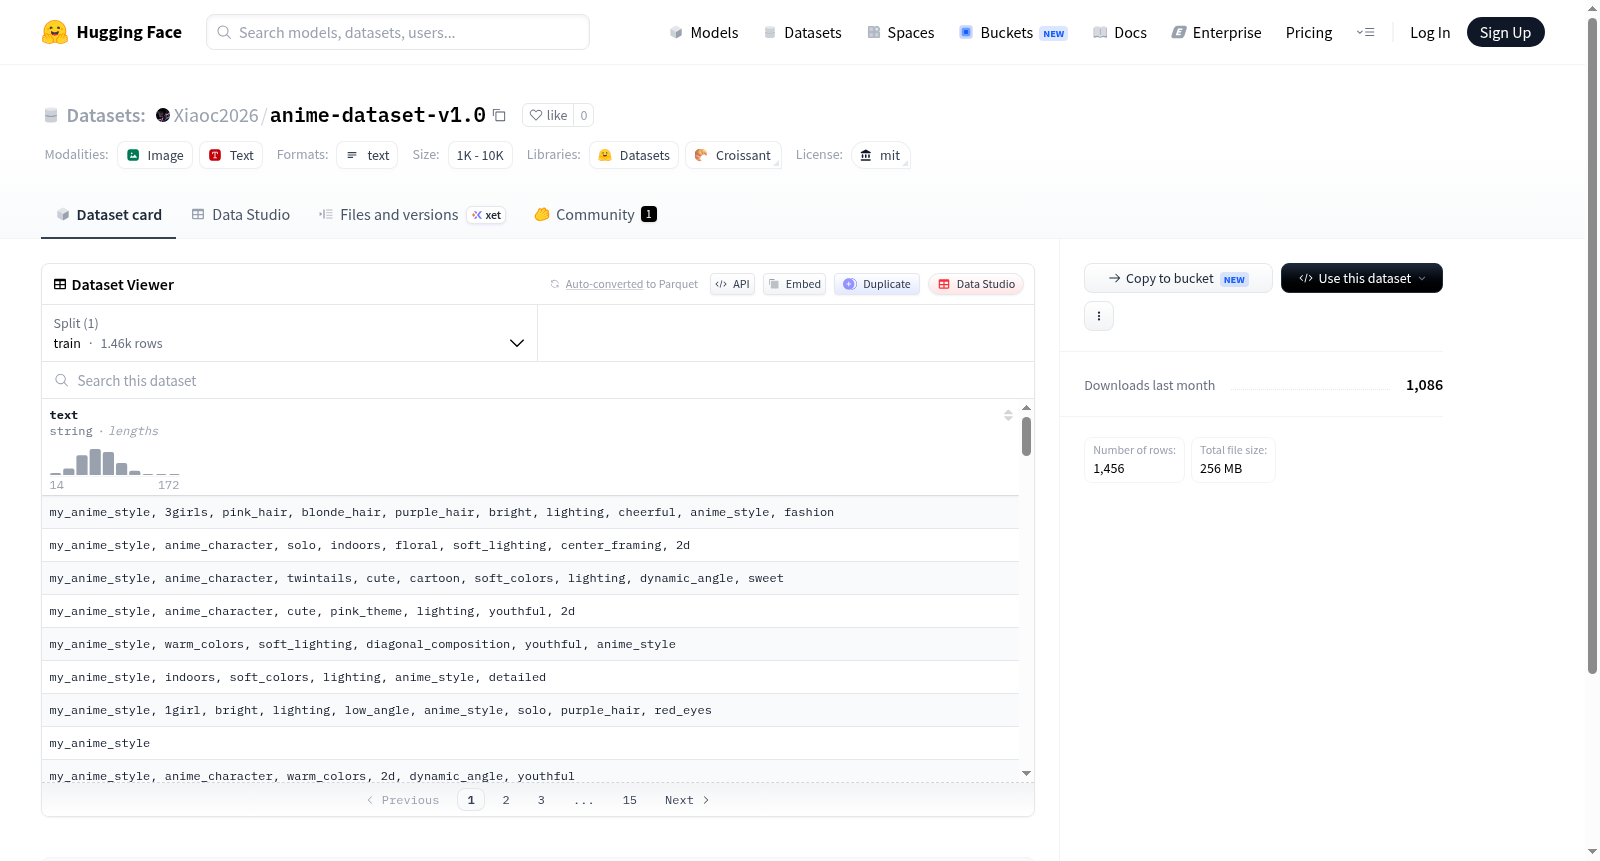
anime-dataset-v1.0是一个专注于动漫领域的数据集,其构建旨在为动漫图像生成、风格迁移及相关视觉任务提供标准化训练资源。该数据集依托开源社区资源,通过系统化收集和整理大量动漫风格图像而成,并采用MIT许可证发布以确保广泛可用性。构建过程中,数据被统一处理为适合深度学习模型输入的格式,并附有元数据以便于分类与检索,从而提升模型在不同动漫风格与角色上的泛化能力。
特点
该数据集的核心特点在于其专注性与开放性。一方面,它高度聚焦于动漫图像这一特定视觉领域,避免了自然图像与动漫图像的混用问题,为专门任务提供了纯净的数据源。另一方面,MIT许可证赋予了用户最大的自由度,允许在学术研究、商业应用乃至二次分发中无限制使用,这极大地促进了动漫AI技术的共享与迭代。数据集规模经过精心设计,在保证样本多样性的同时兼顾了计算效率。
使用方法
使用方法上,anime-dataset-v1.0可直接导入至基于PyTorch或TensorFlow的深度学习框架中。用户可通过HuggingFace Datasets库加载该数据集,并配合transformers等库中的预训练模型进行微调,如用于动漫图像生成或风格转换。建议用户在训练前对图像进行标准化预处理,如统一尺寸与归一化,以匹配模型输入要求。该数据集特别适合用于训练生成对抗网络(GANs)或扩散模型,以生成高质量的动漫风格图像。
背景与挑战
背景概述
动漫图像数据集作为计算机视觉与多媒体内容理解领域的重要资源,为风格迁移、生成式模型及细粒度分类等研究提供了丰富的素材。anime-dataset-v1.0 由研究机构或社区贡献者创建,旨在构建一个大规模、高质量、标注统一的动漫图像集合。该数据集覆盖多种画风、角色与场景,核心研究问题聚焦于提升模型对动漫内容的理解与生成能力,尤其在生成对抗网络(GAN)及扩散模型的应用中发挥关键作用。其发布对推动非写实视觉内容的自动化分析、检索及创意生产具有显著影响力。
当前挑战
当前领域的核心挑战在于动漫图像的风格高度多样与标注一致性难以保障。不同创作者与流派之间的视觉特征差异巨大,使得模型泛化面临严峻考验。同时,数据集的规模与质量之间需达成平衡,采集过程中版权问题与图像筛选增加了构建难度。此外,缺乏统一的评价指标来量化生成内容的真实性与艺术性,也是该数据集持续演进中亟待解决的瓶颈。
常用场景
经典使用场景
动漫数据集 anime-dataset-v1.0 凭借其丰富多元的动漫图像资源,在计算机视觉与多媒体分析领域中,成为训练图像生成模型、风格迁移网络以及动漫角色识别系统的基石。研究者常利用该数据集进行条件生成对抗网络(Conditional GAN)的微调,以产出具有特定画风的动漫人物图像。同时,它也广泛用于训练基于Transformer架构的文本到图像扩散模型,推动着二次元内容自动化创作的边界。
实际应用
在实际应用中,anime-dataset-v1.0 支撑了诸多文创产业的智能化升级,例如在数字娱乐领域,它为游戏与动画公司提供了批量生成角色立绘与场景原画的能力。一些社交应用通过基于此数据集训练的模型,实现了用户上传照片的动漫化滤镜功能,显著提升了用户体验。在影视制作中,它还被用于辅助编剧进行故事板的概念草图绘制,加速了创意从文字至视觉的转化流程。
衍生相关工作
基于该数据集,衍生出了诸多里程碑式的研究工作,例如致力于高保真动漫风格迁移的 AnimeGAN 系列,以及专门针对动漫头像超分辨率重建的 Real-ESRGAN-anime 变体。同时,它也催生了面向二次元图像的序列化标注工具和评测基准,如 Danbooru 标签系统与此数据集结合的成果,进一步推动了语义理解在亚文化视觉数据上的发展。这些工作不仅丰富了动漫AI的研究生态,也反哺了通用图像理解算法的迭代。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


