keratin-mech-seq-ss-md-properties
收藏资源简介:
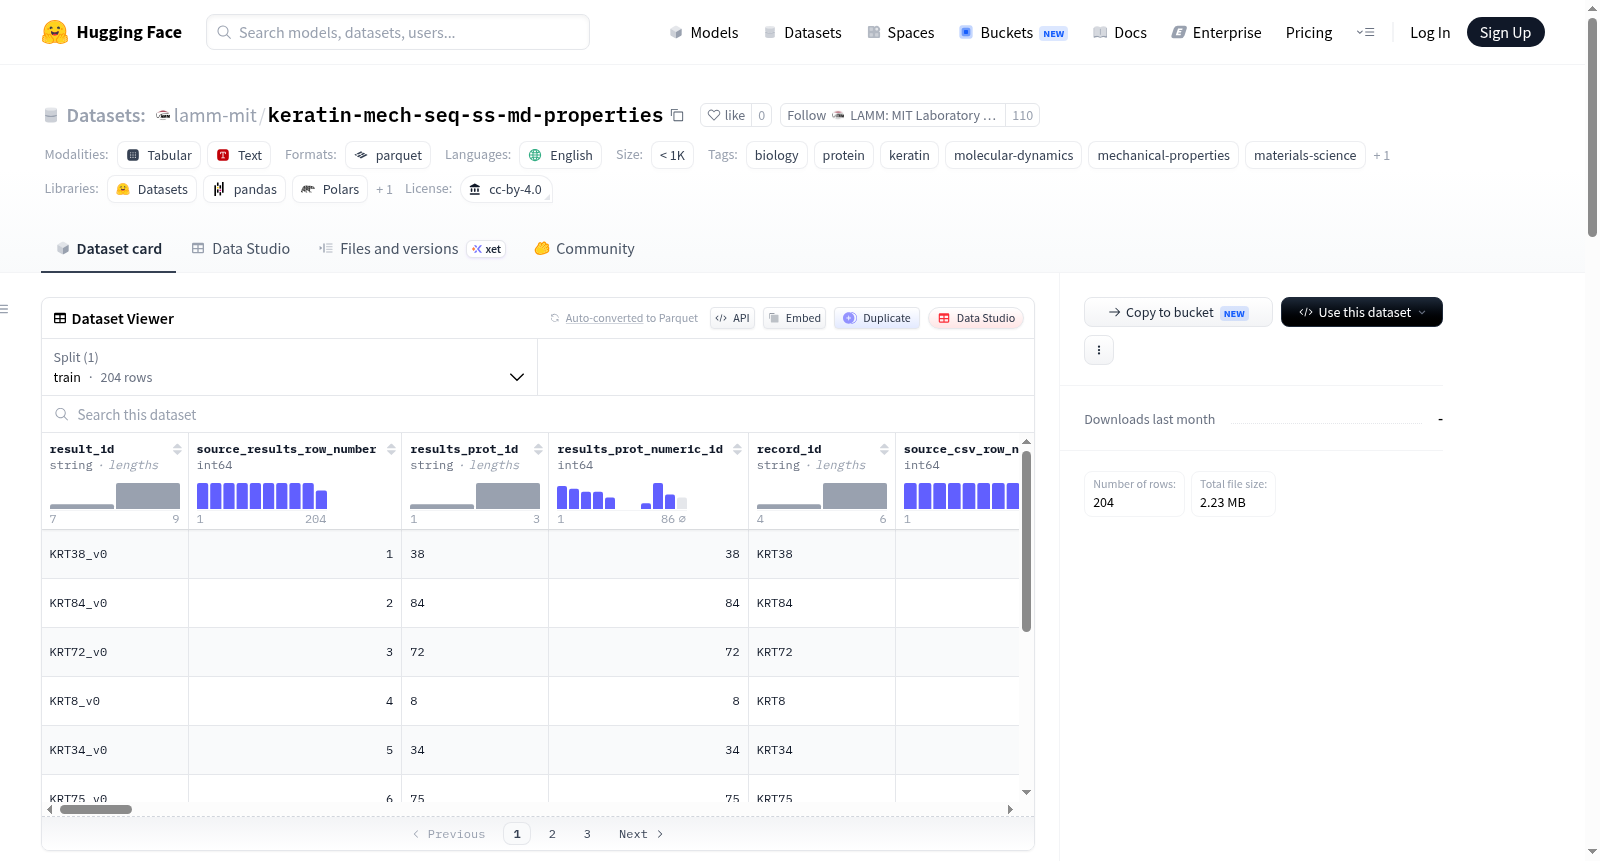
该数据集是一个关于人类角蛋白机械性能、序列特征和分子动力学特性的综合数据集。数据集包含51种人类角蛋白单体(100个I型,104个II型)在四种不同拉伸速度(v0-v4)下的分子动力学模拟结果,共计204条记录。每条记录包含蛋白质的序列信息(氨基酸长度范围394-644,中位数493)、机械性能指标(强度范围749.59-1799.58,韧性范围449074.07-2086165.54)、分子特性(分子量、不稳定指数、等电点、溶剂可及表面积)、二级结构组成(结晶度、结构转变、氢键变化、持久长度)以及详细的力向量数据。数据来源于UniProtKB序列记录和AlphaFold Database结构预测,通过NAMD软件使用CHARMM力场和广义Born隐式溶剂模型进行分子动力学模拟生成。该数据集适用于蛋白质力学特性研究、材料科学分析、生物信息学模型训练以及角蛋白相关生物力学应用。
This dataset is a comprehensive collection of human keratin mechanical properties, sequence features, and molecular dynamics characteristics. It includes molecular dynamics simulation results for 51 human keratin monomers (100 Type I, 104 Type II) under four different stretching speeds (v0-v4), totaling 204 records. Each record contains protein sequence information (amino acid length range 394-644, median 493), mechanical performance indicators (strength range 749.59-1799.58, toughness range 449074.07-2086165.54), molecular properties (molecular weight, instability index, isoelectric point, solvent accessible surface area), secondary structure composition (crystallinity, structural transitions, hydrogen bond changes, persistence length), and detailed force vector data. The data is sourced from UniProtKB sequence records and AlphaFold Database structure predictions, generated through molecular dynamics simulations using NAMD software with the CHARMM force field and generalized Born implicit solvent model. This dataset is suitable for research on protein mechanical properties, materials science analysis, bioinformatics model training, and keratin-related biomechanical applications.
数据集名称
Human Keratin Mechanical, Sequence, SS, and MD Properties(人类角蛋白力学、序列、二级结构及分子动力学性质数据集)
基本信息
- 存储位置:
lamm-mit/keratin-mech-seq-ss-md-properties - 记录数:204 条
- 生物体:智人(Homo sapiens, NCBI:txid9606)
- 角蛋白类型计数:I型 100 条,II型 104 条
- 序列长度范围:394–644 个氨基酸
- 序列长度中位数:493.0
- 独特蛋白质数:51 种
- 不同拉伸速度行数:每个蛋白质包含 v0、v1、v2、v4 四种速度条件,各 51 条
- 强度范围:749.59–1799.58
- 韧性范围:449074.07–2086165.54
- 标注的序列字符串冲突记录:KRT17、KRT26
- 标注的序列长度/字符串冲突记录:KRT17、KRT26
- 生成时间:2026-06-05T15:18:17.881347+00:00
许可协议
- CC BY 4.0
数据字段
每条记录包含以下类别信息:
result_id与KRT record_id- 拉伸速度条件
- 蛋白质序列及来源匹配标志
- 力向量、原始力向量文本、校验和及向量统计量
- 强度、韧性、归一化强度、归一化韧性
- 分子量、不稳定指数、等电点、溶剂可及表面积(SASA)
- 氨基酸计数/百分比、二级结构组成
- 结晶度、二级结构转变、氢键变化、持续长度
- 记录来源与校验和字段
数据生成方法
- 序列描述符:采用 ProtParam 风格计算,包括序列长度、分子量、不稳定指数、等电点。
- 结构描述符:从折叠结构及模拟轨迹计算,包括 SASA、结晶度、二级结构组成、转变计数、氢键变化、持续长度。
- 分子动力学模拟:使用 NAMD 软件、CHARMM 力场及广义 Born 隐式溶剂模型(GBIS),进行隐式原子模拟。每个蛋白质先经最小化和平衡,再进行拉伸分子动力学(SMD)。模拟中固定一端,对另一端施加拉伸力直至达到估计的轮廓长度,采用四种加速拉伸速度:0.1、0.125、0.15、0.175 Å/ps。
- 力学性质提取:力-位移响应结果中,强度定义为最大展开力,韧性定义为力-位移曲线下面积。力迹线通过分段平均重采样至蛋白质序列长度,生成每个残基长度的力向量。数据集包含全部 204 次运行的归一化强度与韧性值。
数据来源与引用
- 序列记录:链接至 UniProtKB。
- 结构记录:链接至 AlphaFold 数据库条目。
- 版权说明:UniProt 数据库可版权部分以 CC BY 4.0 提供;AlphaFold 数据库数据以 CC BY 4.0 提供,可用于学术和商业用途。
- 引用建议:使用时应引用 UniProt、AlphaFold 数据库及配套的角蛋白展开力学论文。
数据验证说明
上传流程检查了以下项目:唯一记录标识符、预期的 I 型/II 型覆盖、各速度组的模拟输出、序列长度、力向量长度、内部 PDB 残基/SEQRES 一致性。每个记录的布尔字段保留已知的源序列冲突标志,而非静默覆盖。