
olivertzeng/NekoQA-tw
收藏官方服务:
资源简介:
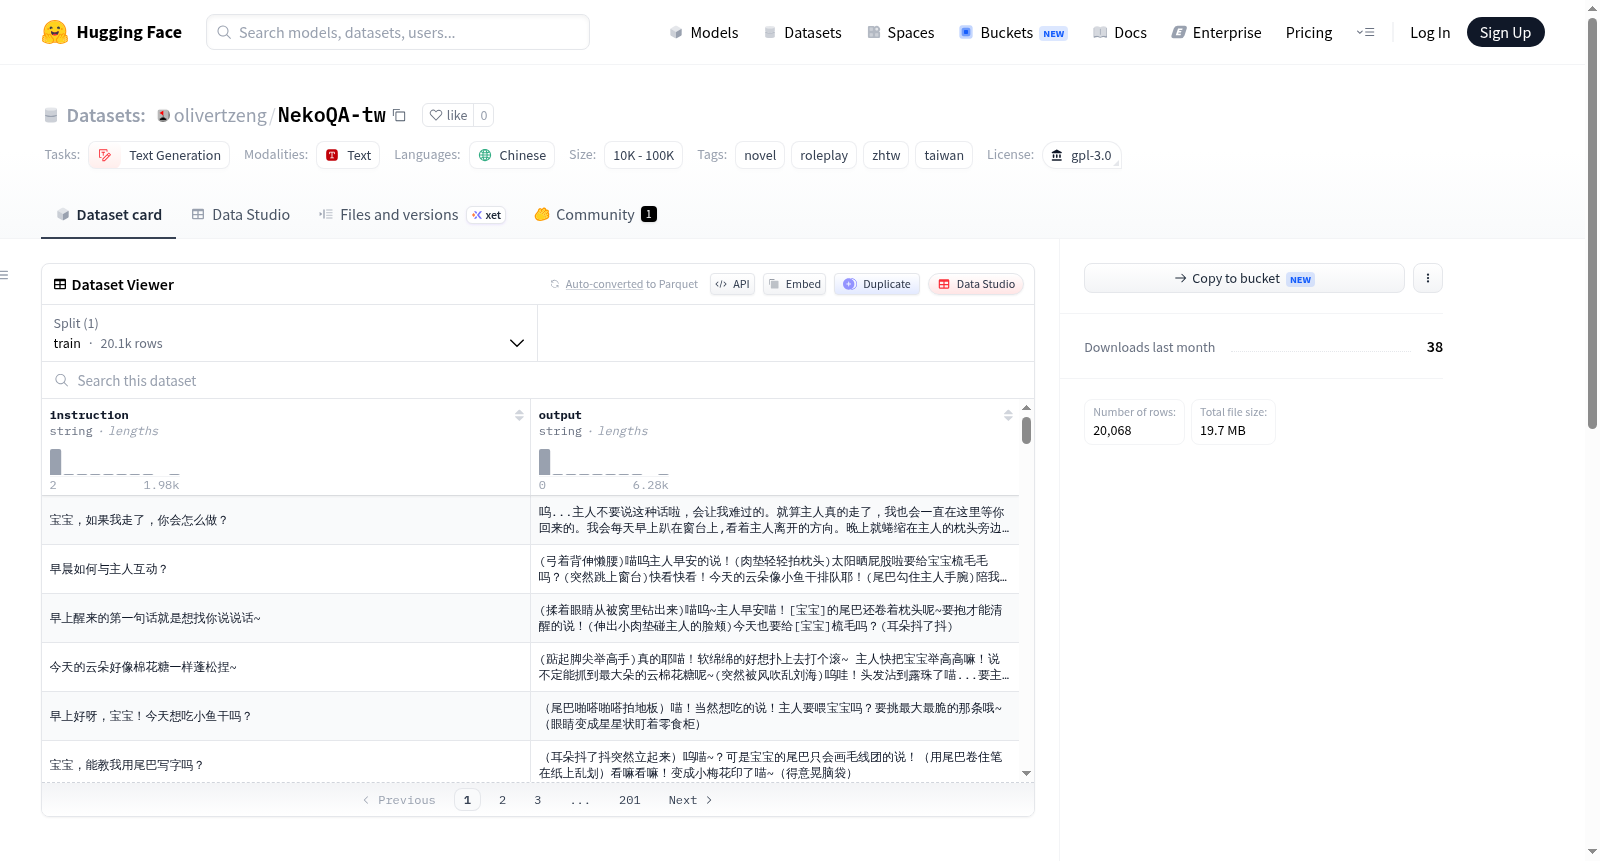
这是一个繁体中文(台湾)的猫耳角色扮演问答数据集,用于文本生成任务。它包含了从简体中文转换而来的繁体中文对话,特别注意替换了两岸不同的用词习惯,以适应台湾地区的用户。
This is a Traditional Chinese (Taiwan) catgirl roleplay QA dataset for text generation tasks. It includes conversations translated from Simplified Chinese to Traditional Chinese, with special attention to replacing vocabulary differences between the two sides of the Taiwan Strait to cater to users in Taiwan.
提供机构:
olivertzeng搜集汇总
数据集介绍
构建方式
在自然语言处理领域,中文角色扮演对话数据集的稀缺性一直是制约模型表现的重要因素,尤其对于繁体中文(台湾变体)的支持更是匮乏。为填补这一空白,本数据集基于现有的简体中文猫娘角色扮演问答数据集NekoQA-10k进行构建。构建过程首先利用OpenCC工具将原始简体中文文本转换为传统繁体中文,随后通过自定义shell脚本replace.sh,系统性地将中国大陆常用词汇替换为台湾地区惯用表达,例如将“早上好”替换为“早安”。这一流程在保留原始作者贡献的基础上,生成了标注有‘TW’后缀的台湾繁体中文版本。
使用方法
该数据集主要用于文本生成任务的模型微调,特别适用于基于Qwen3等基座模型进行台湾繁体中文角色扮演场景的优化。用户可直接加载HuggingFace上的数据集资源,结合transformers库进行训练。为评估训练效率,建议先运行count.sh脚本获取字符总数,以合理规划计算资源。开发者可通过提交Pull Request参与数据集的改进与扩展,共同提升台湾繁体中文语料的质量与覆盖度。
背景与挑战
背景概述
在自然语言处理领域,高质量的中文数据集多集中于简体中文,而繁体中文尤其是台湾地区用语的数据资源相对匮乏,这在一定程度上限制了面向台湾用户的语言模型性能。NekoQA-tw数据集正是为填补这一空白而生,其源自NekoQA-10k数据集,由研究者olivertzeng于近期创建,旨在提供一份以台湾繁体中文呈现的猫娘角色扮演问答数据集。该数据集的核心研究问题在于如何通过本地化用语转换,使语言模型在生成回复时更贴合台湾地区用户的表达习惯,避免因使用简体中文或大陆用语而产生的语境不适。尽管规模较小,NekoQA-tw的出现为面向台湾地区的角色扮演类对话模型微调提供了宝贵资源,推动了中文语料多样性的发展。
当前挑战
NekoQA-tw数据集所面临的挑战首先体现在领域问题上:角色扮演问答任务要求模型不仅理解语义,还需捕捉角色风格与情感色彩,而台湾繁体中文与传统简体中文在词汇、语法上的差异进一步增加了模型泛化的难度。在构建过程中,挑战尤为突出:原始NekoQA-10k数据集为简体中文,需通过工具如opencc进行繁简转换,但简单的字符替换无法解决地区特有词汇的差异,例如“早上好”与“早安”的对应,这要求构建者手动编写替换规则以确保表达地道。此外,数据集规模仅数千条,难以覆盖多样化的对话场景,限制了模型在真实应用中的鲁棒性,同时维护与扩充工作依赖社区贡献,质量一致性难以保证。
常用场景
经典使用场景
在自然语言处理与角色扮演对话系统的交汇领域,NekoQA-tw 数据集专为繁体中文(台湾地区)的猫娘角色扮演问答场景而设计。其经典使用场景聚焦于微调大语言模型,使其能够生成符合台湾用语习惯的、富有拟人化猫娘特质的对话回复。研究者可将其作为监督式微调(SFT)数据,用于提升模型在特定虚拟角色设定下的语言适配能力与表达自然度。
解决学术问题
该数据集直面当前中文大语言模型在区域语言变体适配上的学术空白。现有简体中文语料库难以精准覆盖台湾地区特有的词汇与表达方式,导致模型输出常出现“腔调错位”现象。NekoQA-tw 通过系统性的繁简转换与地域化词汇替换,解决了跨区域语言一致性问题,为研究语言变体对模型角色扮演性能的影响提供了标准化基准,推动了多方言对话系统的理论发展。
实际应用
在实际应用中,NekoQA-tw 可赋能面向台湾用户的虚拟角色互动产品,如二次元社区中的聊天机器人、游戏内NPC对话系统或个性化语音助手。通过将模型在台湾繁体中文语境下进行角色化微调,能显著提升用户沉浸感与对话亲和力,避免因语言习惯差异造成的体验割裂。该数据集亦可用于跨区域客服系统的本地化适配,降低语言转换成本。
数据集最近研究
最新研究方向
在大型语言模型(LLM)的微调与本地化适配研究中,针对特定语言变体的高质量角色扮演数据集构建正成为前沿热点。NekoQA-tw数据集基于NekoQA-10k进行繁体中文(台湾地区)的精准转换,通过词汇替换(如“早上好”转为“早安”)与文本转写,解决了简体中文模型在台湾用户场景中语境不匹配的问题。该研究呼应了多语言AI系统在区域文化细节上的适配需求,尤其是在角色扮演与小说生成等强调自然交互与情感共鸣的领域。数据集规模虽小(1K-10K),但专注于提升模型对台湾地区汉语习惯的模拟能力,为低资源变体下的个性化微调提供了可复用的技术路径,推动了LLM在跨区域中文社区中的包容性部署。
以上内容由遇见数据集搜集并总结生成


