
svjack/ShareGPT-computer-en-zh-26k
收藏官方服务:
资源简介:
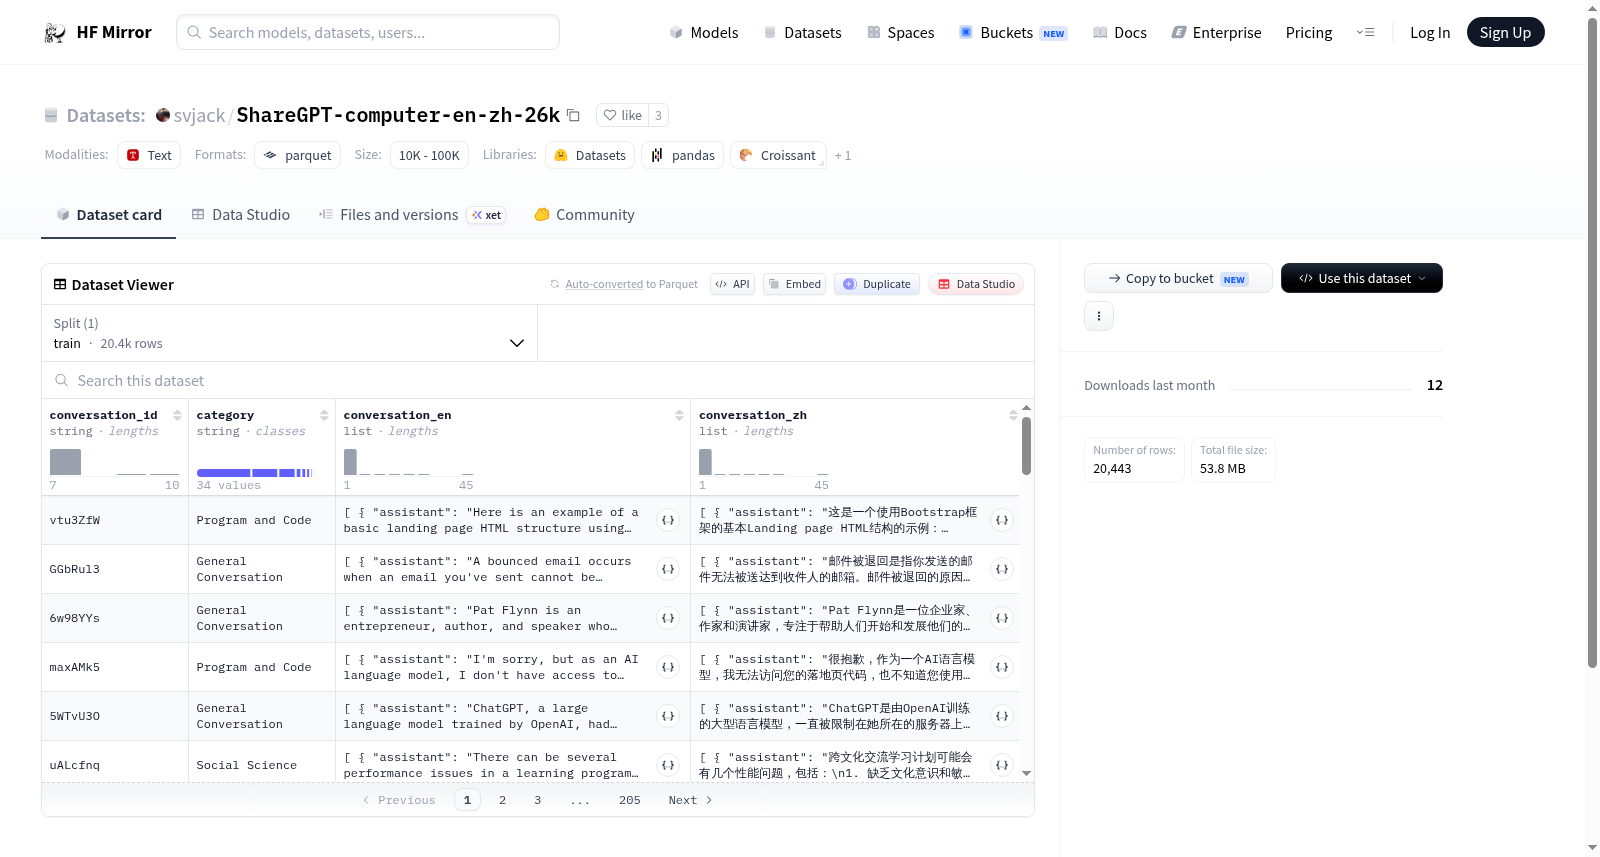
--- dataset_info: features: - name: conversation_id dtype: string - name: category dtype: string - name: conversation_en list: - name: assistant dtype: string - name: human dtype: string - name: conversation_zh list: - name: assistant dtype: string - name: human dtype: string splits: - name: train num_bytes: 102648417 num_examples: 20443 download_size: 53783044 dataset_size: 102648417 configs: - config_name: default data_files: - split: train path: data/train-* ---
The dataset includes conversation IDs, categories, English conversations, and Chinese conversations. Each conversation feature contains dialogues from both the assistant and the human. The dataset is divided into a training set with 20443 examples, totaling 102648417 bytes.
提供机构:
svjack原始信息汇总
数据集概述
数据集特征
- conversation_id: 数据类型为字符串。
- category: 数据类型为字符串。
- conversation_en: 包含两个子特征
- assistant: 数据类型为字符串。
- human: 数据类型为字符串。
- conversation_zh: 包含两个子特征
- assistant: 数据类型为字符串。
- human: 数据类型为字符串。
数据集划分
- train: 训练集,包含20443个样本,总大小为102648417字节。
数据集大小
- 下载大小: 53783044字节。
- 数据集总大小: 102648417字节。
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集包含约2万条中英双语对话,源自ShareGPT平台,涵盖编程、科学、日常交流等多个领域,每对对话提供英文和中文版本,适合用于训练多语言对话模型或机器翻译任务。
以上内容由遇见数据集搜集并总结生成


