
ShahzebKhoso/local-code-arena-starcoder2_3b
收藏官方服务:
资源简介:
该仓库存储了针对下一代StarCoder2 3B基础基础模型运行大多数基本Python问题(MBPP)基准测试所捕获的原始评估指标、执行遥测日志和结构语法输出。此特定分区记录了现代原始基础权重在自动对话管道内的行为动态,突显了指令对齐层的持续必要性。
This repository hosts the raw evaluation metrics, execution telemetry logs, and structural syntax outputs captured from running the Mostly Basic Python Problems (MBPP) benchmark against the next-generation StarCoder2 3B base foundational model. This specific partition documents the behavioral dynamics of modern raw foundational weights inside automated conversational pipelines, highlighting the persistent necessity of instruction-alignment layers.
提供机构:
ShahzebKhoso搜集汇总
数据集介绍
构建方式
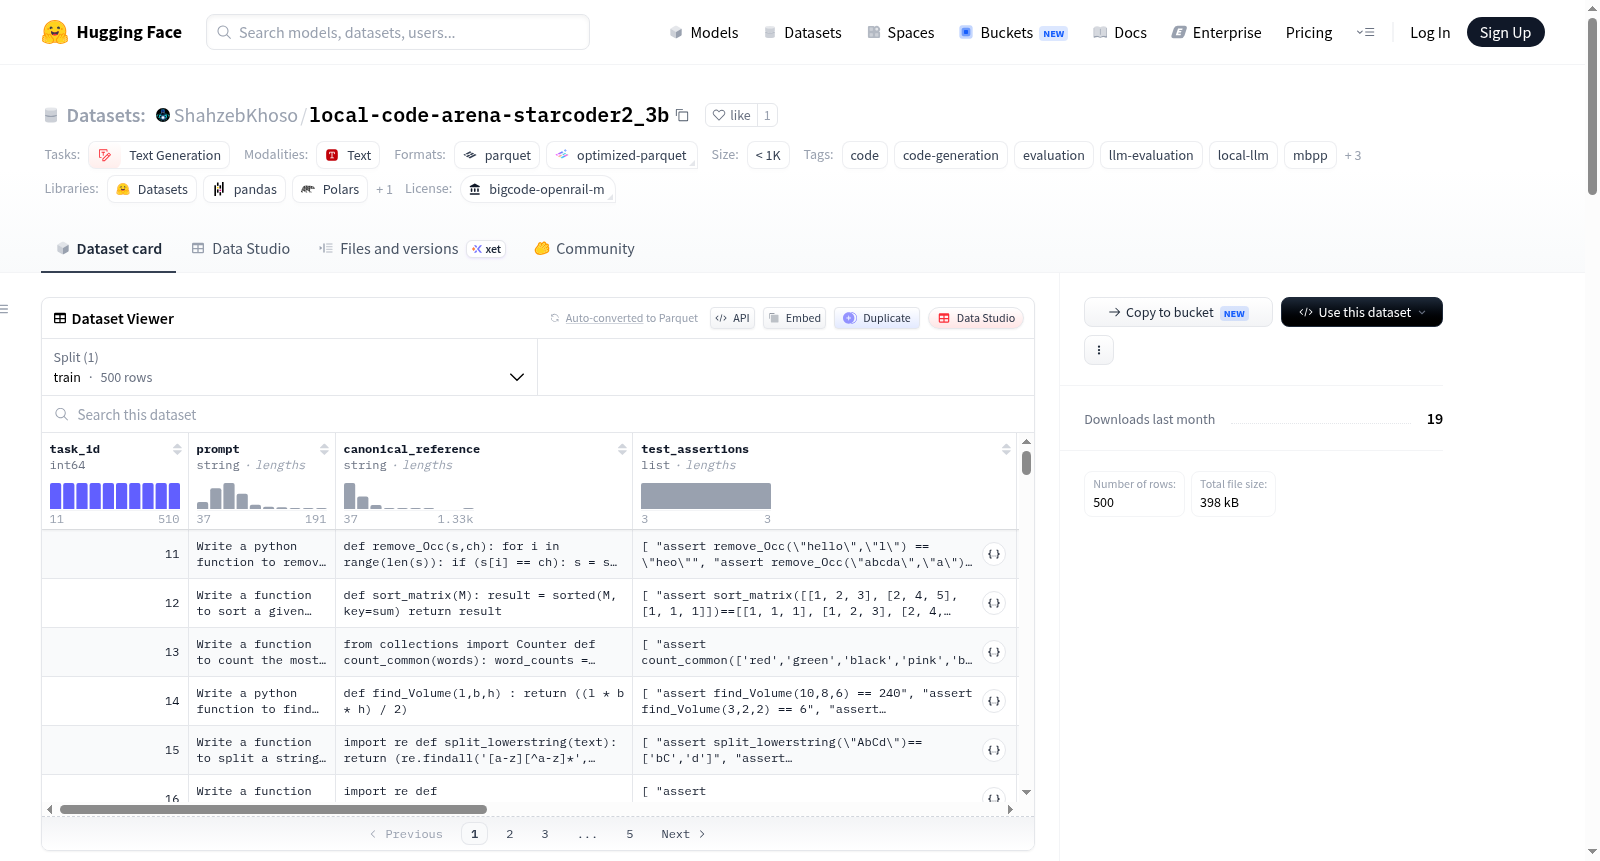
该数据集记录了在StarCoder2 3B基础模型上运行Mostly Basic Python Problems基准测试所获得的原始评估指标、执行遥测日志与结构语法输出。每个数据条目代表一个完整的代码生成实例,包含任务ID、输入提示、标准参考解、测试断言、模型元数据、原始生成文本、提取后的代码块及详细的评估指标。所有遥测数据均在单一本地环境上编译完成,硬件配置为搭载NVIDIA GeForce RTX 4090笔记本电脑GPU的Alienware m18性能笔记本,通过多线程Python代码执行沙箱进行隔离运行,并设置了2.0秒硬性超时限制。
使用方法
用户可通过Hugging Face的datasets库便捷地将该遥测数据集加载至本地评估分析流程中。具体操作为使用load_dataset函数从指定仓库标识符直接流式读取数据,随后可访问每条记录的各字段,例如通过索引获取第一条训练数据,并提取其评估指标中的生成速度字段。数据集以Parquet格式存储,各列字段类型明确,便于进行结构化的代码生成性能比较与分析工作。
背景与挑战
背景概述
在大语言模型(LLM)驱动的代码生成领域,基础模型与指令微调模型之间的性能鸿沟一直是研究焦点。2024年,由BigCode社区与NVIDIA等机构合作研发的StarCoder2系列模型,旨在通过大规模代码预训练推动代码智能的边界。本数据集“local-code-arena-starcoder2_3b”由研究者Shahzeb Khoso构建,专注于评估StarCoder2 3B基础模型在“Mostly Basic Python Problems”(MBPP)基准上的原始表现。该数据集系统性记录了模型在本地硬件上的执行遥测、语法结构与功能正确性指标,揭示了未经对齐的尖端基础架构在零样本指令生成任务中的根本性局限,为后续探索指令对齐层的必要性提供了关键实证依据。
当前挑战
该数据集所应对的核心挑战在于:未经指令对齐的下一代基础代码模型在遵循自然语言指令进行代码生成时表现极差,在MBPP基准上仅取得0.2%的Pass@1准确率。这暴露了现有预训练范式与零样本对话式代码生成之间的结构性不兼容。同时,构建过程面临多重技术难题——需在受限的笔记本电脑GPU环境(RTX 4090 16GB)下稳定执行500项任务的推理与沙箱隔离,确保2秒硬超时限制下精准捕获生成速度(约185 TPS)与执行反馈,并高效提取被对话式文本包裹的原始代码块以进行结构对齐评分。
常用场景
经典使用场景
在代码生成与大型语言模型评估领域,该数据集作为一项基准测试记录,专门用于衡量未经指令微调的原始基础模型在编程任务上的表现。其经典使用场景在于,通过将StarCoder2 3B基础模型应用于MBPP(Mostly Basic Python Problems)评测集,系统性地捕获模型生成的原始代码、执行结果及运行时反馈。研究者可利用此数据集深入剖析基础模型在零样本环境下的代码生成质量、生成速度与语法结构完整性,尤其适用于研究预训练阶段架构特性与下游任务对齐能力之间的鸿沟。
解决学术问题
该数据集精准聚焦于一个核心学术问题:原始基础模型在缺乏指令对齐层的情况下,能否有效理解自然语言描述的编程需求并输出可执行代码。通过提供详尽的执行遥测数据,它揭示了高级架构预训练与零样本指令遵循能力之间的显著不匹配,量化了模型在功能性通过率上的极端低下(Pass@1仅为0.2%),从而强调了指令微调在弥合这一差距中的关键作用。这一发现对于理解大型语言模型的能力边界、推动对齐技术研究具有重要理论意义。
实际应用
在实际应用中,该数据集为本地化部署的代码生成模型提供了性能标杆与诊断工具。开发者可利用其遥测日志(如生成速度、延迟、语法匹配得分)来评估不同模型在消费级硬件(如RTX 4090笔记本GPU)上的运行效率与输出质量,从而指导模型选型与部署策略优化。此外,数据集中包含的沙箱反馈与执行失败记录,可用于调试和提升本地代码执行管道的鲁棒性,助力构建更可靠的自动化代码生成与评估系统。
数据集最近研究
最新研究方向
该数据集聚焦于评估未经指令对齐的原始基础模型在零样本代码生成任务中的表现。通过对StarCoder2 3B在MBPP基准上的测试,揭示了基础模型尽管具备极高的生成吞吐量(近185 TPS),但在功能正确性上仅达到0.2%的Pass@1准确率,与经过指令微调的同参数规模模型(如Qwen2.5-Coder 3B的42%准确率)形成鲜明对比。这一结果深刻印证了当前大语言模型研究中的核心议题:即强大的预训练架构并不天然具备理解自然语言指令的能力,必须通过精细的对话对齐层才能释放其实际应用价值。该数据集的发布为评估基础模型与指令微调模型之间的性能鸿沟提供了标准化基准,对推动高效微调策略和模型对齐技术的发展具有重要参考意义。
以上内容由遇见数据集搜集并总结生成


