
遇见数据集

TMax-SFT-16.5K

收藏
Hugging Face2026-06-23 更新2026-06-24 收录
官方服务:

资源简介:

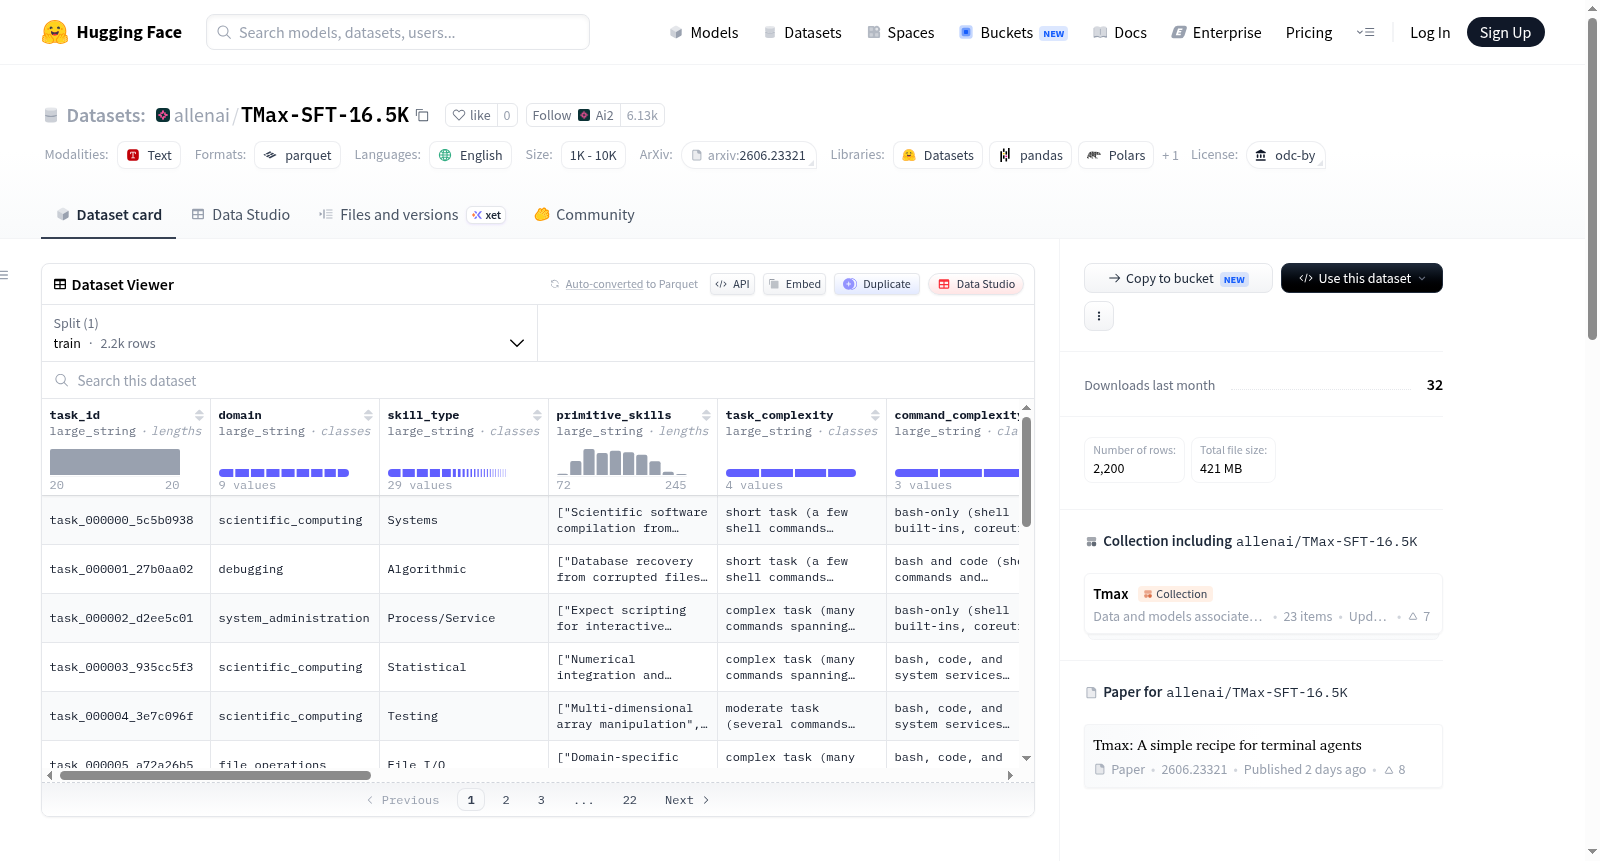
TMax SFT是一个用于监督式微调(SFT)的数据集,源自Tmax研究项目。该数据集包含了Qwen 3.6 27B大型语言模型在大约2000个独立生成的环境中所产生的交互轨迹(traces),旨在为研究和教育目的提供训练数据,特别适用于开发或微调终端智能体(terminal agents)相关的任务。数据遵循ODC-BY许可证,并需在遵守Ai2负责任使用指南及谷歌服务条款(因部分数据由Gemini 3.1 Pro生成)的前提下使用。

TMax SFT is a dataset for supervised fine-tuning (SFT), derived from the Tmax research project. It contains interaction traces generated by the Qwen 3.6 27B large language model in approximately 2000 independently generated environments. The dataset is designed to provide training data for research and educational purposes, particularly suitable for tasks related to developing or fine-tuning terminal agents. The data follows the ODC-BY license and must be used in compliance with the Ai2 Responsible Use Guidelines and Googles Terms of Service (as some data was generated by Gemini 3.1 Pro).

提供机构:
Allen Institute for AI
创建时间:
2026-06-17
原始信息汇总

数据集概述:TMax-SFT-16.5K

该数据集由 Allen AI 发布,用于训练终端的简单代理(terminal agents)。

  • 许可证:ODC-BY (Open Data Commons Attribution License)
  • 语言:英语 (en)

数据集内容

  • 包含来自 Qwen 3.6 27B 模型在 Tmax 生成的约 2000 个环境中的轨迹数据。
  • 构成 SFT(监督式微调) 数据集,名称为 TMax SFT
  • 另有适用于 open-instruct 工具的数据集版本,位于 https://huggingface.co/datasets/allenai/tmax-sft

许可与用途

  • 依据 Ai2 的 负责任使用指南,仅供研究和教育用途。
  • 数据中包含使用 Gemini 3.1 Pro 生成的输出,受 Google 服务条款约束。

引用

如需使用该模型或数据,请引用论文:https://arxiv.org/abs/2606.23321 (Hamish Ivison 等人,2026年)。
搜集汇总
数据集介绍
TMax-SFT-16.5K 数据集图片
构建方式
TMax-SFT-16.5K 数据集源自于 Tmax 项目中用于训练终端智能体的监督微调流程。该数据集基于 Qwen 3.6 27B 模型在大约 2,000 个独立生成的交互环境中产生的行为轨迹构建而成。每个轨迹均记录了模型在特定任务环境中的完整决策路径与输出序列,通过对这些轨迹进行筛选与整理,形成了规模约 16.5K 的高质量监督微调样本。数据集的构建过程旨在为终端智能体的行为学习提供真实、多样的训练素材,从而提升模型在复杂终端环境下的适应能力与任务完成效率。
使用方法
TMax-SFT-16.5K 数据集可直接用于监督微调范式,用户可将其与主流的指令微调框架(如 open-instruct)结合使用。针对偏好与 open-instruct 格式兼容的用户,HuggingFace 上提供了专门的版本。加载数据后可将其拆分为训练集与验证集,并依据任务需求进行格式转换或样本筛选。结合 Tmax 项目发布的模型与代码库,开发者能够高效复现论文实验,或在该数据集基础上进一步扩展,训练具备更强终端交互能力的智能体。建议在研究论文中引用 Tmax 论文以规范学术贡献的追溯。
背景与挑战
背景概述
TMax-SFT-16.5K数据集由艾伦人工智能研究所(AI2)的研究人员Hamish Ivison、Junjie Oscar Yin、Rulin Shao等人在2026年创建,旨在推动终端智能体(terminal agents)领域的发展。该数据集基于Qwen 3.6 27B模型在约2000个独立环境中生成的轨迹数据构建而成,其核心研究问题是如何通过简单有效的方法训练出能够完成复杂终端任务的智能体。作为TMax项目的重要组成部分,该数据集为社区提供了标准化的监督微调(SFT)数据,有助于促进终端智能体研究领域的方法复现与比较,对相关领域产生了积极的推动作用。
当前挑战
TMax-SFT-16.5K数据集主要面临以下挑战:首先,终端智能体领域本身存在环境多样性与任务复杂性的双重难题,数据集需要覆盖足够广泛的终端操作场景以确保模型泛化能力,但环境数量有限可能带来分布外泛化风险。其次,构建过程中面临高质量轨迹数据获取的挑战,数据集依赖Gemini 3.1 Pro生成轨迹,这涉及到API调用成本、数据一致性校验以及潜在的有偏输出等问题。此外,数据集的授权采用ODC-BY协议,且生成数据需遵守Google服务条款,在研究与商业应用之间的合规性平衡亦构成隐性挑战。
常用场景
经典使用场景
在终端智能体(Terminal Agent)研究领域,TMax-SFT-16.5K数据集被设计用于对大型语言模型进行监督微调(SFT),使其具备在命令行环境中执行复杂任务的能力。该数据集包含由Qwen 3.6 27B模型在约2000个独立环境中生成的交互轨迹,每条轨迹都记录了模型在终端界面中的完整操作序列与反馈结果。研究者可利用这些高质量轨迹数据,训练模型理解终端指令、执行文件操作、运行脚本以及解析系统输出,从而显著提升语言模型在真实Unix/Linux环境下的自主操作能力。这一场景为探索终端代理的通用性与鲁棒性提供了标准化训练基础。
解决学术问题
TMax-SFT-16.5K数据集着力解决了语言模型在终端环境中的行为学习与泛化难题。传统的智能体研究多聚焦于图形用户界面或模拟环境,而终端交互具有高度结构化、指令稀疏且依赖上下文的特点,使得模型难以从零散示例中习得有效策略。该数据集通过提供覆盖多种系统命令、错误处理和任务规划的完整轨迹,为模型学会了如何分解任务、执行操作并自适应调整行为提供了监督信号。它的出现填补了终端智能体领域大规模、高质量训练数据的空白,推动了从基础对话模型向具备实际操作能力的智能代理的范式转变,为后续研究可迁移的终端行为策略奠定了数据基石。
实际应用
在实际应用层面,TMax-SFT-16.5K数据集训练的模型可广泛部署于自动化运维、系统管理、开发者辅助等场景。例如,运维团队可借助终端智能体自动执行服务器配置、日志分析、故障排查等重复性任务,显著提升工作效率并降低人为失误。软件开发人员能够利用该能力在命令行环境中快速检索文件、批量处理数据或编译项目,从而将精力集中于核心逻辑设计。此外,教育领域可基于该数据集构建交互式学习系统,帮助初学者通过自然语言指令掌握终端操作技能。这些应用充分展示了数据集在跨领域赋能终端任务自动化方面的巨大潜力。
数据集最近研究
最新研究方向
TMax-SFT-16.5K数据集聚焦于终端智能体(Terminal Agents)的监督微调,通过利用Qwen 3.6 27B模型在约2000个独立环境中生成的交互轨迹,为智能体在复杂终端任务中的行为对齐与策略学习提供高质量训练样本。该方向与当前大语言模型从对话式助手向具身化、可执行终端操作的研究热点紧密相连,尤其是在自动化运维、代码交互和系统控制等实际场景中,终端智能体需具备精准的环境感知与长链决策能力。TMax的出现为构建更鲁棒的终端任务智能体提供了标准化数据基准,推动了大模型在闭环控制与实时交互中的落地应用,其开源许可和负责任使用指南也促进了科研社区在智能体安全与可解释性方面的探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

