
遇见数据集

PrimeIntellect/R2E-Gym-Subset-Verified

收藏
Hugging Face2026-07-08 更新2026-07-22 收录
官方服务:

资源简介:

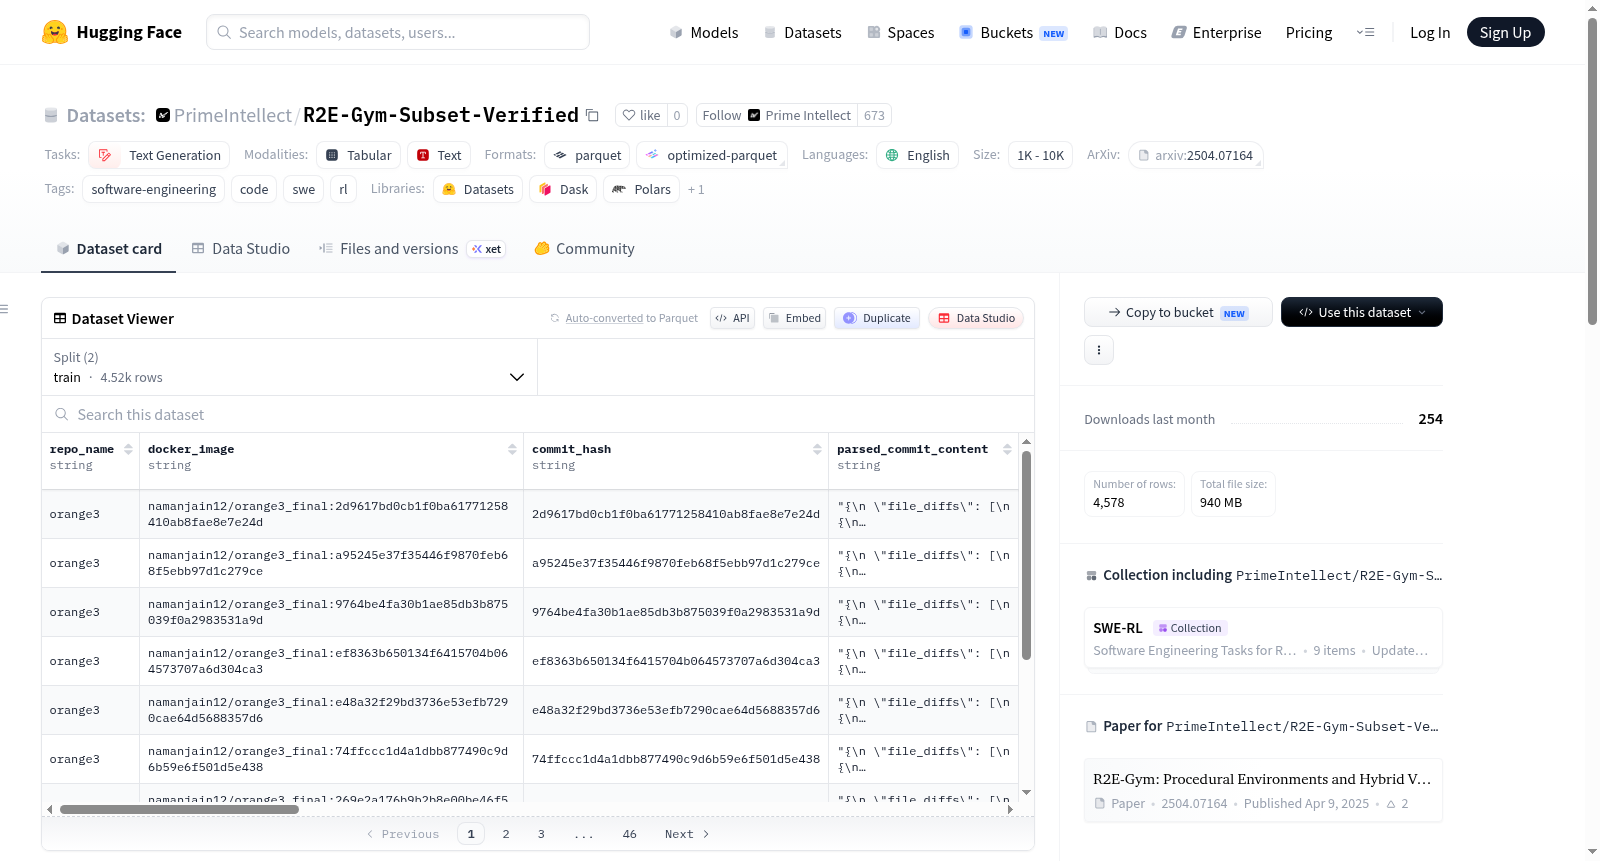
R2E-Gym-Subset-Verified 是 R2E-Gym/R2E-Gym-Subset 数据集的黄金补丁验证子集,专注于软件工程代码生成任务,涉及强化学习。该数据集经过验证,确保黄金补丁应用后能通过上游测试,并检查预期输出。训练集包含4,522行(占原始4,578行的98.78%),丢弃集包含56行,主要因网络/时间敏感测试失败或数据集漂移。数据集无明确许可证,但代码基于Apache-2.0,数据源自公共GitHub仓库。

R2E-Gym-Subset-Verified is a gold-patch-validated subset of the R2E-Gym/R2E-Gym-Subset dataset, focused on software engineering code generation tasks involving reinforcement learning. The dataset is verified to ensure that applying the gold patch passes upstream tests and matches expected outputs. The train split contains 4,522 rows (98.78% of the original 4,578), and the dropped split contains 56 rows, primarily due to network/timing-sensitive test failures or dataset drift. No explicit dataset license is declared, but the code is Apache-2.0 licensed, with data derived from public GitHub repositories.
提供机构:
PrimeIntellect
搜集汇总
数据集介绍
PrimeIntellect/R2E-Gym-Subset-Verified 数据集图片
构建方式
R2E-Gym-Subset-Verified 数据集是基于上游 R2E-Gym-Subset 经过严格验证筛选而构建的子集。构建过程采用端到端可计分验证策略:首先将每个样本的金牌补丁(gold patch)应用到对应的沙箱环境中,运行上游内置的测试脚本,并将解析出的测试结果与期望输出(expected_output_json)进行比对。对于初次验证失败的样本,再进行最多10次重试,以区分偶然性失败和确定性损坏。最终,仅保留在至少一次重试中验证通过的样本进入训练集,而10次重试均失败的样本则归入丢弃集。经过这一流程,训练集保留了 4,522 个样本,占比高达 98.78%。
使用方法
使用该数据集需要配合 r2e_gym_v1 任务包和 verifiers 验证框架。首先通过 pip 安装 research-environments 项目中的 r2e_gym_v1 子包,安装命令为 uv pip install --prerelease=allow "git+https://github.com/PrimeIntellect-ai/research-environments.git#subdirectory=environments/swe/r2e_gym_v1"。安装完成后,可通过 uv run eval --taskset.id r2e_gym_v1 -m <your-model> -n 100 -r 4 命令启动评估,该命令将加载数据集,并在隔离的沙箱环境中执行测试,自动收集可计分的反馈。数据集划分为 train 和 dropped 两个子集,实际使用时建议仅加载 train 拆分进行模型训练与评测。
背景与挑战
背景概述
在软件工程领域,自动化代码修复与强化学习(RL)的结合正逐渐成为提升开发效率的重要手段。R2E-Gym-Subset-Verified 数据集由 Prime Intellect AI 团队于 2025 年发布,旨在为基于强化学习的软件工程(SWE)任务提供一个经过严格验证的高质量训练与评估子集。该数据集源自 R2E-Gym 项目,专注于为自动化代码补丁生成、测试验证等核心研究问题提供端到端的可计分环境。通过过滤掉因网络波动、时序依赖或数据集漂移导致的不可靠样本,该数据集显著提升了实验结果的稳健性与可复现性,为后续强化学习驱动的代码修复研究奠定了坚实的数据基础。
当前挑战
该数据集面临的主要挑战包括:其一,领域问题层面,自动化代码修复任务常受困于测试环境的不确定性,例如网络超时、异步 I/O 测试的时序敏感性问题(如 aiohttp 与 tornado 相关用例占丢弃样本的 39%),导致验证结果波动剧烈,难以区分真正失效与偶发性失败。其二,构建过程中需应对数据集漂移——部分测试用例在当前环境中通过,却与历史记录的预期输出不符,给样本筛选带来额外复杂度。此外,如何在保持数据规模与确保验证可靠性之间取得平衡,是该数据集设计时面临的核心矛盾,最终通过多次重试机制与严格丢弃策略来缓解这一难题。
常用场景
经典使用场景
在软件工程与人工智能的交叉领域,自动化代码缺陷修复一直是极具挑战性的前沿课题。R2E-Gym-Subset-Verified数据集为强化学习驱动的代码编辑智能体提供了标准化的训练与评估环境。其经典使用场景聚焦于终端到终端的代码补丁验证:研究者利用该数据集中的真实GitHub仓库提交记录,将模型生成的补丁应用于隔离的沙盒环境中,通过执行上游预设的测试脚本并比对预期输出结果,精准衡量智能体修复代码缺陷的能力。该数据集的验证性子集确保了训练样本的质量——仅保留经过金标准补丁确认的样本,从而为代码智能体提供了可靠的反馈信号,推动强化学习算法在软件维护领域的有效训练。
解决学术问题
该数据集精准回应了软件工程自动化领域中两个悬而未决的学术挑战:代码修复实验的可复现性与评估指标的噪声控制。传统代码修复研究常受困于测试环境的非确定性,而R2E-Gym-Subset-Verified通过十次重试机制系统性分离了偶发性测试失败与确定性错误,构建了学术研究亟需的干净评估基准。它有效解决了数据集漂移问题——即随时间推移代码仓库本身变化导致原有标注失效的困境,同时为网络敏感型测试(如异步框架的异步测试)提供了失败归因的透明化追踪。这一工作极大地提升了代码修复领域实验结论的可靠性与跨系统比较的公平性,为后续理论突破奠定了坚实的实验基础。
实际应用
在实际工程应用层面,该数据集为大型软件系统的持续集成与持续交付流水线注入了智能化能力。基于该数据集的强化学习智能体能够自动生成针对开源仓库中真实缺陷的补丁,显著减轻开发人员在代码审查与回归测试环节的认知负荷。具体而言,它支持部署在版本控制系统的事件驱动型机器人,当检测到测试失败时自动生成候选修复方案,并通过沙盒环境验证其有效性。此外,该数据集还可用于训练代码审查辅助系统,帮助识别代码变更中潜在的缺陷模式,提升大型团队协作开发的代码质量保证效率。
数据集最近研究
最新研究方向
在软件工程与强化学习交汇的前沿领域,R2E-Gym-Subset-Verified数据集为代码智能的研究提供了经过严格验证的高质量训练语料。该数据集从原始R2E-Gym子集中精选出4522条经过金补丁验证的样本,通过10次重试机制剔除了网络敏感和时序不稳定的测试用例,构建了可端到端评分的安全强化学习环境。这一工作紧密关联着近年来以大型语言模型驱动的自动化程序修复、代码生成智能体等热点事件,尤其为基于奖励模型的代码优化策略提供了可靠的评估基准。其意义在于通过严格的验证流程解决了传统代码数据集中测试噪声问题,使得强化学习算法能够更有效地学习到鲁棒的程序理解与生成能力,推动了软件工程中自动化开发和调试技术的可靠演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

