
遇见数据集

iDRAMALab/iDRAMA-scored-2024

收藏
Hugging Face2024-11-05 更新2024-06-11 收录
官方服务:

资源简介:

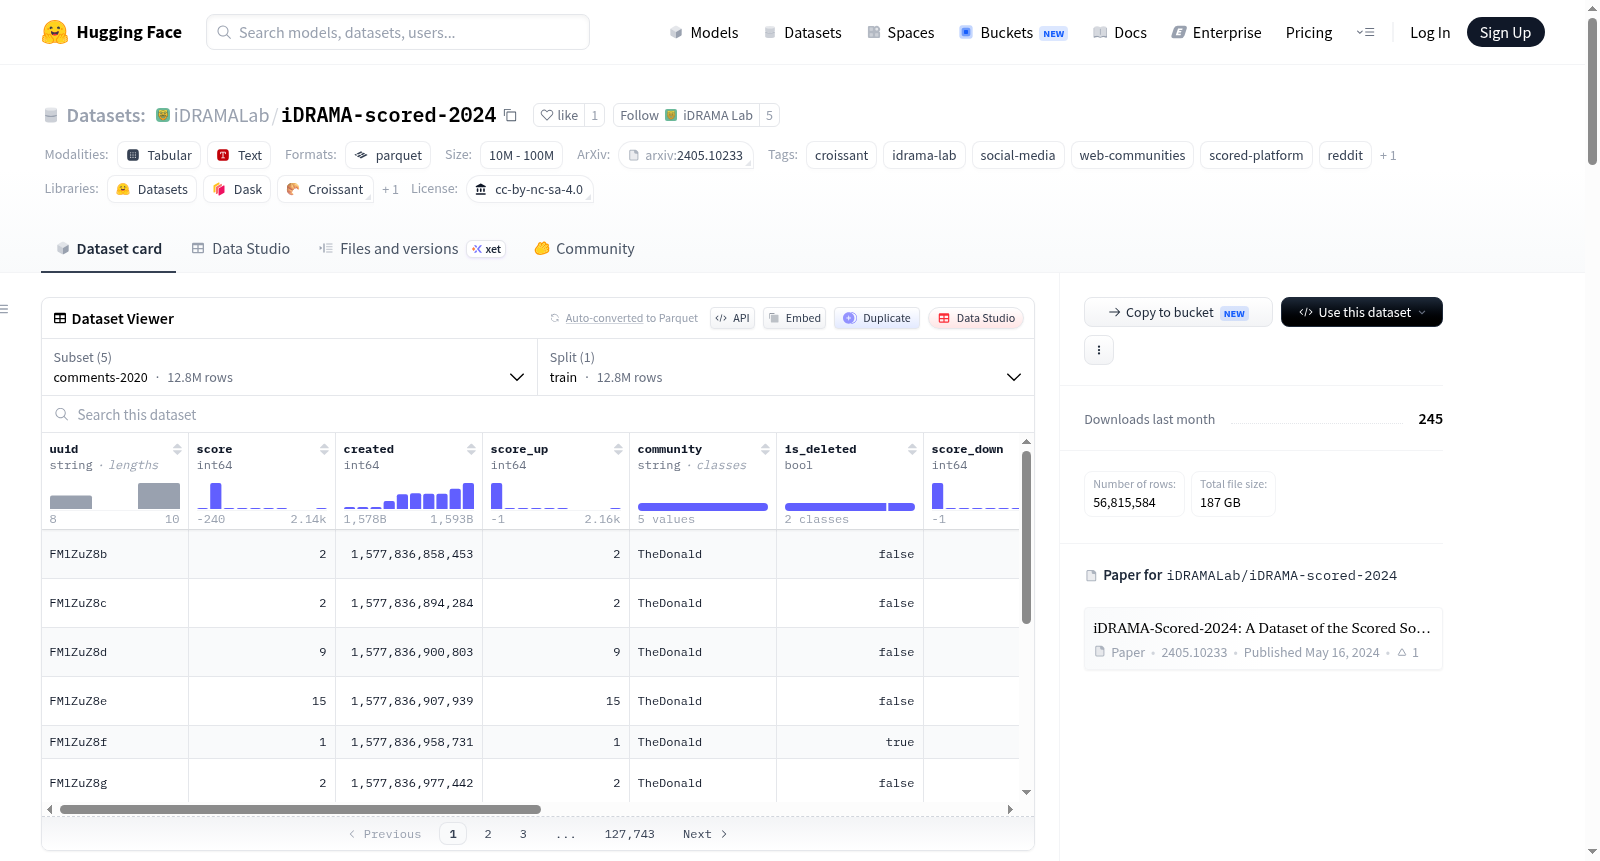
iDRAMA-Scored-2024是一个大规模的数据集,包含了来自社交媒体平台Scored上约5700万条帖子。Scored是Reddit的替代平台,主要托管一些被禁的边缘社区,例如c/TheDonald和c/GreatAwakening。该数据集涵盖了2020年至2023年间的950多个社区的帖子,并且每个帖子都附有句子嵌入。数据集按年份分为多个配置,包括2020年至2023年的评论和提交数据,每个配置包含多个特征,如uuid、score、created、community、raw_content等。

iDRAMA-Scored-2024 is a large-scale dataset containing approximately 57 million social media posts from the Scored platform. Scored serves as an alternative to Reddit, hosting banned fringe communities, such as c/TheDonald and c/GreatAwakening. The dataset includes posts from over 950 communities collected over four years (2020-2023) and provides sentence embeddings for all posts. The dataset is organized into yearly configurations for comments and submissions, each containing features such as uuid, score, created, community, raw_content, and more.

提供机构:
iDRAMALab
原始信息汇总

数据集概述

数据集名称

iDRAMA-Scored-2024

数据集内容

该数据集包含约5700万条来自Scored社交平台的网络社区帖子,涵盖超过950个社区,收集时间为四年,并包含所有帖子的句子嵌入。

数据集结构

数据集按年份和类型组织,包括以下配置:

  • comments-2020
  • comments-2021
  • comments-2022
  • comments-2023
  • submissions-2020-to-2023

每个配置包含的特征如下:

评论数据特征

  • uuid: 唯一标识符
  • score: 评分
  • created: 创建时间
  • score_up: 点赞数
  • community: 社区名称
  • is_deleted: 是否删除
  • score_down: 点踩数
  • raw_content: 原始内容
  • is_moderator: 是否为管理员
  • date: 日期
  • author: 作者
  • embedding: 嵌入向量

提交数据特征

  • link: 链接
  • type: 类型
  • uuid: 唯一标识符
  • score: 评分
  • title: 标题
  • domain: 域名
  • created: 创建时间
  • is_nsfw: 是否不适合工作环境
  • is_admin: 是否为管理员
  • is_image: 是否为图片
  • is_video: 是否为视频
  • score_up: 点赞数
  • tweet_id: 推特ID
  • community: 社区名称
  • is_deleted: 是否删除
  • is_twitter: 是否为推特链接
  • score_down: 点踩数
  • video_link: 视频链接
  • raw_content: 原始内容
  • is_moderator: 是否为管理员
  • post_flair_text: 帖子标签文本
  • post_flair_class: 帖子标签类别
  • date: 日期
  • author: 作者
  • embedding: 嵌入向量

数据集大小

  • comments-2020: 训练集包含12,774,203个样本,数据大小为31,046,054,383字节。
  • comments-2021: 训练集包含16,097,941个样本,数据大小为40,987,707,754字节。
  • comments-2022: 训练集包含12,730,301个样本,数据大小为40,428,423,985字节。
  • comments-2023: 训练集包含8,919,159个样本,数据大小为28,954,472,165字节。
  • submissions-2020-to-2023: 训练集包含6,293,980个样本,数据大小为17,187,529,594字节。

许可证

数据集遵循CC BY-NC-SA 4.0非商业许可协议。
搜集汇总
数据集介绍
iDRAMALab/iDRAMA-scored-2024 数据集图片
构建方式
iDRAMA-Scored-2024数据集构建于对社交平台Scored的全面数据采集之上,该平台作为Reddit的替代品,容纳了大量被主流平台驱逐的边缘社区。数据收集跨越2020年至2023年四个年度,系统性地抓取了超过950个社区中约5700万条帖子,包括评论与提交内容。每条帖子均经过预处理,提取了原始文本、元数据(如时间戳、作者哈希值、社区归属、投票数)及布尔标志(如是否被删除、是否为版主发布)。尤为重要的是,研究团队为每条帖子生成了768维的句子嵌入向量,以支持语义分析。数据集按年份划分为comments-2020至comments-2023四个评论配置,以及一个submissions-2020-to-2023提交配置,确保了时间维度上的结构化组织。
特点
该数据集的核心特点在于其大规模、高覆盖度与丰富的元数据注释。首先,5700万条帖子来自Scored平台上的极端与边缘社区,如c/TheDonald和c/GreatAwakening,为研究网络极端主义、阴谋论传播及社群极化提供了独特视角。其次,每条记录包含详细的社交互动指标(如点赞数、删除状态)和内容属性(如NSFW标记、媒体类型),便于进行多维度分析。此外,预生成的句子嵌入向量大幅降低了下游任务的计算门槛,研究者可直接利用这些特征进行聚类、分类或相似性检索,无需重复进行文本向量化。数据集的年度分割设计也支持纵向演化分析,捕捉社群动态随时间的变化趋势。
使用方法
使用该数据集时,推荐通过HuggingFace Datasets库高效加载。用户可调用`load_dataset("iDRAMALab/iDRAMA-scored-2024")`一次性下载全部配置,或通过指定`name`参数(如`name="comments-2020"`)按需加载特定年份的评论数据。对于数据清洗,建议利用pandas过滤空值记录,例如移除`title`或`author`为空的行,以及剔除`embedding`列中的NaN值,以确保分析质量。数据集支持直接转换为pandas DataFrame进行探索性分析,或结合PyTorch/TensorFlow构建模型管道。更详尽的代码示例与高效加载策略可参考其GitHub仓库,以适配不同计算资源与任务需求。
背景与挑战
背景概述
在社交媒体研究领域,对边缘化网络社区及其极端言论的量化分析始终是学界关注的焦点。iDRAMA-Scored-2024数据集由iDRAMA Lab(隶属宾汉姆顿大学、波士顿大学及加州大学河滨分校)于2024年创建,旨在填补对Reddit替代平台Scored上内容生态的研究空白。该平台容纳了被主流社区驱逐的极端群体,如右翼社区c/TheDonald与阴谋论社区c/GreatAwakening。数据集收录了2020至2023年间超过950个社区的约5700万条帖子,涵盖评论与提交内容,并为每条帖子提供了768维句子嵌入向量。这一大规模结构化资源为研究网络极端主义传播、社区动态演化及在线言论极化提供了前所未有的实证基础,其论文发表于AAAI ICWSM 2024会议,显著推动了计算社会科学领域对隐蔽网络生态的认知。
当前挑战
该数据集面临的挑战主要体现在两个层面。在领域问题层面,Scored平台作为主流社交媒体的替代品,其内容往往涉及仇恨言论、阴谋论及违规信息,如何从海量帖文中准确识别并量化这些极端化模式,同时避免对敏感话题的过度简化或误判,是核心研究难点。在构建过程中,数据收集需应对平台反爬机制与内容删除导致的不完整性,例如部分帖子因管理措施被删除后,其标题与正文可能为空字符串。此外,为保护用户隐私,作者字段采用哈希处理,但这也增加了用户行为追踪与跨帖子关联分析的复杂性。数据集的嵌入列存在显式空值,需在预处理阶段进行妥善筛选与填充,以确保下游分析的鲁棒性。
常用场景
经典使用场景
在社交网络与计算社会科学领域,iDRAMA-Scored-2024数据集为研究者提供了极为珍贵的纵向语料库,其涵盖2020至2023年间来自Scored平台上逾950个社群的约5700万条帖子与评论。尤为引人瞩目的是,该数据集聚焦于被主流平台封禁的边缘化在线社区,如极右翼社群c/TheDonald与阴谋论社群c/GreatAwakening。经典的使用方式包括利用其内嵌的768维句子嵌入向量进行大规模语义分析,追踪特定意识形态在时间轴上的演化轨迹,或通过社区间的交互模式挖掘极端化内容的传播机制。数据集按年度划分的配置设计,亦极大便利了跨年度比较研究,为理解网络极化现象的动态演变提供了坚实的数据基础。
实际应用
在实际应用层面,该数据集为社交媒体平台的内容安全团队与政策制定者提供了宝贵的模拟沙盘。通过训练基于句子嵌入的异常检测模型,可实现对潜在仇恨言论、虚假信息或极端主义招募帖文的早期预警。例如,利用‘score_up’与‘score_down’字段,可构建社区自净能力的评估指标,辅助优化自动审核阈值。此外,数据集中‘is_deleted’与‘is_moderator’标签,使开发者能够模拟不同审核策略下的内容生态变化,从而设计更精准的干预算法。在舆情监控领域,该数据集亦可用于训练跨平台的语言模型,以追踪特定叙事(如选举阴谋论)如何在替代平台间萌芽、发酵并回流至主流网络。
衍生相关工作
自发布以来,iDRAMA-Scored-2024已催生了一系列具有影响力的衍生研究。在方法论层面,有工作基于其嵌入向量开发了‘社区指纹’技术,通过对比不同社群的语义空间密度,量化了极端社群与主流社群之间的认知隔阂。在理论探索上,研究者利用该数据集的时序特性,验证了‘仇恨溢出效应’——即针对某一群体的攻击性言论会系统性扩散至其他少数群体。此外,结合‘submissions-2020-to-2023’配置中的‘domain’与‘link’字段,有学者构建了虚假信息源头的溯源图谱,揭示了被取缔社区如何通过外链引流维持影响力。这些工作不仅巩固了该数据集作为边缘网络研究基准的地位,更开辟了人机协同内容审核、跨平台叙事动力学等前沿方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

