
UBC-NLP/AlexandriaX_Subtask_3_Test
收藏官方服务:
资源简介:
该数据集包含AlexandriaX子任务3的测试集,这是一个方言阿拉伯语机器翻译评估任务。参与者接收带有源信息的机器翻译输出,目标是通过受LQM启发的注释来检测和分类翻译错误。
This dataset contains the test split for AlexandriaX Subtask 3, a dialectal Arabic MT evaluation task. Participants receive machine-translated outputs with source information. The goal is to detect and classify translation errors using LQM-inspired annotations.
提供机构:
UBC-NLP搜集汇总
数据集介绍
构建方式
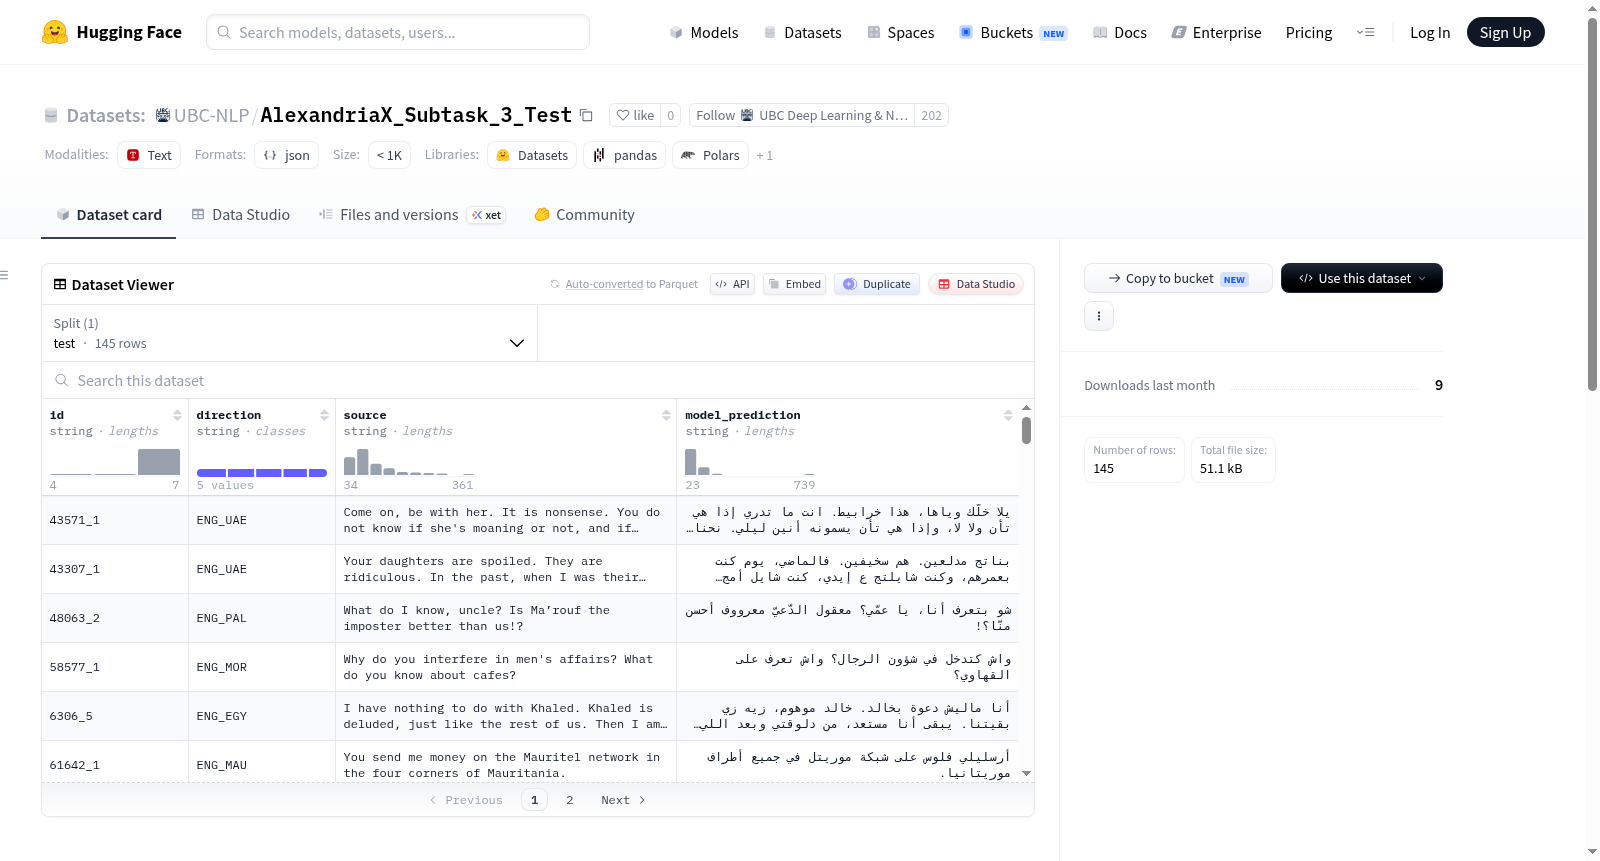
AlexandriaX_Subtask_3_Test数据集专为方言阿拉伯语机器翻译评估任务而构建,聚焦于翻译错误的检测与分类。该数据集以JSONL格式存储,每条数据包含唯一标识符、翻译方向、源语言文本以及模型输出的预测翻译。参与者需依据LQM(Language Quality Measurement)启发的标注体系,对机器翻译结果中的错误进行识别与归类,从而推动方言阿拉伯语MT系统的性能优化。
特点
该数据集独具特色地围绕方言阿拉伯语这一低资源语言方向设计,测试集涵盖从英语到阿联酋方言(ENG_UAE)等特定翻译方向。每条样本均提供源语言文本与模型预测输出,便于研究者直接对比分析。数据规模适中,强调对翻译错误细粒度分类的评估,而非简单的自动指标计算,为方言MT领域提供了更具诊断性的评测基准。
使用方法
研究者可通过HuggingFace的datasets库便捷加载该数据集,使用`load_dataset('json', data_files={'test': 'test.jsonl'})`命令即可获取测试集。数据加载后,每条记录包含id、direction、source、model_prediction四个字段,可直接用于构建错误检测与分类模型。建议结合LQM标注体系,对模型预测结果进行逐条错误标注,并以此评估翻译系统的实际表现。
背景与挑战
背景概述
阿拉伯语作为多方言共存的语言体系,其机器翻译质量评估面临独特挑战。AlexandriaX_Subtask_3_Test数据集由UBC-NLP团队创建,聚焦于方言阿拉伯语的机器翻译错误检测与分类任务。该数据集为测试集,包含机器翻译输出的源句子及对应模型预测,旨在通过基于语言质量指标(LQM)的注释方法,推动方言阿拉伯语翻译评估研究。其核心研究问题是如何有效识别并分类翻译中的各类错误,从而提升方言翻译系统的性能。该数据集的发布为低资源方言翻译评估提供了标准化基准,对阿拉伯语自然语言处理领域的研究进展具有重要推动作用。
当前挑战
该数据集面临的主要挑战包括:方言阿拉伯语缺乏统一书写规范,导致错误类型界定困难;机器翻译输出中错误模式复杂,需设计精细的分类体系;构建过程中需平衡方言多样性与标注一致性,确保跨方言评估的可靠性。此外,现有评估指标多面向标准阿拉伯语,方言特有表达如语气词、语序异常等错误难以被现有度量捕捉,这对错误检测的粒度与准确性提出更高要求。数据集构建时还需处理源语言与目标语言间的文化差异,避免翻译评估受到非语言因素干扰。
常用场景
经典使用场景
AlexandriaX_Subtask_3_Test数据集专为方言阿拉伯语的机器翻译质量评估而设计,其核心用途在于检测和分类机器翻译输出中的错误。通过提供源语言句子及其对应的模型预测译文,研究者可以基于语言质量指标(LQM)对翻译错误进行精细标注与归类。该数据集聚焦于英语至多种阿拉伯方言(如UAE方言)的翻译方向,为方言化机器翻译的鲁棒性测试提供了标准化评测平台。在经典使用中,参与者需根据源文本与机器译文的对照,识别出词汇、语法、语义或风格层面的错误,并依据预定义的错误类型体系进行分类,从而系统性地评估翻译系统的性能短板。
衍生相关工作
该数据集的发布催生了一系列围绕方言阿拉伯语机器翻译质量评估的学术工作。其中,基于LQM的错误分类体系被进一步扩展,衍生出针对海湾方言、埃及方言等特定变体的细粒度错误标注规范。部分研究利用该数据集训练了多任务学习模型,同时预测错误类型与严重程度,显著提升了评估的自动化水平。此外,数据集的测试样例还常被用作基准,在对比实验中评估新型神经机器翻译架构(如融合方言知识图谱或对抗训练方法)的性能增益。这些衍生工作共同推动了方言化自然语言处理领域从“通用评估”向“方言感知评估”的范式转变。
数据集最近研究
最新研究方向
该数据集聚焦于方言阿拉伯语机器翻译中错误检测与分类的前沿任务,利用语言质量评估启发的标注体系对模型输出进行细粒度分析。在方言翻译日益受到关注的背景下,该研究通过测试集构建与多方向翻译评估,推动机器翻译系统在低资源、高变异性方言场景中的鲁棒性提升。其影响在于为方言翻译质量评估提供标准化基准,助力缓解全球化语境下阿拉伯语方言沟通障碍,尤其对涉及区域语言互译的热点领域(如社交媒体内容理解与跨方言信息传播)具有重要实践意义。
以上内容由遇见数据集搜集并总结生成


