遇见数据集

VoLN-UAV

收藏
arXiv2026-07-23 更新2026-07-27 收录
官方服务:

资源简介:

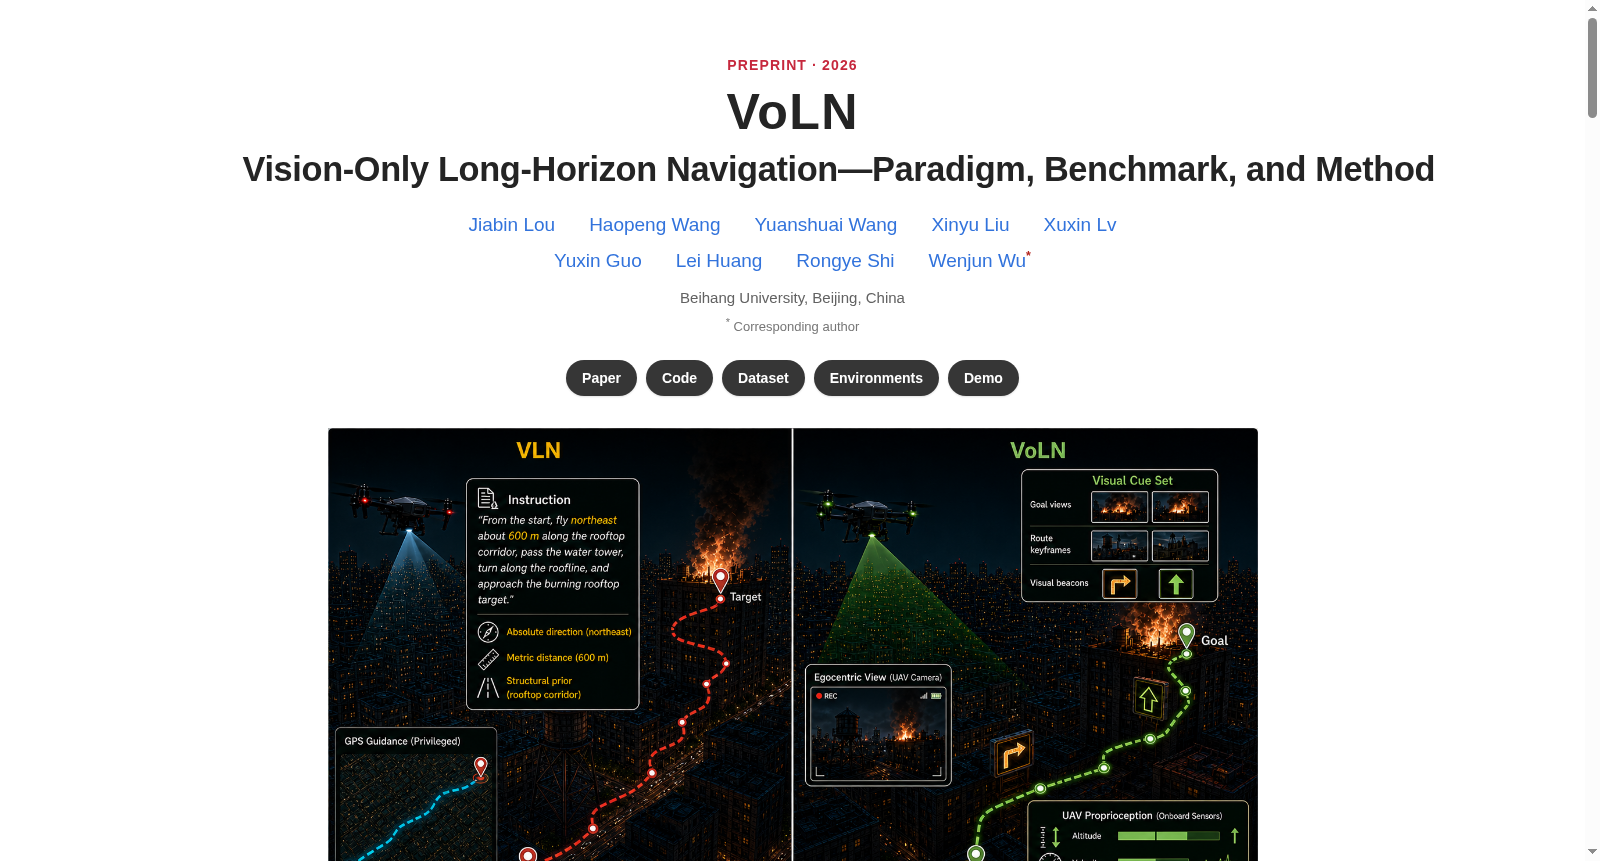
VoLN-UAV是由北京航空航天大学团队提出的一个面向无人机长视距视觉导航的基准数据集,旨在探索仅依赖视觉线索的自主飞行范式。该数据集包含7,210个任务片段,覆盖17个多样化的仿真环境,通过高保真渲染同步采集了RGB观测、本体感知状态及视觉目标视图,并引入了主动信标与被动信标构成的语义线索系统。数据构建采用轨迹中心化流程,融合了现有数据集预定义路径与人工操作定制轨迹,以增强对复杂飞行模式的覆盖。该数据集主要应用于无人机自主导航、视觉-语义对齐、长时序证据集成等研究领域,致力于解决在无GPS、无全局先验的开放三维空间中,仅依靠局部视觉观测实现长距离目标导向飞行的核心挑战。

VoLN-UAV is a benchmark dataset proposed by the team from Beihang University for long-range visual navigation of unmanned aerial vehicles (UAVs), targeting the exploration of autonomous flight paradigms that rely solely on visual cues. This dataset contains 7,210 task segments spanning 17 diverse simulated environments, and synchronously acquires RGB observations, proprioceptive states, and visual target views via high-fidelity rendering. It also incorporates a semantic cue system composed of active beacons and passive beacons. The dataset is built via a trajectory-centric pipeline, which combines pre-defined paths from existing datasets and manually tailored trajectories to enhance coverage of complex flight patterns. This dataset is primarily utilized in research fields such as UAV autonomous navigation, vision-semantic alignment, and long-sequence evidence integration, and aims to address the core challenge of achieving long-distance target-oriented flight relying solely on local visual observations in open 3D spaces without GPS or global prior information.

创建时间:
2026-07-23
原始信息汇总

数据集概述

数据集名称: VoLN-UAV Benchmark

所属项目: VoLN(Vision-Only Long-Horizon Navigation)

任务类型: 仅视觉的长时域无人机导航(Vision-Only Long-Horizon Navigation for UAV)

数据集规模:

  • 总片段数:7,210
  • 训练集:5,047
  • 验证集(Seen场景):1,082
  • 测试集(Unseen场景):1,081

环境覆盖: 覆盖沙漠、森林、山地、城市峡谷、夜间城市、校园、隧道、工业走廊、开阔场地等多种自然与建筑环境。

数据构建方式: 预设与操作员采集的轨迹经增强处理,包含路径感知的信标、同步的逐步骤标注、以及用于未见环境评估的场景源划分。

难度划分(依据参考路径长度):

  • 简单(Easy):< 300 m
  • 普通(Normal):300–450 m
  • 困难(Hard):≥ 450 m

数据集包含内容: 分片轨迹、RGB观测图像、标注信息、元数据。

配套资源:

  • 模拟器包:提供虚幻引擎(Unreal Engine)和AirSim环境,用于在线评估。
  • 代码仓库:包含训练、基准构建、VoLN适配基线及评估脚本。
搜集汇总
数据集介绍
VoLN-UAV 数据集图片
构建方式
VoLN-UAV的构建依托于Unreal Engine与Microsoft AirSim高保真仿真环境,从17个不同场景中选取轨迹,这些场景涵盖AerialVLN和OpenUAV等开源数据集中的场景以及自定义构建的环境。针对每条参考轨迹,在决策点稀疏部署3至5个主动信标作为任务相关线索,并在每个环境中额外设置约150个静态被动信标以构成语义杂波。轨迹以2秒间隔记录同步的自我中心RGB观测、本体感知状态,并将最后三帧作为视觉目标集。数据集包含7,210个片段,按路径长度划分为易、正常、难三个难度等级,并按照70%/15%/15%的比例分配至训练、验证和测试集。
使用方法
使用VoLN-UAV时,智能体在每个决策步骤仅接收自我中心RGB观测、本体感知数据和视觉目标集,并预测短时序的相对三维航点序列及停止信号。低层飞行控制器执行预测的航点,并在停止概率超过阈值时终止任务。作为参考基准的VoLN-MLLM方法分两阶段运作:首先通过蒸馏学习将DINO视觉特征对齐至CLIP语义空间,随后利用冻结的Vicuna语言模型结合历史观测、目标视图、检索到的语义令牌和本体感知信息进行闭环规划。模型通过LoRA进行参数高效微调,训练目标包含航点预测的L1损失和停止决策的二元交叉熵损失。
背景与挑战
背景概述
VoLN-UAV数据集由北京航空航天大学的研究团队于2025年提出,旨在探索一种全新的无人机视觉导航范式——纯视觉长时域导航(Vision-Only Long-Horizon Navigation, VoLN)。传统视觉与语言导航(VLN)依赖外部指令提供路径级空间先验信息,如方向、距离和布局,但在全球定位系统缺失的开放环境中,这些信息无法直接从机载感知获得,导致模型性能难以剥离视觉能力与任务描述固有结构的影响。VoLN-UAV突破了这一局限,通过目标视图指定目的地,并将路径相关信息完全置于本地可观测的场景线索中,要求智能体自主检测、解读和选择相关信标。该基准包含7,210个跨17个不同环境的高保真仿真飞行片段,涵盖自然与建筑场景,为无人机在连续三维空间中的长距离导航研究提供了标准化评估平台,对推动视觉导航范式的演进具有重要意义。
当前挑战
VoLN-UAV所解决的领域核心挑战在于将路径相关信息从外部指令中剥离,迫使智能体仅依赖本地可观测的视觉线索进行长时域闭环导航。这涉及三大关键难题:其一,跨视角目标匹配,即无人机需在不同姿态、高度和尺度下重识别目标视图,这对视觉表征的鲁棒性提出极高要求;其二,在线线索选择与推理,环境中同时存在任务相关的主动信标和大量视觉相似的被动干扰信标,智能体必须实时区分、甄别并依据线索调整航向;其三,长时域证据累积与闭环稳定性,长达128步的决策过程中,局部路径预测的微小误差会随闭环反馈持续累积,导致轨迹偏移甚至任务失败。在构建过程中,研究团队还需应对多样化环境的场景建模、信标语义类别的合理设置以及多模态数据的同步采集与标注等工程挑战。
常用场景
经典使用场景
VoLN-UAV数据集专为纯视觉长程导航范式设计,其经典使用场景是评估无人机在无GPS、无全局地图、无语言指令的开放三维空间中,仅依赖机载摄像头观测、自身运动状态以及视觉目标图像,自主完成长距离目标导向飞行任务。研究者在仿真环境中构建了包含主动信标(提供路径指引)与被动信标(作为视觉干扰物)的复杂场景,要求智能体在线检测、理解并选择与任务相关的场景线索,并在闭环控制下生成短时域航点序列。该数据集尤其适合研究跨视角目标匹配、长程证据整合以及干扰环境下的鲁棒控制等核心问题,为纯视觉导航方法提供了标准化的训练与评测平台。
解决学术问题
VoLN-UAV数据集解决了当前视觉语言导航(VLN)领域中一个关键的方法论问题:传统指令式导航接口将路径结构、方向、距离等信息编码在任务描述中,使得基准性能难以剥离语言理解、视觉感知与路径结构利用的各自贡献。VoLN-UAV通过移除所有外部提供的路径指令和全局导航信号,将路径相关信息完全置于局部可观测的场景线索中,从而构建了一个更纯粹的视觉-语义推理难题。这一设计迫使研究者直面长程导航中证据在线整合、跨视角目标重识别、以及闭环执行误差累积等学术挑战,推动了导航范式从“跟随指令”向“自主推断”的转变,对理解智能体在开放环境中的自主决策能力具有重要的理论意义。
实际应用
在实际应用层面,VoLN-UAV数据集所定义的任务接口与真实世界中的无人机自主导航场景高度契合。例如,在灾害搜救、环境监测或军事侦察等任务中,无人机往往无法依赖GPS信号或预先规划的全局路径,仅能接收终点区域的视觉目标图像(如遇险者位置或目标地标),并依靠飞行途中观察到的自然线索(如河流、道路、建筑物)或预设信标进行实时路径决策。VoLN-UAV所模拟的信标选择、干扰物抑制、长距离飞行等挑战,直接映射到此类GPS拒止环境下无人机的自主任务执行能力,为实际系统从仿真向真实部署提供了关键的性能评估基准和算法验证支撑。
数据集最近研究
最新研究方向
VoLN-UAV数据集开创性地提出了纯视觉长时域导航(VoLN)新范式,突破了传统视觉语言导航(VLN)依赖语言指令和全局信号的局限。该数据集聚焦于无人机在连续三维空间中,仅通过机载视觉感知局部场景线索(如活跃信标)来完成长距离目标导向飞行,代表了具身智能从指令驱动向场景感知驱动的重大范式转变。当前前沿研究围绕视觉-语义对齐(如VoLN-MLLM方法将自监督视觉特征映射到语义空间)、跨视角目标匹配、闭环稳定性以及长时序证据整合等核心挑战展开。该基准包含7210个跨17种环境的航拍导航片段,区分了活跃与被动信标,并设置了难度分层,为评估无人机在无GPS、无地图的开放环境中的语义导航能力提供了关键测试平台,其低成功率(测试未见环境最高仅7.4%)揭示了该方向仍需突破的重大技术瓶颈。
相关研究论文
  • 1
    VoLN: Vision-Only Long-Horizon Navigation---Paradigm, Benchmark, and Method北京航空航天大学; 北京航空航天大学·杭州国际创新研究院 · 2026年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务