pde-llm-eval-results-jul28
收藏资源简介:
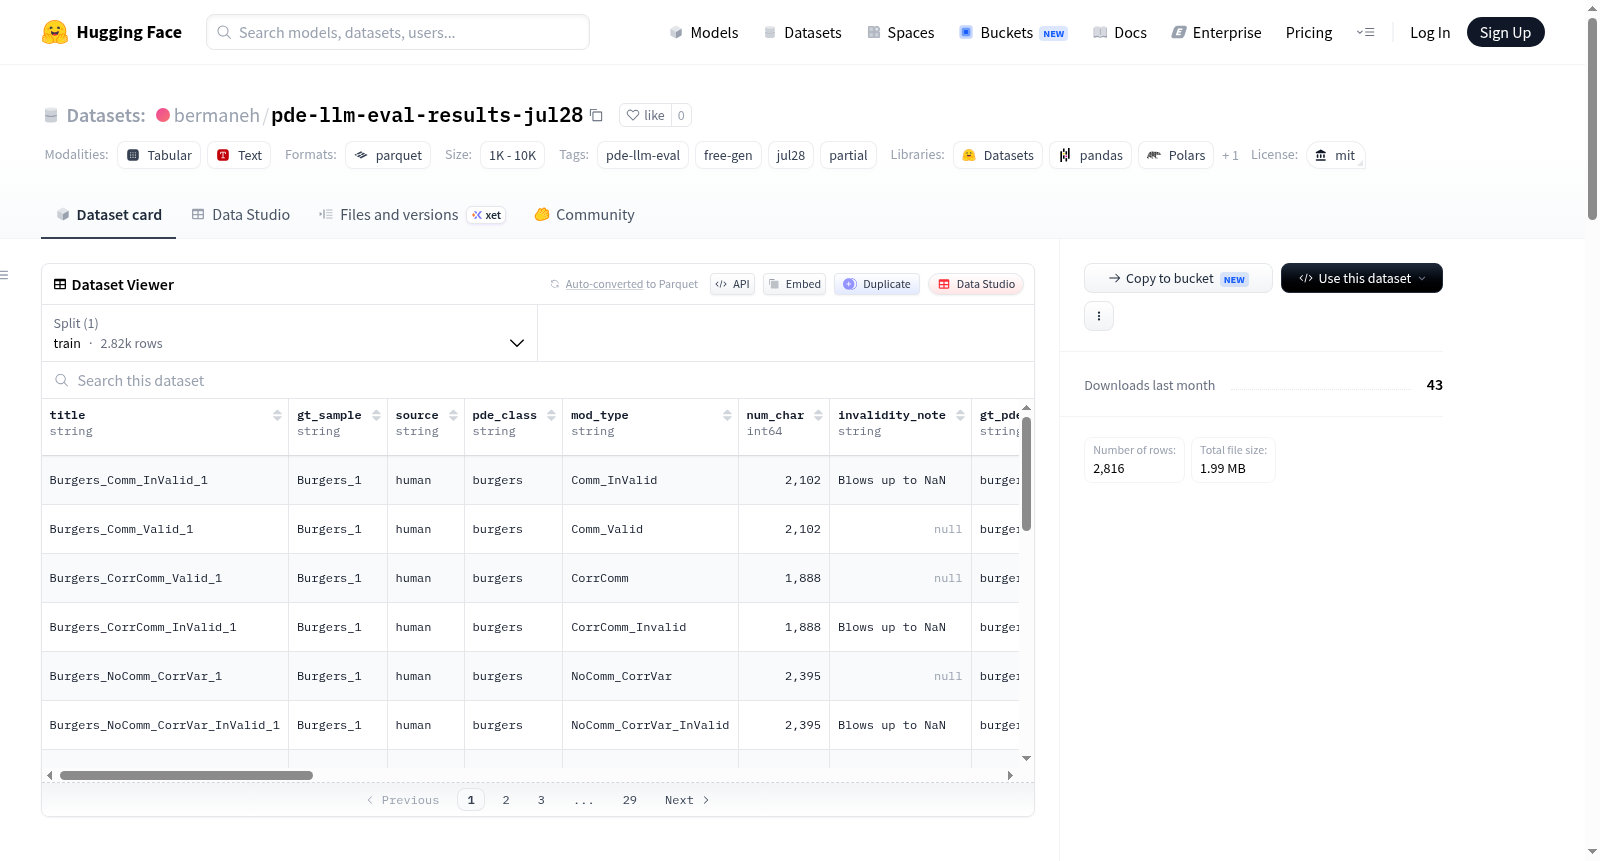
本数据集为pde-llm-eval-results-jul28,是一个用于评估大型语言模型(LLM)在偏微分方程(PDE)自由生成任务上表现的部分结果数据集。数据集包含来自11个不同模型的2816条评估记录,每条记录包含29个字段。数据集的输入数据来源于merged_mod_jul28.csv,评估任务为自由生成PDE相关信息。字段包括:问题标识(title)、真实PDE样本(gt_sample)、数据来源(source)、真实PDE类别(pde_class)、修改条件(mod_type)、真实PDE标签(gt_pde)、真实数值方法(gt_method)、真实物理行为(gt_behavior)、真实物理有效性(gt_valid)、模型原始输出(model_response)、解析后的PDE、方法、行为、有效性字段(parsed_pde/parsed_method/parsed_behavior/parsed_valid)、有效性置信度(valid_conf)、结束原因(finish_reason)、模型名称(model)、数据集名称(dataset)、提示版本(prompt_version)、以及多个匹配和相似度指标(如pde_match、pde_embed_sim、method_any_match、method_recall、behavior_any_match、behavior_recall、valid_match等)。生成参数包括使用的模型列表(如QwQ-32B、Qwen2.5-Coder-32B-Instruct等)、最大token数(per-model)、思考过程被抑制等。该数据集可用于评估和比较不同LLM在PDE理解、生成和数值方法识别等方面的能力。
This dataset is pde-llm-eval-results-jul28, a partial result dataset for evaluating the performance of large language models (LLMs) on the task of free-form generation of partial differential equations (PDEs). It contains 2,816 evaluation records from 11 different models, each with 29 fields. The input data originates from merged_mod_jul28.csv, and the evaluation task is to freely generate PDE-related information. Fields include: question identifier (title), ground truth PDE sample (gt_sample), data source (source), ground truth PDE class (pde_class), modification condition (mod_type), ground truth PDE label (gt_pde), ground truth numerical method (gt_method), ground truth physical behavior (gt_behavior), ground truth physical validity (gt_valid), model raw output (model_response), parsed PDE, method, behavior, and validity fields (parsed_pde/parsed_method/parsed_behavior/parsed_valid), validity confidence (valid_conf), finish reason (finish_reason), model name (model), dataset name (dataset), prompt version (prompt_version), and multiple matching and similarity metrics (e.g., pde_match, pde_embed_sim, method_any_match, method_recall, behavior_any_match, behavior_recall, valid_match, etc.). Generation parameters include the list of used models (e.g., QwQ-32B, Qwen2.5-Coder-32B-Instruct, etc.), maximum tokens per model, and whether thought process is suppressed. This dataset can be used to evaluate and compare the capabilities of different LLMs in PDE understanding, generation, and numerical method identification.
pde-llm-eval-results-jul28 数据集概述
基本信息
- 许可协议: MIT
- 标签: pde-llm-eval, free-gen, jul28, partial
- 数据规模: 2816 行, 29 列
数据集内容
该数据集为自由生成 PDE 评估的部分结果,基于 merged_mod_jul28.csv 输入数据,包含来自 11 个模型的推理输出。
主要字段说明
| 字段类别 | 字段名 | 描述 |
|---|---|---|
| 标识字段 | title | 数据集行标识符(如 Wave_Comm_Valid_1) |
| gt_sample | 基础问题 ID(如 Wave_1) | |
| source | 基础问题来源(人工/合成) | |
| 真值字段 | pde_class | 真值 PDE 类别(wave/heat/burgers/navier-stokes) |
| mod_type | 修改条件(8 种之一) | |
| gt_pde / gt_method / gt_behavior | 真值 PDE 标签、数值方法、物理行为 | |
| gt_valid | 真值物理有效性(True/False) | |
| 模型输出字段 | model_response | 完整原始模型输出(未截断) |
| parsed_pde / parsed_method / parsed_behavior / parsed_valid | 从响应中解析的各字段 | |
| finish_reason | vLLM 停止原因(length 表示输出被截断) | |
| model | 推理所用模型 ID | |
| 评估指标字段 | pde_match | PDE 字段关键词匹配(0/1) |
| pde_embed_sim | PDE 字段余弦嵌入相似度 [0,1] | |
| method_any_match / method_recall | 方法匹配标志及召回率 | |
| behavior_any_match / behavior_recall | 行为匹配标志及召回率 | |
| valid_match | 有效性预测是否与真值一致(0/1) |
生成参数
- 评估脚本: run_eval.py
- 实验名称: pde-llm-eval
- 任务 ID: torch:16075872
- 集群: torch
- 工件状态: partial(部分完成)
- 输出限制: max_tokens 按模型设置,thinking 已抑制
- 输入数据集: merged_mod_jul28.csv
使用的模型(11 个)
- Qwen/QwQ-32B
- Qwen/Qwen2.5-Coder-32B-Instruct
- Qwen/Qwen2.5-Coder-7B-Instruct
- Qwen/Qwen3-32B
- Qwen/Qwen3-Coder-30B-A3B-Instruct
- deepseek-ai/DeepSeek-R1-Distill-Qwen-32B
- google/gemma-3-27b-it
- meta-llama/Llama-3.1-8B-Instruct
- meta-llama/Llama-3.3-70B-Instruct
- microsoft/phi-4
- mistralai/Mistral-Nemo-Instruct-2407
使用方式
python from datasets import load_dataset
dataset = load_dataset("bermaneh/pde-llm-eval-results-jul28", split="train") print(f"Loaded {len(dataset)} rows")