
遇见数据集

MeasureBenchClock-DiverseSynthetic

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

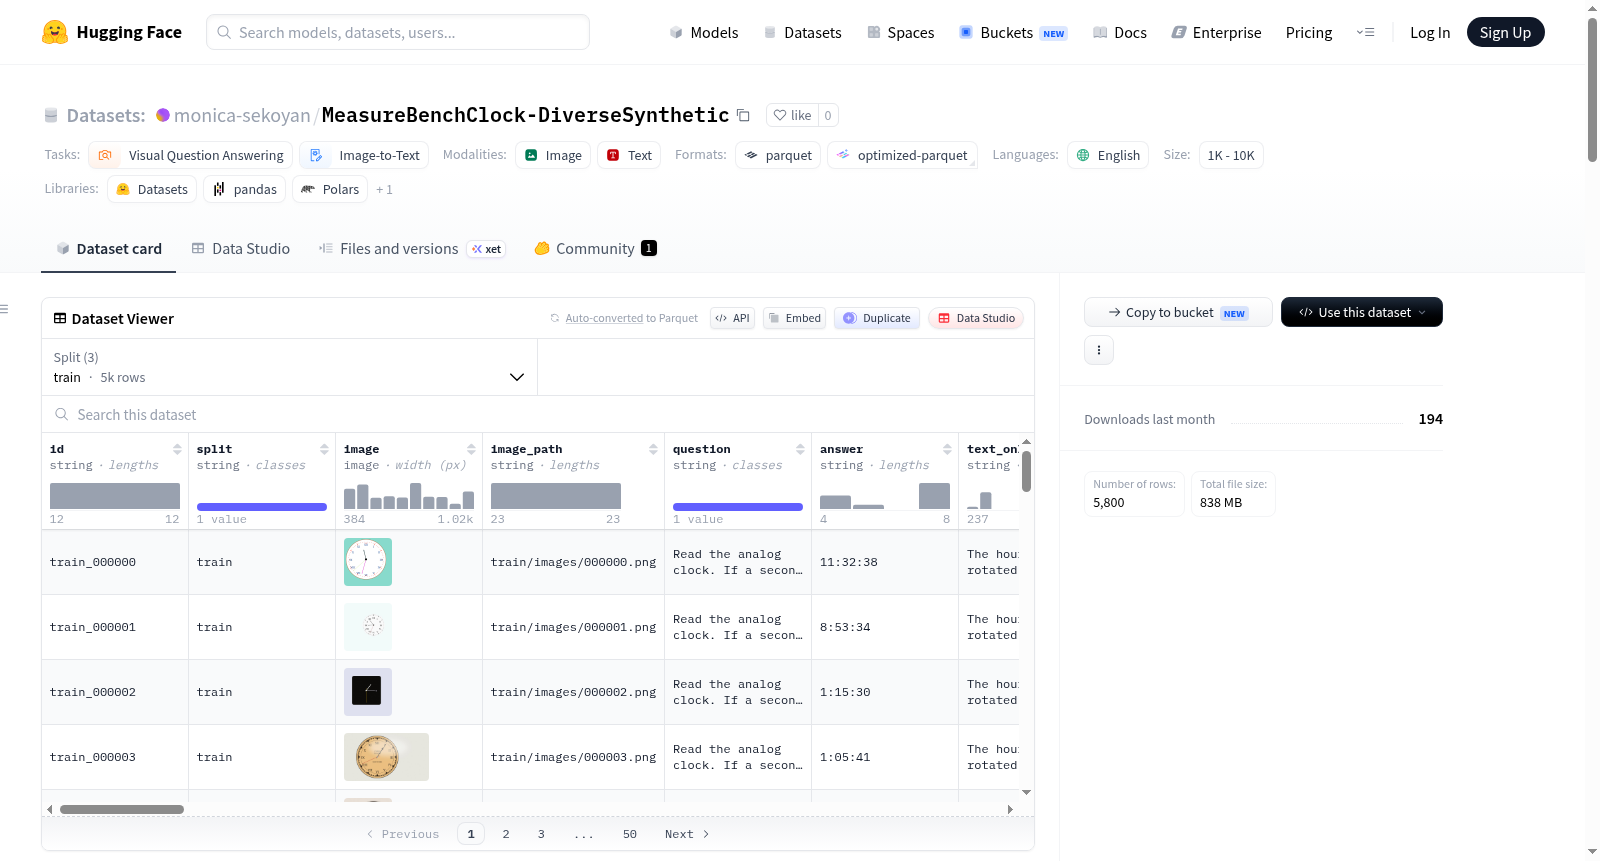
MeasureBenchClock-Diverse-Synthetic是一个用于模拟时钟读数的合成数据集,基于修改和多样化的MeasureBench时钟生成代码创建。该数据集包含5800个样本,分为训练集(5000个样本)、开发集(300个样本)和测试集(500个样本)。每个样本包含生成的模拟时钟图像、基于图像的问题、标准答案以及多种文本形式的问题和答案变体。数据集还提供了详细的时间信息(小时、分钟、秒)、视觉属性(表盘形状、主题、样式)、几何属性(时钟位置、半径、裁剪情况)和生成元数据。答案格式根据秒针可见性自动调整:秒针可见时使用H:MM:SS格式,不可见时使用H:MM格式。该数据集旨在支持模拟时钟读数任务的监督微调和强化学习实验,特别适用于合成数据训练、多模态推理和模型鲁棒性研究。由于图像是合成生成的,可能不完全匹配真实世界时钟的视觉特征,但通过多样化的生成配置(包括分辨率、布局、颜色方案等)提高了数据的多样性。

MeasureBenchClock-Diverse-Synthetic is a synthetic dataset for simulating clock reading, created based on modified and diversified MeasureBench clock generation code. It contains 5800 samples, divided into a training set (5000 samples), a development set (300 samples), and a test set (500 samples). Each sample includes generated simulated clock images, image-based questions, standard answers, and multiple textual variants of questions and answers. The dataset also provides detailed time information (hours, minutes, seconds), visual attributes (dial shape, theme, style), geometric attributes (clock position, radius, cropping status), and generation metadata. The answer format is automatically adjusted based on second-hand visibility: using H:MM:SS format when the second hand is visible, and H:MM format when it is not. This dataset aims to support supervised fine-tuning and reinforcement learning experiments for clock reading tasks, particularly suitable for synthetic data training, multimodal reasoning, and model robustness research. Since the images are synthetically generated, they may not fully match the visual characteristics of real-world clocks, but data diversity is enhanced through diverse generation configurations, including resolution, layout, color schemes, etc.

创建时间:
2026-06-18
搜集汇总
数据集介绍
MeasureBenchClock-DiverseSynthetic 数据集图片
构建方式
MeasureBenchClock-DiverseSynthetic是一个基于改进版MeasureBench时钟生成代码构建的合成模拟时钟读数数据集。该数据集通过高度可配置的合成模拟时钟渲染器生成图像,生成过程中系统性地变化分辨率、时钟位置、表盘形状、调色板、背景、指针样式、刻度标记、数字、秒针可见性以及时钟布局等多维参数。每一样本均包含精确的时间标签(时、分、秒)及详细的几何元数据,如时钟中心坐标、半径、裁剪状态等,为模型提供了丰富的结构化信息。
特点
该数据集的核心特点在于其多样性与细致标注的结合。图像生成策略涵盖了从视觉主题、布局到指针样式的广泛变化,有效提升模型的泛化鲁棒性。数据集提供了多模态问题形式,包括纯图像问题、基于角度的纯文本问题以及基于刻度位置的纯文本问题,同时包含了要求逐步推理的扩展问题版本。此外,所有样本均记录了详尽的几何属性,如时钟面积占比、中心偏移量、裁剪边界距离等,为分析模型在空间理解上的表现提供了坚实基础。
使用方法
该数据集适用于监督微调与强化学习实验,旨在训练和评估模型在模拟时钟读数上的能力。用户可根据需要选择标准图像问答对进行基础训练,或利用文本仅含版本进行跨模态对比研究。扩展问题版本支持模型逐步推理能力的培养。数据集已划分为训练集(5000样本)、开发集(300样本)和测试集(500样本),便于实验设计。通过丰富的几何元数据字段,研究者可深入分析模型在不同空间配置下的性能差异。
背景与挑战
背景概述
MeasureBenchClock-DiverseSynthetic是一款合成模拟时钟读数数据集,由研究人员基于改良版MeasureBench时钟生成代码创建。该数据集的核心研究问题在于评估和提升多模态大语言模型在类比时间阅读任务上的表现,尤其关注细粒度视觉与数值推理的结合。其发布时间较新,旨在为监督微调和强化学习实验提供标准化基准。通过引入多样化的视觉风格、表盘形状、指针样式和布局策略,数据集推动了视觉问答领域对低层次几何与时间测量任务的研究,为未来模型在真实世界时钟图像上的鲁棒性评估奠定了基础。
当前挑战
该数据集旨在解决模拟时钟精准阅读这一领域难题,涉及将二维空间位置(指针角度)转化为时间值的精确推理,对多模态模型的视觉定位与数值转换能力提出严峻考验。构建过程中的挑战包括生成视觉上多样化的样本以覆盖现实变异,如部分裁剪、不同分辨率及指针可见性变化,同时确保标注的准确性与一致性。此外,需设计文本与图像混合的问题变体,以分离视觉与语言线索的影响,并避免模型依赖琐碎捷径,从而提升数据集的评估有效性和泛化能力。
常用场景
经典使用场景
在视觉问答与多模态推理的研究领域中,模拟时钟读取任务因兼具视觉理解与符号解析的双重挑战而备受关注。MeasureBenchClock-DiverseSynthetic 数据集通过合成生成技术,系统性地引入了多样化的视觉风格、表盘布局、指针形态与裁剪情况,为评估与微调多模态大模型在精细时间读取任务上的表现提供了标准化的基准。研究者可以基于该数据集开展监督微调实验,借助其丰富的元数据字段(如指针角度、表盘可见比例等)深入分析模型在不同视觉干扰下的鲁棒性,从而推动多模态模型从粗粒度物体识别迈向细粒度符号理解的范式跃迁。
实际应用
在实际应用层面,该数据集所催生的高效时钟读取模型可无缝嵌入多个垂直领域。例如,在智能文档处理系统中,对票据、合同等图片中的钟表图案进行自动时间转录可实现关键信息提取的自动化;在辅助视障人士的交互式应用中,模型能将摄像头捕获的壁钟图像实时转化为精确的语音时间播报;此外,在工业质检场景中,对仪表盘指针角度的毫米级判读亦与该任务高度相通。数据集提供的多分辨率与表盘可见性变异,恰好模拟了真实场景中因设备差异或视角变化带来的输入质量波动,使得基于此训练的系统具备更优的域外泛化能力。
衍生相关工作
围绕该数据集已衍生出若干具有启发性的研究方向与经典工作。一方面,研究者利用其提供的基于角度的文本版问题设计思想,构建了多模态模型的课程学习流程——模型先通过纯符号推理学会时间转换逻辑,再逐步引入视觉噪声进行联合训练。另一方面,数据集中关于表盘裁剪程度的精细标注(如可见时钟边界框比例、接近裁剪的边缘类别等字段)催生了对视觉Transformer注意力机制的空间敏感性分析工作,揭示了模型在信息缺失时对局部特征的重构能力。此外,扩展问答字段(如要求模型输出分步推理过程)也促使了思维链提示技术在多模态时钟读取任务中的系统化评估与改进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

