Omni-Fake-OOD
收藏资源简介:
Omni-Fake-OOD是Omni-Fake项目的分布外(OOD)基准测试分割数据集,用于评估深度伪造检测模型在未见过的生成器和平台上的跨领域泛化能力。它与分布内训练数据集Omni-Fake-SET配套使用,覆盖图像、音频、视频以及音频-视频说话头四种模态,统一采用三分类标签体系:真实、完全合成和篡改。数据规模中等偏大,在10万到100万样本之间;具体到OOD视频部分,包含22,000个视频片段,其中1,000个真实、1,000个完全合成和20,000个篡改样本。数据集提供多个配置:image配置包含图像、掩码(用于指示篡改区域)和标签;audio配置包含音频、标签及伪造时间区间;video和avth配置包含视频和标签等字段。该数据集适用于图像分类、音频分类、视频分类等任务,尤其专注于深度伪造检测、多媒体取证和多模态学习领域的研究与评估。
Omni-Fake-OOD is the out-of-distribution (OOD) benchmark split dataset of the Omni-Fake project, designed to evaluate the cross-domain generalization capability of deepfake detection models on unseen generators and platforms. It is used in conjunction with the in-distribution training dataset Omni-Fake-SET, covering four modalities: image, audio, video, and audio-video talking head (AV-TH), and uniformly adopts a three-class label system: real, fully synthetic, and tampered. The dataset size is medium to large, ranging from 100,000 to 1,000,000 samples; specifically for the OOD video part, it includes 22,000 video clips, with 1,000 real, 1,000 fully synthetic, and 20,000 tampered samples. The dataset contains multiple configurations: the image configuration includes images, masks (for indicating tampered regions), and labels; the audio configuration includes audio, labels, and forgery time intervals; the video and avth configurations include video, labels, and other fields. It is suitable for tasks such as image classification, audio classification, and video classification, with a particular focus on research and evaluation in deepfake detection, multimedia forensics, and multimodal learning.
数据集总览
Omni-Fake-OOD 是 Omni-Fake 基准的分布外(OOD)评测子集,专为衡量深度伪造检测模型在跨域泛化场景下的表现而设计。其样本来自训练集中未出现的生成器与平台,与分布内(ID)训练数据集 Omni-Fake-SET 配合使用。数据集涵盖图像、音频、视频及**音视频说话人脸(AV-TH)**四种模态,所有样本均采用统一的三分类标签:real(真实)、full_synthetic(全合成)及 tampered(篡改)。
- 论文地址: arXiv:2605.01638
- 项目主页: Omni-Fake
- 许可协议: CC-BY-4.0
数据集规模与构成
| 模态 | 配置名称 | 数据总量 | 详细构成 |
|---|---|---|---|
| 图像 | image |
未明确总数 | 包含 image、mask、label、generator、filename、split 字段 |
| 音频 | audio |
未明确总数 | 包含 audio、label、generator、filename、split、spoof_intervals 字段 |
| 视频 | video |
22,000 个片段 | 1,000 真实 + 1,000 全合成 + 20,000 篡改 |
| 音视频说话人脸 | avth |
未明确总数 | 包含 video、label、generator、filename、split 字段 |
视频模态特别说明:
- 真实 + 全合成 片段(共 2,000 个)来源于 GenBuster-200K 封闭基准中的 8 个商业生成器,以
data/Video/video-ood.7z压缩包形式提供,解压后按real/full_synthetic目录存放。 - 篡改 片段(共 20,000 个)来源于 Omni-Fake PartialEdit OOD,以 Parquet 格式文件
data/Video/test-*.parquet存储。
数据加载与使用
通过 Hugging Face datasets 库可按配置加载:
python from datasets import load_dataset
图像(默认配置)
ds_img = load_dataset("JamalLee/Omni-Fake-OOD", "image")
音频
ds_aud = load_dataset("JamalLee/Omni-Fake-OOD", "audio")
视频(仅篡改部分,通过 Parquet 加载)
ds_vid = load_dataset("JamalLee/Omni-Fake-OOD", "video")
真实 + 全合成部分需解压 data/Video/video-ood.7z
音视频说话人脸
ds_avth = load_dataset("JamalLee/Omni-Fake-OOD", "avth")
各模态数据字段说明
| 模态 | 数据字段 |
|---|---|
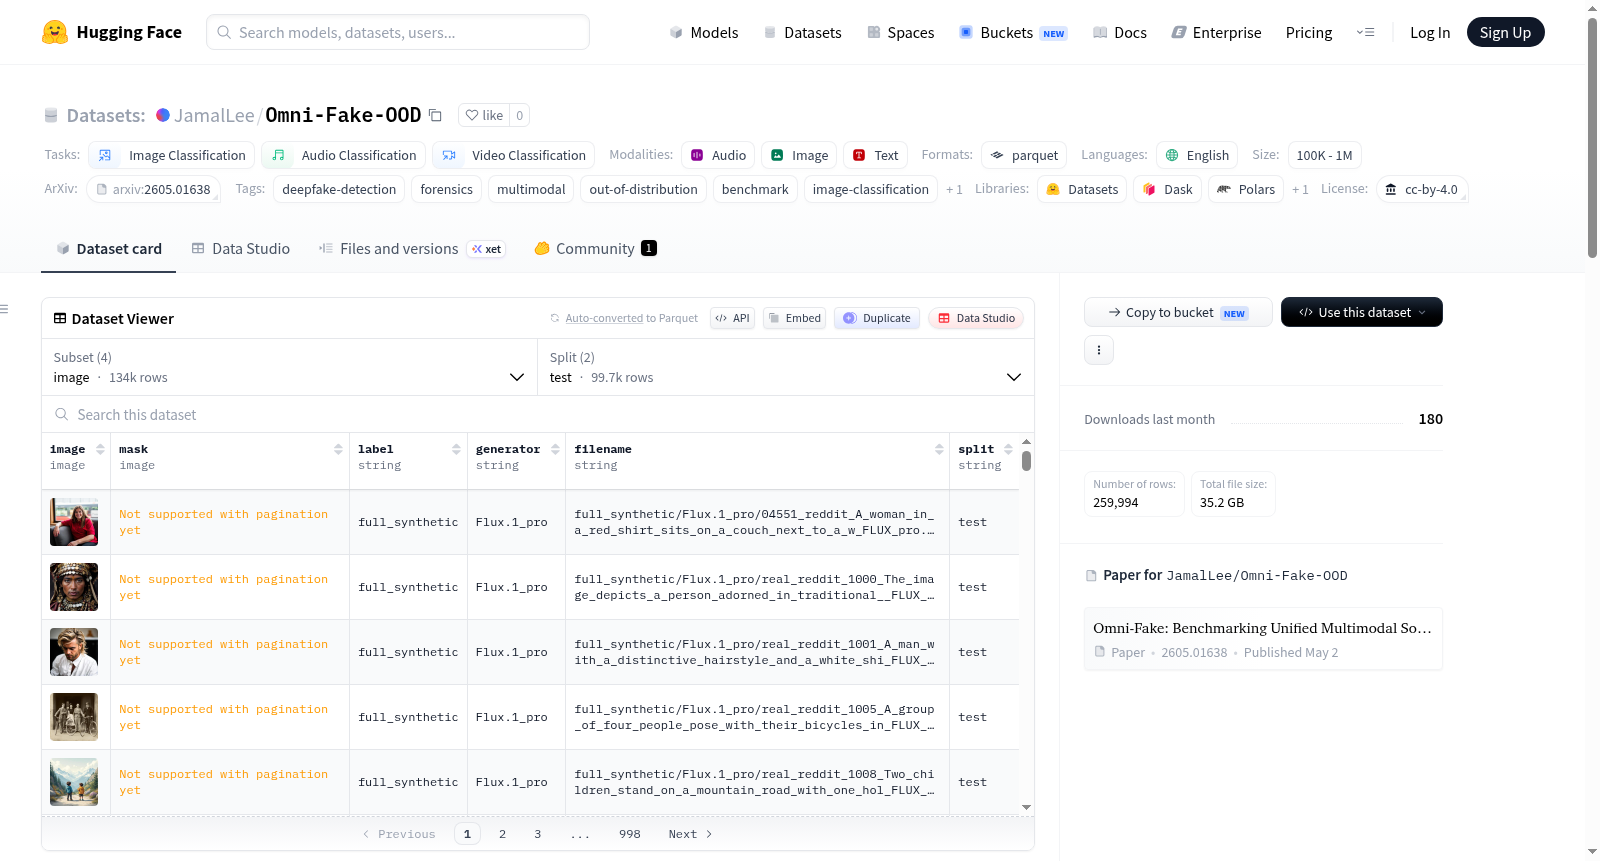
| 图像 | image(图像)、mask(篡改掩码)、label(标签)、generator(生成器)、filename(文件名)、split(划分) |
| 音频 | audio(音频)、label(标签)、generator(生成器)、filename(文件名)、split(划分)、spoof_intervals(欺骗时间区间,序列) |
| 视频(Parquet 格式,仅篡改) | video(视频)、label(标签)、generator(生成器)、filename(文件名)、split(划分) |
| 视频(.7z 压缩包,真实+全合成) | 解压后目录结构为 real / full_synthetic,直接按文件名访问片段 |
| 音视频说话人脸 | video(视频)、label(标签)、generator(生成器)、filename(文件名)、split(划分) |
标签取值: real、full_synthetic、tampered(图像与视频均采用此三分类体系)。
数据集查看器
在 Hugging Face 数据集页面中,Dataset Viewer 选项卡默认选中 image 子集,可预览 image 列的缩略图;当 mask 可用时,可显示篡改区域。切换子集至 video、audio 或 avth 可查看其他模态的数据。
引用方式
bibtex @article{li2026omnifake, title={Omni-Fake: Benchmarking Unified Multimodal Social Media Deepfake Detection}, author={Li, Tianxiao and Huang, Zhenglin and Wen, Haiquan and others}, journal={arXiv preprint arXiv:2605.01638}, year={2026} }