ymoslem/Tatoeba-Translations
收藏资源简介:
--- dataset_info: features: - name: id_src dtype: int64 - name: lang_src dtype: string - name: sentence_src dtype: string - name: id_tgt dtype: int64 - name: lang_tgt dtype: string - name: sentence_tgt dtype: string - name: lang_pair sequence: string splits: - name: train num_bytes: 1144194352 num_examples: 8547819 download_size: 726390210 dataset_size: 1144194352 configs: - config_name: default data_files: - split: train path: data/train-* language: - multilingual - ab - af - am - ar - an - as - av - ay - az - ba - bm - be - bn - bi - bo - bs - br - bg - ca - cs - ch - ce - cv - kw - co - cy - da - de - dv - el - en - eo - et - eu - ee - fo - fj - fi - fr - fy - gd - ga - gl - gv - gn - gu - ht - ha - he - hi - hr - hu - hy - ig - io - ii - ie - ia - id - is - it - jv - ja - kl - kn - ks - ka - kk - km - rw - ky - ko - lo - la - li - ln - lt - lb - lg - mh - ml - mr - mk - mg - mt - mn - mi - my - na - nv - nl - nn - nb - ny - oc - oj - or - os - pa - pi - pl - pt - ps - qu - rm - ro - rn - ru - sg - sa - si - sk - sl - se - sm - sn - sd - so - st - es - sq - sc - sr - ss - su - sv - ty - ta - tt - te - tg - tl - th - ti - to - tn - ts - tk - tr - ug - uk - ur - uz - vi - vo - wa - wo - xh - yi - yo - zu license: cc-by-2.0 task_categories: - translation size_categories: - 1M<n<10M --- ## Dataset Details This is the latest version of Tatoeba translations as of December 2024. The sentences are downloaded from the [Tatoeba collection website](https://tatoeba.org/en/downloads). The dataset is processed through mapping `sentences.tar.bz2` using `sentences_base.tar.bz2` to find source (`sentence_src`) and target (`sentence_tgt`) sentences. While `lang_src` and `lang_tgt` columns follow the mapping provided by Tatoeba, the `lang_pair` column merely lists the two languages in the translation pair. ### Statistics The Tatoeba dataset includes 8,547,819 unique translation pairs in 414 languages, covering ~5,917 language pairs. ### Languages The dataset includes the 414 languages: <details> <summary>Show the full list of languages.</summary> Abkhazian (abk), Adyghe (ady), Afrihili (afh), Afrikaans (afr), Ainu (Japan) (ain), Albanian (sqi), Algerian Arabic (arq), Amharic (amh), Ancient Greek (to 1453) (grc), Ancient Hebrew (hbo), Arabic (ara), Aragonese (arg), Armenian (hye), Assamese (asm), Assyrian Neo-Aramaic (aii), Asturian (ast), Avaric (ava), Awadhi (awa), Aymara (aym), Azerbaijani (aze), Balinese (ban), Baluchi (bal), Bambara (bam), Banjar (bjn), Bashkir (bak), Basque (eus), Bavarian (bar), Baybayanon (bvy), Belarusian (bel), Bengali (ben), Berber languages (ber), Berom (bom), Bhojpuri (bho), Bislama (bis), Bodo (India) (brx), Bosnian (bos), Breton (bre), Brithenig (bzt), Bulgarian (bul), Buriat (bua), Burmese (mya), Catalan (cat), Cayuga (cay), Cebuano (ceb), Central Bikol (bcl), Central Huasteca Nahuatl (nch), Central Kanuri (knc), Central Kurdish (ckb), Central Mnong (cmo), Central Okinawan (ryu), Chagatai (chg), Chamorro (cha), Chavacano (cbk), Chechen (che), Cherokee (chr), Chinese Pidgin English (cpi), Chinook jargon (chn), Choctaw (cho), Chukot (ckt), Chuvash (chv), Classical Syriac (syc), Congo Swahili (swc), Cornish (cor), Corsican (cos), Creek (mus), Crimean Tatar (crh), Croatian (hrv), Cuyonon (cyo), Czech (ces), Danish (dan), Dhivehi (div), Dimli (individual language) (diq), Drents (drt), Dungan (dng), Dutch (nld), Dutton World Speedwords (dws), Eastern Canadian Inuktitut (ike), Eastern Mari (mhr), Egyptian Arabic (arz), Emilian (egl), English (eng), Erromintxela (emx), Erzya (myv), Esperanto (epo), Estonian (est), Evenki (evn), Ewe (ewe), Extremaduran (ext), Faroese (fao), Fiji Hindi (hif), Fijian (fij), Finnish (fin), French (fra), Friulian (fur), Ga (gaa), Gagauz (gag), Galician (glg), Gan Chinese (gan), Ganda (lug), Garhwali (gbm), Georgian (kat), German (deu), Gheg Albanian (aln), Gilbertese (gil), Goan Konkani (gom), Gothic (got), Gronings (gos), Guadeloupean Creole French (gcf), Guarani (grn), Guerrero Nahuatl (ngu), Gujarati (guj), Gulf Arabic (afb), Gun (guw), Haitian (hat), Hakka Chinese (hak), Hausa (hau), Hawaiian (haw), Hebrew (heb), Hiligaynon (hil), Hindi (hin), Hmong Daw (mww), Hmong Njua (hnj), Ho (hoc), Hungarian (hun), Hunsrik (hrx), Iban (iba), Icelandic (isl), Ido (ido), Igbo (ibo), Iloko (ilo), Indonesian (ind), Ingrian (izh), Interglossa (igs), Interlingua (International Auxiliary Language Association) (ina), Interlingue (ile), Iranian Persian (pes), Irish (gle), Italian (ita), Jamaican Creole English (jam), Japanese (jpn), Javanese (jav), Jewish Babylonian Aramaic (ca. 200-1200 CE) (tmr), Jewish Palestinian Aramaic (jpa), Jinyu Chinese (cjy), Judeo-Tat (jdt), K'iche' (quc), Kabardian (kbd), Kabyle (kab), Kadazan Dusun (dtp / kzj), Kalaallisut (kal), Kalmyk (xal), Kamba (Kenya) (kam), Kannada (kan), Kara-Kalpak (kaa), Karachay-Balkar (krc), Karakhanid (xqa), Karelian (krl), Kashmiri (kas), Kashubian (csb), Kazakh (kaz), Kekchí (kek), Keningau Murut (kxi), Khakas (kjh), Khalaj (klj), Khasi (kha), Khmer (khm), Kinyarwanda (kin), Kirghiz (kir), Kirmanjki (individual language) (kiu), Klingon (tlh), Komi-Permyak (koi), Komi-Zyrian (kpv), Korean (kor), Kotava (avk), Kriang (ngt), Kumyk (kum), Kven Finnish (fkv), Kölsch (ksh), Ladin (lld), Ladino (lad), Lakota (lkt), Lao (lao), Latgalian (ltg), Latin (lat), Laz (lzz), Levantine Arabic (apc / ajp), Lezghian (lez), Libyan Arabic (ayl), Ligurian (lij), Limburgan (lim), Lingala (lin), Lingua Franca Nova (lfn), Literary Chinese (lzh), Lithuanian (lit), Liv (liv), Lojban (jbo), Lombard (lmo), Louisiana Creole (lou), Low German (nds), Lower Sorbian (dsb), Lushootseed (lut), Luxembourgish (ltz), Láadan (ldn), Macedonian (mkd), Madurese (mad), Mahasu Pahari (bfz), Maithili (mai), Malagasy (mlg), Malay (individual language) (zlm), Malayalam (mal), Maltese (mlt), Mambae (mgm), Manchu (mnc), Mandarin Chinese (cmn), Manipuri (mni), Manx (glv), Maori (mri), Mapudungun (arn), Marathi (mar), Marshallese (mah), Mesopotamian Arabic (acm), Mi'kmaq (mic), Middle English (1100-1500) (enm), Middle French (ca. 1400-1600) (frm), Mikasuki (mik), Min Nan Chinese (nan), Minangkabau (min), Mingrelian (xmf), Mirandese (mwl), Modern Greek (1453-) (ell), Mohawk (moh), Moksha (mdf), Mon (mnw), Mongolian (mon), Mono (USA) (mnr), Morisyen (mfe), Moroccan Arabic (ary), Nahuatl languages (nah), Nande (nnb), Nauru (nau), Navajo (nav), Neapolitan (nap), Nepali (individual language) (npi), Nigerian Fulfulde (fuv), Niuean (niu), Nogai (nog), North Moluccan Malay (max), Northeastern Thai (tts), Northern Frisian (frr), Northern Haida (hdn), Northern Kurdish (kmr), Northern Sami (sme), Norwegian Bokmål (nob), Norwegian Nynorsk (nno), Novial (nov), Nuer (nus), Nyanja (nya), Nyungar (nys), Occitan (post 1500) (oci), Ojibwa (oji), Old Aramaic (up to 700 BCE) (oar), Old English (ca. 450-1100) (ang), Old French (842-ca. 1400) (fro), Old Frisian (ofs), Old Norse (non), Old Russian (orv), Old Saxon (osx), Old Spanish (osp), Old Turkish (otk), Oriya (macrolanguage) (ori), Orizaba Nahuatl (nlv), Ossetian (oss), Ottoman Turkish (1500-1928) (ota), Pahlavi (pal), Palauan (pau), Pali (pli), Pampanga (pam), Pangasinan (pag), Panjabi (pan), Papiamento (pap), Pattani Malay (mfa), Pennsylvania German (pdc), Pfaelzisch (pfl), Phoenician (phn), Picard (pcd), Piemontese (pms), Pipil (ppl), Plains Cree (crk), Polish (pol), Portuguese (por), Prussian (prg), Pulaar (fuc), Pushto (pus), Qashqa'i (qxq), Quechua (que), Quenya (qya), Rapanui (rap), Rohingya (rhg), Romanian (ron), Romansh (roh), Romany (rom), Rundi (run), Russian (rus), Rusyn (rue), Samoan (smo), Samogitian (sgs), Sango (sag), Sanskrit (san), Santali (sat), Saraiki (skr), Sardinian (srd), Saterfriesisch (stq), Scots (sco), Scottish Gaelic (gla), Serbian (srp), Seselwa Creole French (crs), Shona (sna), Shuswap (shs), Sichuan Yi (iii), Sicilian (scn), Silesian (szl), Sindarin (sjn), Sindhi (snd), Sinhala (sin), Slovak (slk), Slovenian (slv), Somali (som), Southern Altai (alt), Southern Haida (hax), Southern Kurdish (sdh), Southern Sami (sma), Southern Sotho (sot), Southern Subanen (laa), Spanish (spa), Sranan Tongo (srn), Standard Latvian (lvs), Standard Malay (zsm), Standard Moroccan Tamazight (zgh), Sumerian (sux), Sundanese (sun), Swabian (swg), Swahili (individual language) (swh), Swati (ssw), Swedish (swe), Swiss German (gsw), Sylheti (syl), Tachawit (shy), Tachelhit (shi), Tagal Murut (mvv), Tagalog (tgl), Tahaggart Tamahaq (thv), Tahitian (tah), Tajik (tgk), Talossan (tzl), Talysh (tly), Tamil (tam), Tarifit (rif), Tase Naga (nst), Tatar (tat), Telugu (tel), Temuan (tmw), Tetum (tet), Thai (tha), Tibetan (bod), Tigre (tig), Tigrinya (tir), Tohono O'odham (ood), Tok Pisin (tpi), Tokelau (tkl), Toki Pona (tok), Tonga (Tonga Islands) (ton), Tonga (Zambia) (toi), Tsonga (tso), Tswana (tsn), Tumbuka (tum), Tupinambá (tpn / tpw), Turkish (tur), Turkmen (tuk), Tuvalu (tvl), Tuvinian (tyv), Uab Meto (aoz), Udmurt (udm), Uighur (uig), Ukrainian (ukr), Umbundu (umb), Upper Sorbian (hsb), Urdu (urd), Urhobo (urh), Uzbek (uzb), Venetian (vec), Veps (vep), Vietnamese (vie), Volapük (vol), Võro (vro), Walloon (wln), Waray (Philippines) (war), Wayuu (guc), Welsh (cym), Western Armenian (hyw), Western Frisian (fry), Western Mari (mrj), Western Panjabi (pnb), Wolof (wol), Wu Chinese (wuu), Xhosa (xho), Xiang Chinese (hsn), Yakut (sah), Yiddish (yid), Yoruba (yor), Yucateco (yua), Yue Chinese (yue), Zaza (zza), Zeeuws (zea), Zulu (zul) </details> ### Contact The dataset was processed and brought to Hugging Face by [ymoslem](https://huggingface.co/ymoslem).
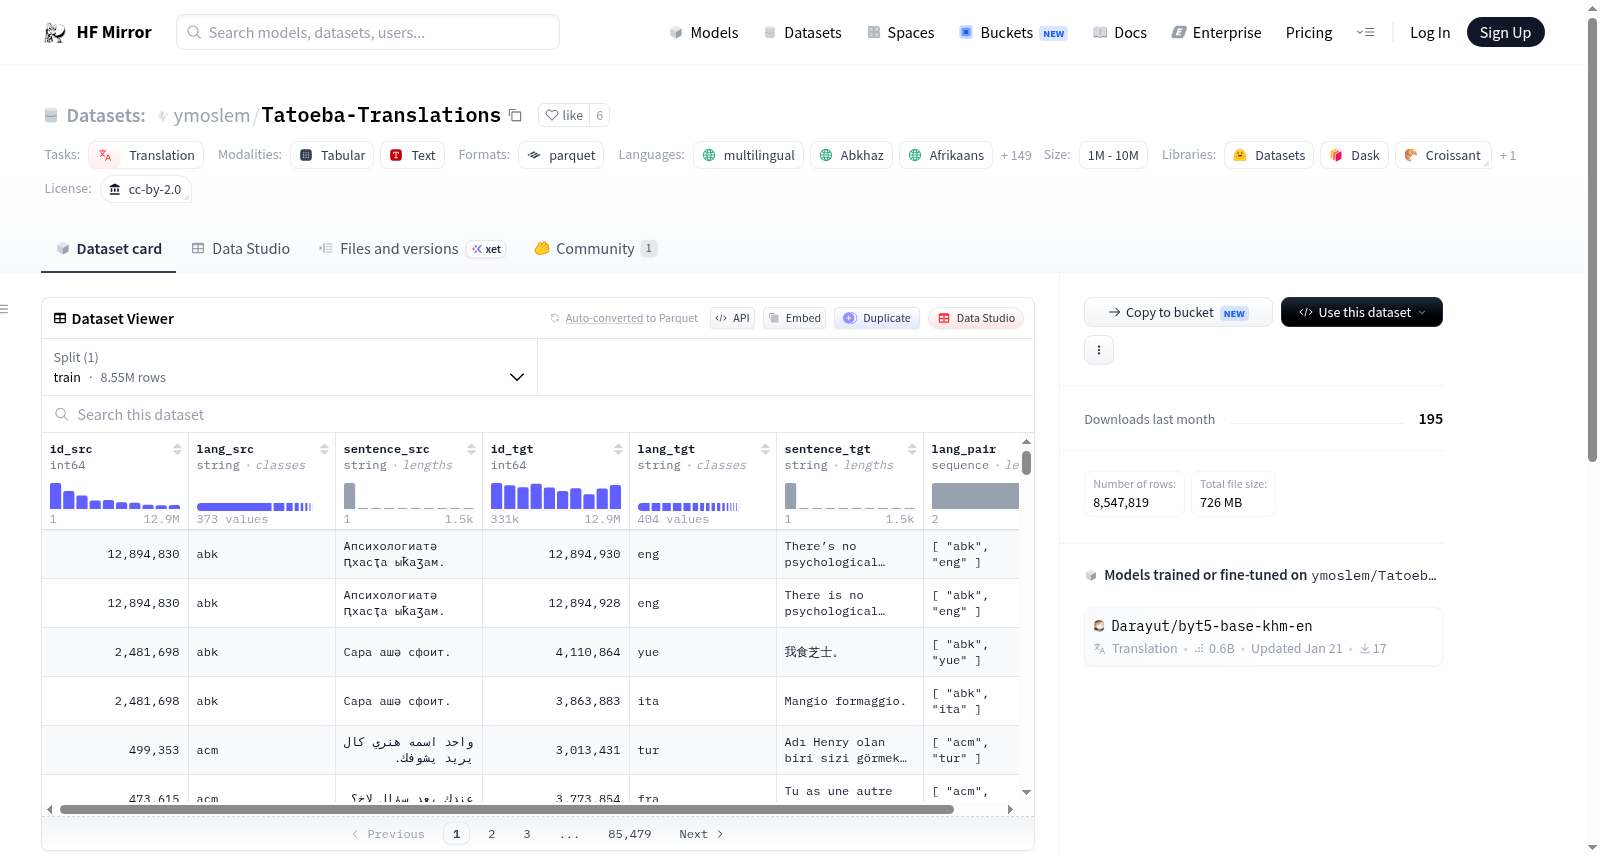
This is the latest version of Tatoeba translations as of December 2024. The sentences are downloaded from the Tatoeba collection website and processed through mapping `sentences.tar.bz2` using `sentences_base.tar.bz2` to find source (`sentence_src`) and target (`sentence_tgt`) sentences. The dataset includes 8,547,819 unique translation pairs in 414 languages, covering ~5,917 language pairs. The features of the dataset include id_src, lang_src, sentence_src, id_tgt, lang_tgt, sentence_tgt, and lang_pair. The dataset size is 1,144,194,352 bytes with 8,547,819 examples. The dataset is licensed under cc-by-2.0, with task categories as translation and size categories as 1M<n<10M.