app-store-apps-charts-reviews-sample
收藏资源简介:
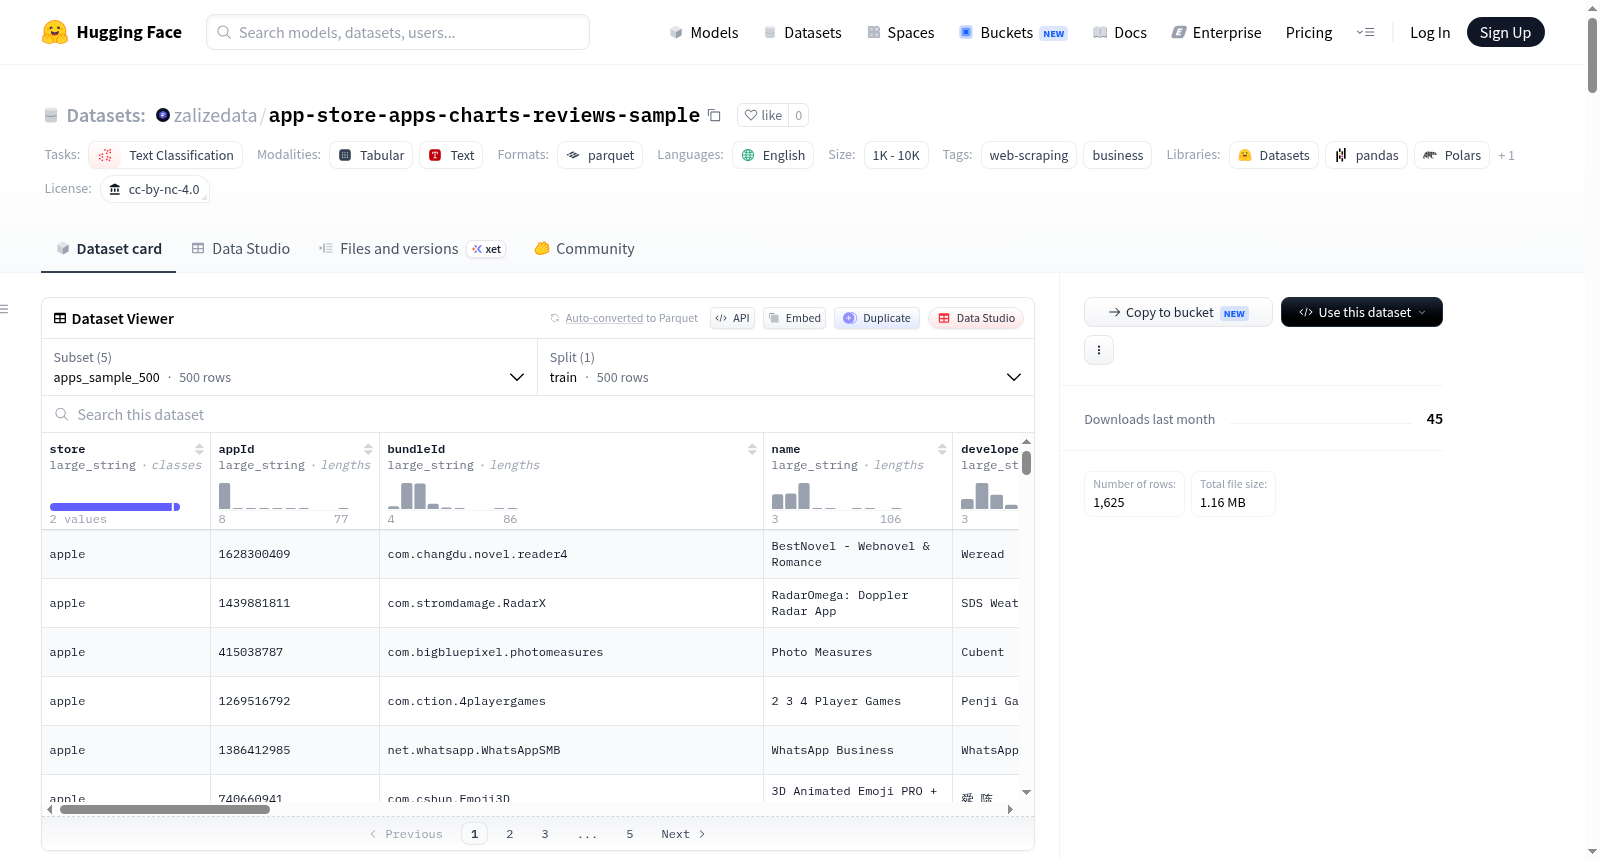
该数据集是移动应用智能数据的免费样本,包含来自 Apple 官方公开 API(iTunes RSS 图表、搜索和查找)以及 Google Play 公开页面的 6,384 个应用图表数据。数据集提供多种配置:应用元数据样本(apps_sample_500,500 行,包含名称、开发者、类别、评分、评分数量、价格、内购、发布日期、更新日期、大小、内容评级等字段)、高机会应用样本(apps_top_opportunity_sample,100 行,包含需求评分、痛点评分、机会指数等字段)、类别机会数据(category_opportunity,25 行,涵盖所有 25 个美国 App Store 类别,按机会指数排序,包括加权平均评分、低评分占比、类别机会评分等)、图表快照样本(chart_snapshots_sample_500,500 行,包含免费/付费/最高收入榜单排名、按类别和国家划分的快照)、评论指标样本(review_metrics_sample_500,500 行,包含每月语言分布、评分直方图、情感均值/份额、投诉主题标签等派生指标,不含原始评论文本)。数据集中还包含一个独特的“类别机会指数”,用于衡量高需求与低评分的组合,识别最未被充分满足的应用市场。该数据集适用于 ASO 基准测试、移动市场分析、发现未满足的应用细分领域、应用牵引信号尽职调查以及情感模型评估。数据来源为 100% 公开、无需登录的 API,不包含任何评论原文或评论者身份。已知限制包括:Apple 数据占绝大多数,图表快照仅为初始运行样本,情感评分仅覆盖英文评论,投诉主题基于关键词规则。
This dataset is a free sample of mobile app intelligence data, containing 6,384 app chart data from Apples official public APIs (iTunes RSS charts, search, and lookup) as well as Google Play public pages. The dataset offers multiple configurations: app metadata sample (apps_sample_500, 500 rows, including fields such as name, developer, category, rating, rating count, price, in-app purchases, release date, update date, size, content rating, etc.), high-opportunity app sample (apps_top_opportunity_sample, 100 rows, including fields such as demand score, pain point score, opportunity index, etc.), category opportunity data (category_opportunity, 25 rows, covering all 25 US App Store categories, sorted by opportunity index, including weighted average rating, low rating percentage, category opportunity score, etc.), chart snapshot sample (chart_snapshots_sample_500, 500 rows, including free/paid/top-grossing chart rankings, snapshots by category and country), and review metrics sample (review_metrics_sample_500, 500 rows, including derived metrics such as monthly language distribution, rating histogram, sentiment mean/share, complaint topic tags, etc., without original review text). The dataset also includes a unique category opportunity index that measures the combination of high demand and low ratings, identifying the most underserved app markets. It is suitable for ASO benchmarking, mobile market analysis, discovering underserved app niches, app traction signal due diligence, and sentiment model evaluation. Data sources are 100% public and do not require login; no original review text or reviewer identity is included. Known limitations include: Apple data dominates, chart snapshots are only initial run samples, sentiment scores cover only English reviews, and complaint topics are based on keyword rules.
数据集概述:App Store Apps, Charts & Review Sentiment — Free Sample
数据集简介
本数据集是移动应用智能数据集的免费样本,源自 6,384 个图表应用,全部数据通过 Apple 官方公共 API(iTunes RSS 图表、Search 与 Lookup)以及 Google Play 公共页面收集,涵盖应用元数据、图表排名快照、评论情感指标,以及独特的 “类别机会指数”(Category Opportunity Index),该指数按 高需求 × 低评分 对每个美国 App Store 类别进行排序,揭示最未被充分满足的应用市场。
数据规模与配置
- 总数据量:1K < n < 10K 行
- 语言:英语
- 任务类别:文本分类
- 许可协议:CC BY-NC 4.0(非商业用途评估)
可用配置(Configs)
| 配置名称 | 行数 | 说明 |
|---|---|---|
apps_sample_500 |
500 | 应用元数据(名称、开发者、类型、评分、评分数量、价格、内购、发布日期/更新日期、大小、内容分级等),按商店 × 国家分层 |
chart_snapshots_sample_500 |
500 | 图表排名快照(免费 / 付费 / 畅销,按类型 × 国家) |
review_metrics_sample_500 |
500 | 每个应用的月度评论衍生指标:语言混合、评分直方图、情感均值/占比、投诉主题标签——仅含衍生指标,不含评论文本 |
category_opportunity |
25 | 全部 25 个美国 App Store 类别按机会分数排名(加权平均评分、低评分占比、机会指数) |
apps_top_opportunity_sample |
100 | 按机会指数排名前 100 的应用(每个应用的 demandScore / painScore / opportunityIndex) |
文件格式与数据字段
所有数据文件均为 Parquet 格式,使用 Hugging Face Datasets 库加载。
主要字段概览
- 应用元数据:store、appId、bundleId、name、developer、primaryGenre、genres、rating、ratingCount、price、currency、free、hasInAppPurchases、installs、version、released、updated、sizeBytes、contentRating、country、snapshotDate
- 图表快照:chart、genreId、genre、country、rank、snapshotDate
- 评论指标:reviewsAnalyzed、primaryLang、ratingCount1-5、ratingShare1-5、sentimentMean、sentimentPosShare、sentimentNeuShare、sentimentNegShare、avgRating30D/90D、reviewCount30D/90D、complaintShare_crash_bug、complaintShare_ads、complaintShare_billing_subscription、complaintShare_login_account、complaintShare_performance、complaintShare_ux_design、complaintShare_support、complaintShare_privacy_permissions、topKeywords
- 机会指数:demandScore、painScore、opportunityIndex、categoryOpportunityScore、weightedAvgRating、lowRatedShare
典型应用场景
- ASO 基准测试与移动市场分析
- 发现未充分满足的应用利基市场(适用于独立开发者、工作室、VC)
- 尽职调查的应用吸引力信号
- 基于评分配对聚合数据的情感模型评估
数据来源与合规性
- 100% 公共、无需登录的来源:Apple iTunes RSS/Search/Lookup API 和 Google Play 公共页面
- 未使用任何反爬虫规避手段
- 不重新分发评论文本,仅提供衍生指标;不收集评论者身份信息
- 每一行都带有商店/国家/快照来源字段,每个应用都可链接回其公开的 App Store 页面
已披露的局限性
- Apple 数据占大多数,并非 Apple/Google 均衡语料库
- 图表快照来自初始运行,并非长期每日时间序列
- 情感评分仅覆盖英语评论;投诉主题使用关键词规则
使用示例
python from datasets import load_dataset
ds = load_dataset("zalizedata/app-store-apps-charts-reviews-sample", "apps_sample_500", split="train") print(ds[0])
引用信息
完整数据集及分片:https://data.zalize.com/datasets/app-store-apps-review-sentiment-dataset
作者:DataForge (Zalize) 产品,完整目录:https://data.zalize.com