
DMindAI/DMind_Benchmark
收藏官方服务:
资源简介:
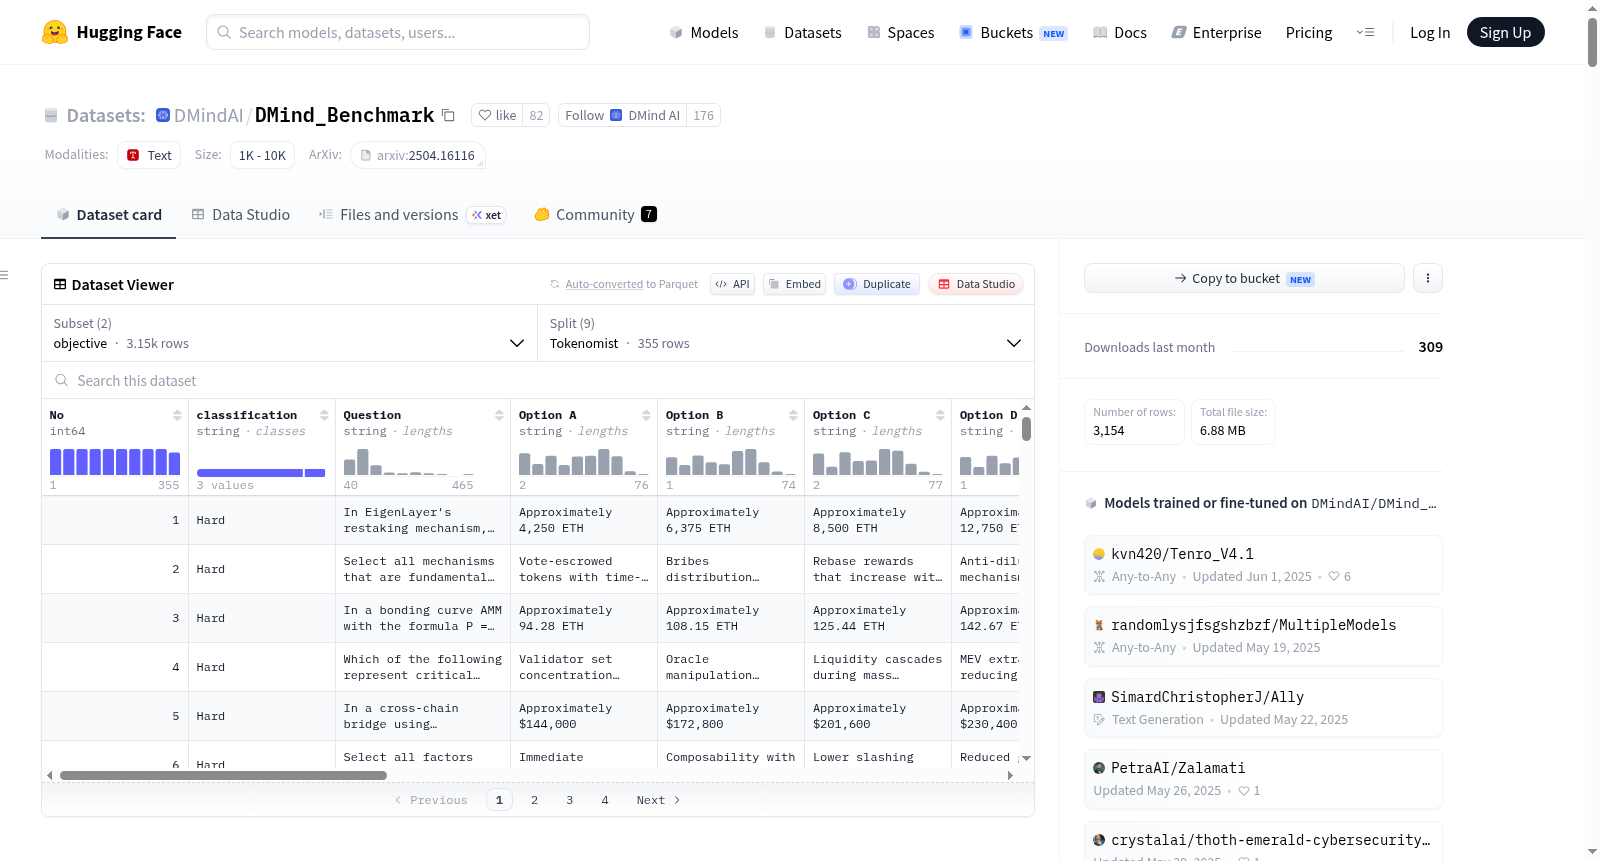
DMind Benchmark是一个全面的评估框架,用于测试大型语言模型在区块链、加密货币和Web3领域的知识,包括主客观问题,覆盖区块链基础、去中心化金融、智能合约、去中心化自治组织、非同质化代币、安全、通证经济学、模因币和区块链基础设施等多个方面。
DMind Benchmark is a comprehensive framework for evaluating large language models on blockchain, cryptocurrency, and Web3 knowledge, including both objective (multiple-choice) and subjective (open-ended) questions, covering various domains such as blockchain fundamentals, decentralized finance, smart contracts, decentralized autonomous organizations, non-fungible tokens, security, tokenomics, meme coins, and blockchain infrastructure.
提供机构:
DMindAI搜集汇总
数据集介绍
构建方式
在区块链与Web3技术迅猛发展的时代背景下,精准评估大语言模型对该领域知识的掌握程度成为了亟待解决的课题。DMind_Benchmark数据集应运而生,其构建过程严谨而系统,覆盖了区块链基础、DeFi、智能合约、DAO、NFT、安全、代币经济学、MEME币以及基础设施等九大核心领域。数据集采用客观与主观双轨设计,其中客观部分以CSV格式存储,包含单选题和多选题;主观部分则以JSONL格式呈现,囊括了简答题、场景分析、策略分析、漏洞分类等11种开放性问题类型,旨在全面且深度地检验模型的认知能力。
使用方法
使用DMind_Benchmark展开评测的过程高效且可复现。用户首先需在根目录的models.yml文件中配置待测模型与可选的第三方评估模型的API接口信息。随后,通过Makefile内置的指令即可驱动整个评测管线,例如使用`make pipeline model=模型名`一键完成数据加载、模型调用、答案采集与分数计算。系统支持同时测试多个模型,最终生成可对比的量化得分。对于特定研究需求,用户亦可分别执行`make test-objective`或`make test-subjective`进行专项测试,并可通过调整api/test_objective.py与api/test_subjective.py中的ThreadPoolExecutor参数来优化并发性能,以适配不同规模的评测任务。
背景与挑战
背景概述
随着区块链、加密货币及Web3技术的迅猛发展,大型语言模型(LLM)在这一跨学科领域中的知识与推理能力评估成为了一个迫切的研究课题。为了填补这一空白,DMind_Benchmark数据集应运而生,该成果已被KDD 2026数据集与基准测试赛道收录。该基准测试由DMindAI团队开发,旨在构建一个全面评估LLM在区块链、加密货币及Web3知识掌握程度的多领域框架。其核心研究问题在于系统性地衡量AI模型对去中心化金融(DeFi)、智能合约、去中心化自治组织(DAO)、非同质化代币(NFT)、代币经济学、安全、Meme币及区块链基础设施等9大基石领域的理解水平,为学术界与工业界评估AI在复杂新兴领域的应用能力提供了关键参考。
当前挑战
DMind_Benchmark所解决的领域问题主要在于,现有LLM评估基准多聚焦于通用知识或传统计算机科学领域,缺乏针对区块链与Web3这一高度专业化、动态演进且兼具技术与金融属性的交叉学科的评测体系。该领域具有知识更新快、概念体系庞杂、主观判断与客观事实并存等特点,对LLM的准确性、推理能力及安全性构成了独特挑战。在构建过程中,研究人员面临了数据构建难度大的挑战,需要精心设计涵盖计算、代码审计、市场推理、风险分析以及漏洞分类等10余种题型,并同时组织客观题(选择题)和主观题(开放问答)两种评测模式。此外,针对主观题设计出自动化的评分与评估流程,并有效配置第三方AI评审模型,亦是确保基准测试效度与信度的关键难题。
常用场景
经典使用场景
在区块链与人工智能交叉研究的前沿领域,DMind_Benchmark被设计为一个综合性评估框架,专门用于衡量大语言模型在区块链、加密货币及Web3知识体系中的理解深度与推理能力。该数据集囊括了区块链基础原理、去中心化金融、智能合约、去中心化自治组织、非同质化代币、安全漏洞、代币经济学、Meme币及区块链基础设施等九大核心领域,支持客观选择题与主观开放题两种评测范式。客观题涵盖计算、代码审计、填空、市场推理、匹配排序及风险分析等多元题型,主观题则聚焦短问答、场景分析、策略制定与漏洞分类等复杂推理任务,为研究者在统一框架下系统评估LLM在Web3领域的能力边界提供了标准化的测试平台。
解决学术问题
该数据集直面当前大语言模型在专业垂直领域评估中的关键学术困境——传统基准测试多聚焦通用知识或常识推理,缺乏对区块链等新兴技术领域深入知识与专业推理能力的系统性度量。DMind_Benchmark通过构建覆盖多维度、多题型、主客观双轨并行的评估体系,有效解决了LLM在Tokenomics理解、DeFi协议机制推理、智能合约安全审计等专项能力量化分析上的空白。其意义在于为区块链与AI交叉学科提供了首个权威的评估标尺,推动研究从模型问答准确率向专业领域深度推理能力延伸,显著加速了面向Web3场景的语言模型优化与风控能力提升,为构建可信、安全的去中心化智能应用奠定了评测基础。
实际应用
在实际应用层面,DMind_Benchmark展现出广泛的产业价值,尤其适用于金融科技公司与Web3项目方在模型选型与部署前的能力筛查。通过该基准,开发者可精准定位不同大模型在DeFi协议风险评估、智能合约漏洞检测、代币经济模型分析等业务场景中的表现差异,从而为自动化审核系统、智能投资顾问、链上分析助手等产品选择最优的底层模型。同时,安全审计团队可借助其主观题库对模型在漏洞分类与策略建议上的表现进行专项测试,显著提升自动化安全分析的可靠性。NFT市场、DAO治理平台以及加密资产管理工具亦可依托该基准持续迭代其智能交互系统的专业性与准确性。
数据集最近研究
最新研究方向
随着区块链、加密货币与Web3生态的蓬勃发展,如何精准评估大语言模型在这一跨学科领域的知识深度与推理能力,已成为学界与产业界共同瞩目的前沿课题。DMind Benchmark正是在这一浪潮中应运而生的综合性评测框架,它不仅覆盖了DeFi、NFT、DAO、安全审计、代币经济学等九个关键细分领域,还创新性地融合了客观选择题与主观开放式问答两种评估模式,兼顾了知识掌握的精度与思维表达的广度。该数据集的出现,恰逢KDD 2026收录其论文之时,标志着区块链智能评测从碎片化走向系统化的重要跃迁。通过引入多线程并行评估与第三方AI辅助评分机制,DMind Benchmark为对比不同模型在复杂金融逻辑与安全分析场景下的表现提供了可复现的标准化工具,其影响力正随着多模型横向比较的可视化成果而持续扩大,成为推动大语言模型在去中心化世界中知识对齐与逻辑验证的关键基石。
以上内容由遇见数据集搜集并总结生成


