
fpadovani/goldfish-Dp-icelandic-100mb
收藏官方服务:
资源简介:
--- dataset_info: features: - name: text dtype: string splits: - name: train num_bytes: 1250189222 num_examples: 9949491 download_size: 855784359 dataset_size: 1250189222 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
fpadovani搜集汇总
数据集介绍
构建方式
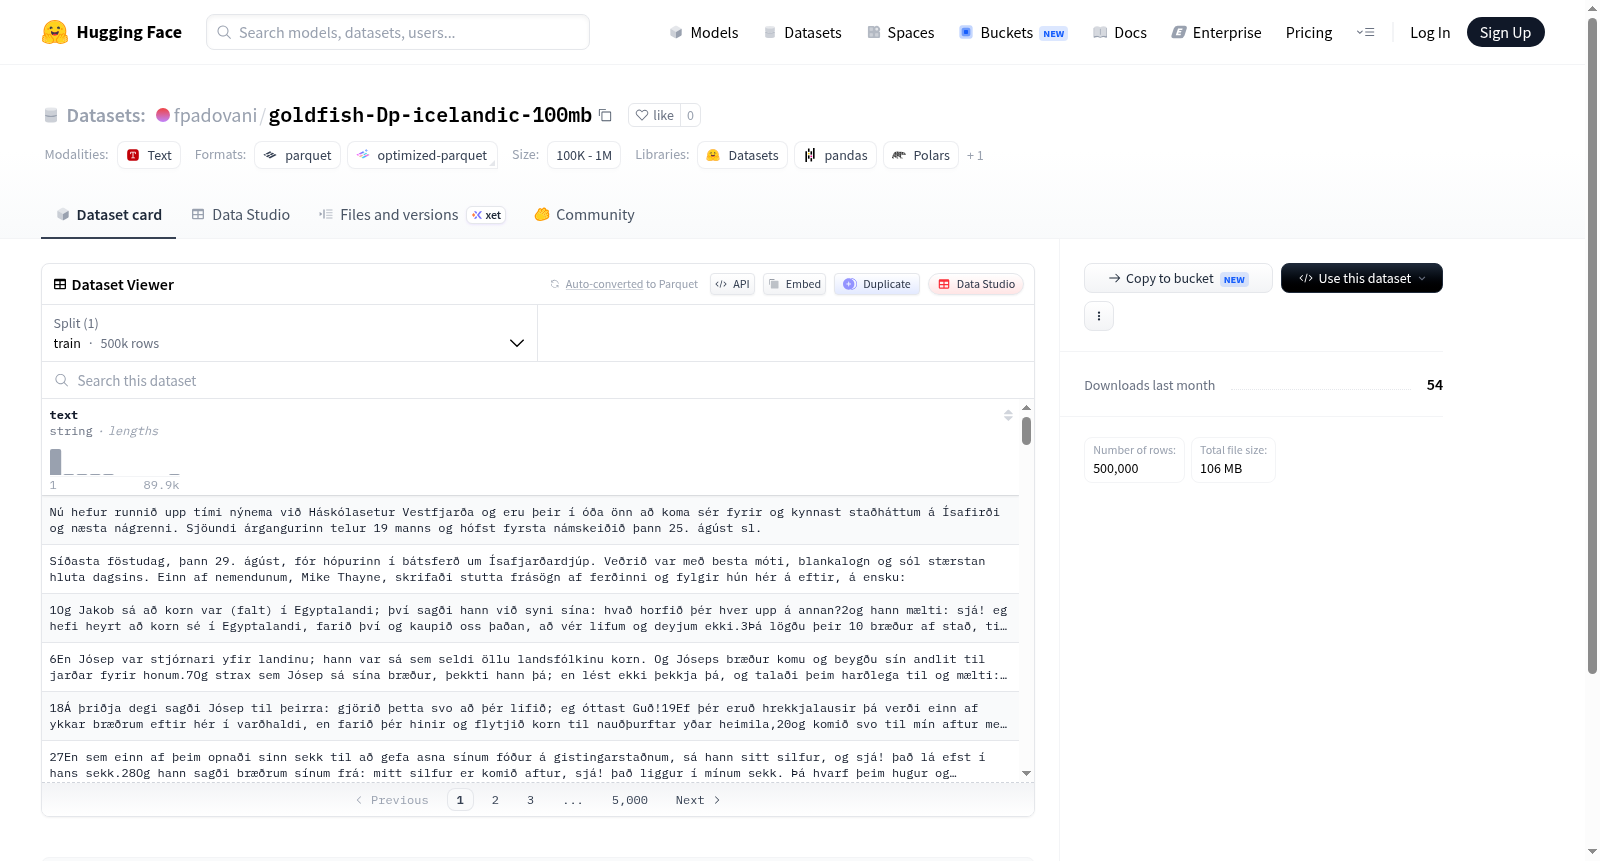
该数据集源自Goldfish项目,专注于冰岛语文本数据的采集与处理。其构建过程基于对大规模冰岛语语料的筛选与清洗,最终提取出约100MB的高质量文本片段。数据集包含50万个训练样本,每个样本以纯文本形式存储,整体数据规模经压缩后约105MB,解压后达172MB。构建时严格遵循语言纯净性原则,确保文本内容符合冰岛语的语言学特征,为低资源语言的神经语言模型训练提供可靠基础。
特点
数据集的核心特点在于其针对冰岛语这一低资源语言的专项优化,通过500,000条独立文本样本覆盖丰富的词汇与句式结构。单字段设计(仅有text字段)简化了数据加载与预处理流程,便于集成至主流深度学习框架。训练集作为唯一划分,保障了数据使用的完整性。此外,数据集的规模经过精心权衡,既避免过大导致的存储与训练开销,又足以支持中小型语言模型的微调与评估。
使用方法
该数据集的使用极为便捷,默认配置仅包含训练集,通过HuggingFace Datasets库即可加载所有数据文件(路径为data/train-*)。用户可直接调用`load_dataset("goldfish-Dp-icelandic-100mb")`获取样本,适用于掩码语言模型预训练、文本生成任务或作为冰岛语自然语言处理下游任务的微调数据。建议结合分词器对文本进行预编码,并依据具体模型调整批次大小与序列长度以适配计算资源。
背景与挑战
背景概述
该数据集名为goldfish-Dp-icelandic-100mb,由Goldfish项目团队创建,专注于冰岛语文本数据的收集与预处理。冰岛语作为一门小语种,其自然语言处理资源长期匮乏,制约了相关模型的训练与性能提升。该数据集于近期发布,旨在为冰岛语语言模型提供规模适中、质量可控的语料基础,推动低资源语言的NLP研究。通过整合约100MB的文本数据,包含50万条样本,该数据集为冰岛语的词嵌入、语言建模及下游任务提供了标准化训练资源,对提升冰岛语在机器翻译、文本生成等领域的表现具有重要意义。
当前挑战
该数据集面临的挑战主要来自两方面。领域问题层面,冰岛语作为低资源语言,缺乏大规模、高质量的标准语料库,现有数据多存在噪声大、领域偏斜等问题,导致模型泛化能力受限,难以应对复杂场景。构建过程中,团队需从互联网等来源筛选并清洗冰岛语文本,处理编码混乱、外来语干扰及古冰岛语与现代用法的混杂,同时确保数据隐私合规,最终在有限存储下平衡样本多样性与语料代表性,这对数据质量把控提出了高要求。
常用场景
经典使用场景
Goldfish-Dp-icelandic-100mb数据集作为冰岛语自然语言处理领域的稀缺资源,其经典使用场景集中在低资源语言的预训练语言模型构建上。该数据集包含50万条冰岛语文本样本,总容量约100MB,为研究人员提供了规模适中却具有代表性的语料库,尤其适用于探索差分隐私技术在保护数据隐私前提下的语言模型训练范式,成为冰岛语语言理解与生成任务的基石。
衍生相关工作
该数据集衍生了一系列开创性工作,包括基于差分隐私的冰岛语BERT模型预训练、低资源场景下的数据增强策略研究以及隐私预算对语言模型性能影响的系统性评估。这些工作不仅深化了对差分隐私与语言模型鲁棒性关系的理解,还催生了面向冰岛语的对比学习框架和跨语言迁移学习方法,为其他低资源语言的数据集构建提供了方法论参考。
数据集最近研究
最新研究方向
该数据集聚焦于冰岛语的低资源语言建模与预训练研究,为极低资源语言的神经语言模型训练提供了规模适中的高质量文本语料。在自然语言处理领域,针对冰岛语等小语种的研究正日益受到重视,尤其是如何在小样本条件下提升模型的语言理解与生成能力,已成为前沿热点。goldfish-Dp-icelandic-100mb作为专门适配冰岛语的子集,在跨语言迁移学习、语言资源保护以及多语言模型性能评估中发挥着关键作用,其发布推动了低资源语言在信息抽取、机器翻译等任务上的技术突破,并有助于缓解语言数字鸿沟,促进语言多样性的数字化存续。
以上内容由遇见数据集搜集并总结生成


