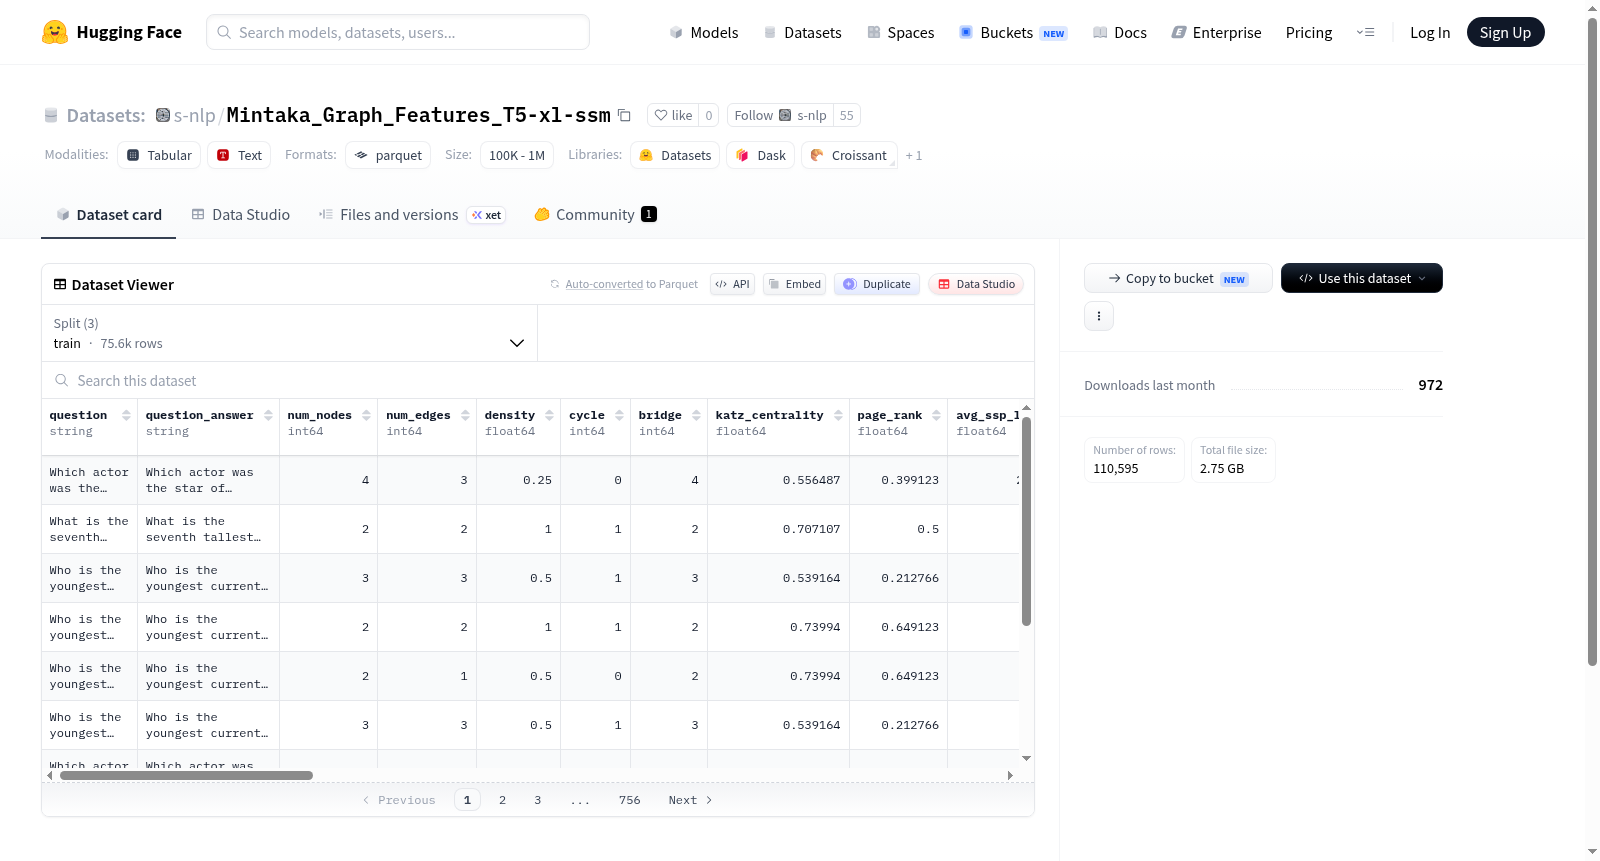
s-nlp/Mintaka_Graph_Features_T5-xl-ssm
收藏资源简介:
--- dataset_info: features: - name: question dtype: string - name: question_answer dtype: string - name: num_nodes dtype: int64 - name: num_edges dtype: int64 - name: density dtype: float64 - name: cycle dtype: int64 - name: bridge dtype: int64 - name: katz_centrality dtype: float64 - name: page_rank dtype: float64 - name: avg_ssp_length dtype: float64 - name: determ_sequence dtype: string - name: gap_sequence dtype: string - name: g2t_sequence dtype: string - name: determ_sequence_embedding dtype: string - name: gap_sequence_embedding dtype: string - name: g2t_sequence_embedding dtype: string - name: question_answer_embedding dtype: string - name: tfidf_vector dtype: string - name: correct dtype: float64 splits: - name: train num_bytes: 8547767219 num_examples: 75582 - name: validation num_bytes: 520992433 num_examples: 13439 - name: test num_bytes: 2442628533 num_examples: 21574 download_size: 1886431078 dataset_size: 11511388185 --- # Dataset Card for "Mintaka_Graph_Features_T5-xl-ssm" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集信息: 特征字段: - 名称:question,数据类型:字符串(string) - 名称:question_answer,数据类型:字符串(string) - 名称:num_nodes,数据类型:64位整型(int64) - 名称:num_edges,数据类型:64位整型(int64) - 名称:density,数据类型:浮点型(float64) - 名称:cycle,数据类型:64位整型(int64) - 名称:bridge,数据类型:64位整型(int64) - 名称:katz_centrality(Katz Centrality),数据类型:浮点型(float64) - 名称:page_rank,数据类型:浮点型(float64) - 名称:avg_ssp_length,数据类型:浮点型(float64) - 名称:determ_sequence,数据类型:字符串(string) - 名称:gap_sequence,数据类型:字符串(string) - 名称:g2t_sequence(Graph-to-Text Sequence),数据类型:字符串(string) - 名称:determ_sequence_embedding,数据类型:字符串(string) - 名称:gap_sequence_embedding,数据类型:字符串(string) - 名称:g2t_sequence_embedding(Graph-to-Text Sequence Embedding),数据类型:字符串(string) - 名称:question_answer_embedding,数据类型:字符串(string) - 名称:tfidf_vector(Term Frequency-Inverse Document Frequency Vector),数据类型:字符串(string) - 名称:correct,数据类型:浮点型(float64) 数据集划分: - 名称:train(训练集),字节大小:8547767219,样本数量:75582 - 名称:validation(验证集),字节大小:520992433,样本数量:13439 - 名称:test(测试集),字节大小:2442628533,样本数量:21574 下载总大小:1886431078 数据集总大小:11511388185 # “Mintaka_Graph_Features_T5-xl-ssm”数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集概述
数据集名称
Mintaka_Graph_Features_T5-xl-ssm
数据集特征
- question (string)
- question_answer (string)
- num_nodes (int64)
- num_edges (int64)
- density (float64)
- cycle (int64)
- bridge (int64)
- katz_centrality (float64)
- page_rank (float64)
- avg_ssp_length (float64)
- determ_sequence (string)
- gap_sequence (string)
- g2t_sequence (string)
- determ_sequence_embedding (string)
- gap_sequence_embedding (string)
- g2t_sequence_embedding (string)
- question_answer_embedding (string)
- tfidf_vector (string)
- correct (float64)
数据集划分
- train
- num_bytes: 8547767219
- num_examples: 75582
- validation
- num_bytes: 520992433
- num_examples: 13439
- test
- num_bytes: 2442628533
- num_examples: 21574
数据集大小
- download_size: 1886431078
- dataset_size: 11511388185