
boffire/kabyle-english-TM
收藏官方服务:
资源简介:
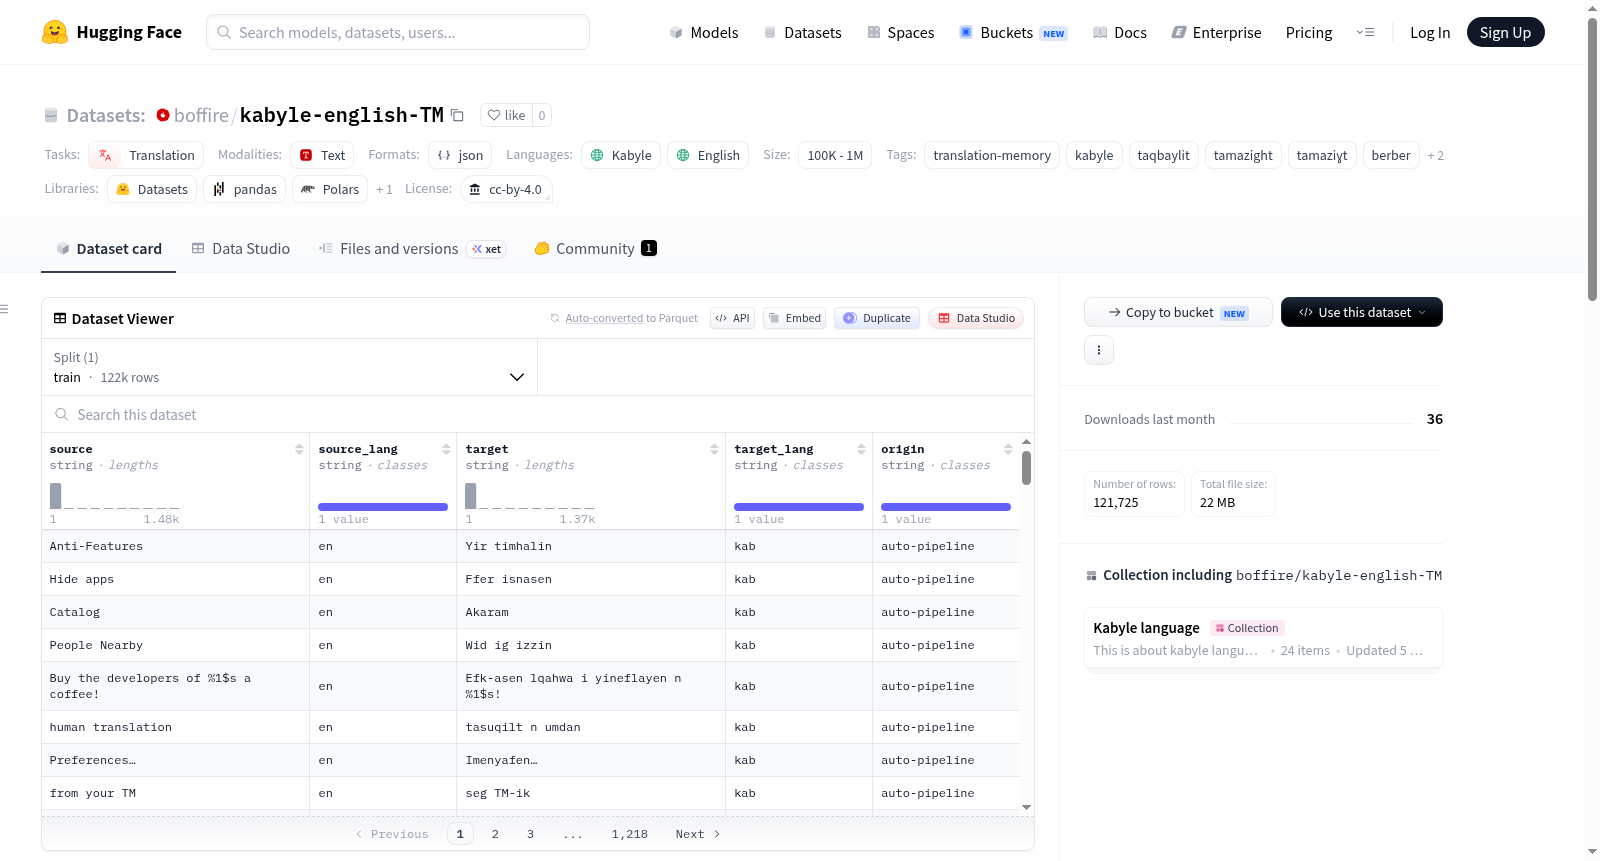
卡拜尔语-英语翻译记忆库是一个双语翻译记忆数据集,包含121,725个句对,涵盖卡拜尔语(kab)和英语(en)。该数据集基于开源软件本地化数据(如GNOME、KDE、LibreOffice等),通过自动化流程构建而成,旨在支持卡拜尔语这一低资源语言的自然语言处理研究和机器翻译系统开发。每个数据记录包括源文本(英语)、目标文本(卡拜尔语)及相关元数据。
A bilingual translation memory containing 121,725 sentence pairs in Kabyle (kab) and English (en), built from open-source software localisation data aggregated through an automated pipeline. It is intended to support NLP research and MT system development for Kabyle, a low-resource Berber language spoken primarily in Algeria.
提供机构:
boffire搜集汇总
数据集介绍
构建方式
该数据集名为Kabyle–English Translation Memory,是一个面向低资源语言卡拜尔语(Kabyle)与英语的双语翻译记忆库,包含121,725个句对。数据集的构建依托自动化流水线(auto-pipeline),从GNOME、KDE、LibreOffice等开源软件本地化项目中系统性地采集翻译实例,确保语料的真实性与领域多样性。每个记录均包含源语言(英语)与目标语言(卡拜尔语)字段,并附带来源标记以追溯数据出处。
特点
该数据集的核心特点在于其针对低资源语言卡拜尔语的专门设计,填补了该语言在机器翻译研究中的语料空白。数据规模达到十万级句对,覆盖软件本地化领域的专业术语与表达,具有较高的实用价值。此外,数据集采用CC-BY-4.0许可协议开放共享,并附带详细的引用格式,便于学术使用与成果追溯。
使用方法
用户可通过HuggingFace的datasets库便捷加载该数据集,调用load_dataset('boffire/kabyle-english-TM')即可获取训练集。数据以JSONL格式存储,每个样本包含source、target及origin字段,分别对应英文源句、卡拜尔语目标句及来源标记。可直接用于机器翻译模型的训练与评估,或作为翻译记忆库辅助人工翻译与语言研究。
背景与挑战
背景概述
在多语言自然语言处理领域,低资源语言的机器翻译系统开发长期面临标注数据匮乏的瓶颈,尤其是像卡拜尔语(Kabyle)这样的柏柏尔语族语言,其语言资源极为稀缺。该数据集建于2026年,由开源社区与研究人员合作构建,核心研究问题在于为卡拜尔语-英语这一低资源语言对提供大规模、高质量的平行语料。通过自动流水线从GNOME、KDE等开源软件本地化项目中采集了121,725个句子对,显著填补了该语言对的翻译记忆库空白。作为卡拜尔语NLP研究的基石资源,其发布推动了柏柏尔语系在机器翻译、跨语言信息检索等任务的探索,对促进语言技术多样性与保护濒危语言具有深远影响。
当前挑战
构建此数据集面临双重挑战:从领域问题看,卡拜尔语作为低资源语言,其形态丰富且语法结构与英语差异显著,尤其在代词缀、时态标记等方面缺乏规范化的标注标准,使得自动对齐句子对的准确性难以保障;从构建过程看,不同开源项目的翻译风格与术语体系不统一,部分语句存在语境缺失或冗余翻译,需要设计强大的去噪与对齐算法来筛选121,725对高质量语料。同时,卡拜尔语的数字资源分散且部分未标注许可证,确保数据来源的合规性与地域代表性也构成一道难题,最终通过限定开源软件本地化语料并统一采自动流水线tag来权衡规模与质量。
常用场景
经典使用场景
Kabyle–English Translation Memory(简称Kabyle-English TM)数据集作为卡拜尔语与英语之间的双语翻译记忆库,涵盖了121,725句平行语料对,其经典使用场景在于为低资源语言神经机器翻译(NMT)模型的训练与评估提供高质量的标注数据。在机器翻译研究领域,该数据集常被用作监督学习的训练语料,尤其适用于构建卡拜尔语到英语以及英语到卡拜尔语的双向翻译系统。研究者可借此数据集开展序列到序列建模、注意力机制优化以及基于Transformer架构的翻译实验,从而提升对低资源语言对的翻译质量。
实际应用
在实际应用层面,Kabyle-English TM数据集可直接服务于卡拜尔语社区的语言技术产品开发,例如集成于开源软件本地化平台的实时翻译工具、卡拜尔语数字助手以及多语言客服系统的构建。该数据集还可应用于教育领域,辅助开发卡拜尔语学习者的双语词典和在线翻译练习平台。此外,针对法国、比利时等地的卡拜尔语侨民社区,此类翻译资源有助于改善跨语言沟通体验,促进文化传承与信息无障碍流通。
衍生相关工作
基于Kabyle-English TM数据集,学术界已延伸出多项经典工作,包括针对低资源语言的机器翻译基准测试集的构建、基于回译与噪声增强的数据扩充方法研究,以及多语言翻译模型的零样本与少样本学习能力评估。该数据集还催生了针对亚非语系语言特征的形态句法分析与词对齐技术的改进工作,同时为Weblate等众包翻译平台的质量控制与自动后编辑研究提供了实证数据支撑,推动了面向濒危语言的NLP方法论创新。
以上内容由遇见数据集搜集并总结生成


