遇见数据集

kewu93/dreambooth_full

收藏
Hugging Face2023-10-16 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: image dtype: image - name: text dtype: string - name: subject_name dtype: string splits: - name: train num_bytes: 111680598.0 num_examples: 158 download_size: 111587177 dataset_size: 111680598.0 configs: - config_name: default data_files: - split: train path: data/train-* --- # Dataset Card for "dreambooth_full" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

--- 数据集信息: 特征字段: - 字段名: image,数据类型: 图像(image) - 字段名: text,数据类型: 字符串(string) - 字段名: subject_name,数据类型: 字符串(string) 数据集划分: - 划分名称: train(训练集),字节数: 111680598.0,样本数量: 158 下载大小: 111587177 数据集总大小: 111680598.0 配置项: - 配置名称: default(默认配置),数据文件: - 对应划分: train(训练集),数据路径: data/train-* --- # 「dreambooth_full」数据集卡片 [【需补充更多信息】](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
kewu93
原始信息汇总

数据集概述

数据集信息

  • 特征:

    • image: 图像数据
    • text: 字符串数据
    • subject_name: 字符串数据
  • 分割:

    • train:
      • 字节数: 111680598.0
      • 样本数: 158
  • 大小:

    • 下载大小: 111587177
    • 数据集大小: 111680598.0

配置

  • 配置名称: default
    • 数据文件:
      • 分割: train
      • 路径: data/train-*
搜集汇总
数据集介绍
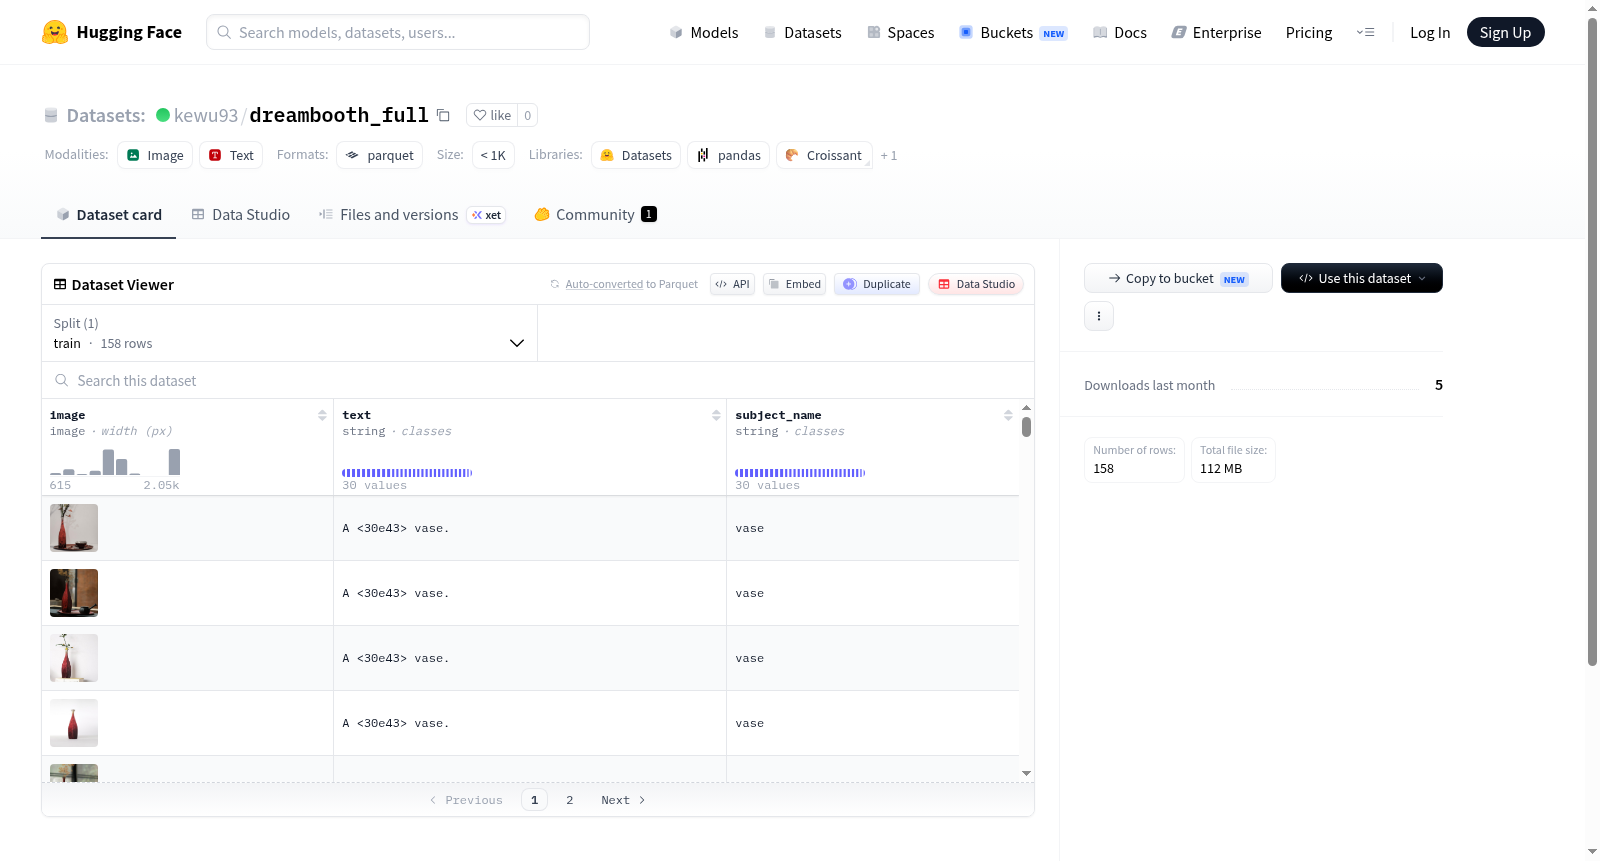
kewu93/dreambooth_full 数据集图片
构建方式
在生成式人工智能领域,DreamBooth作为一种个性化文本到图像生成技术,其核心在于通过少量样本对预训练扩散模型进行微调,从而在特定主体上实现高保真度的图像合成。kewu93/dreambooth_full数据集正是为此类任务量身打造,其构建方式聚焦于简洁性与实用性。该数据集包含158个训练样本,每个样本由三部分构成:图像(image)、文本描述(text)以及主体名称(subject_name)。图像以统一格式存储,文本描述提供了与图像对应的语义引导,而主体名称则明确标识了图像中核心对象,从而形成结构化的三元组数据体系。这种设计使得数据集能够直接服务于DreamBooth模型的训练流程,无需额外预处理,降低了使用门槛。
特点
该数据集的核心特点在于其紧凑而高效的规模与明确的主题聚焦。仅含158个样本的体量,使其成为小样本学习场景下的理想选择,尤其适用于需要快速微调个性化图像生成模型的实验环境。数据集中每个样本均包含图像与对应的文本标注,这种对偶结构确保了模型在训练时能够同时学习视觉特征与语义关联。此外,主体名称字段的引入赋予了数据更强的可解释性,便于研究人员针对特定对象进行针对性优化。整体而言,该数据集以精炼的数据架构,支撑了从概念验证到实际应用的多样化需求,体现了在有限资源下实现高效模型定制的设计理念。
使用方法
使用kewu93/dreambooth_full数据集时,用户可通过HuggingFace的datasets库直接加载,利用其默认配置快速获取训练数据。加载后的数据集以标准格式呈现,其中image字段可直接输入至图像处理管线,text字段作为文本提示用于条件生成,subject_name则可用于过滤或分组特定主体的样本。在DreamBooth微调流程中,用户需将数据集与预训练的扩散模型(如Stable Diffusion)结合,通过定义损失函数和优化器进行迭代训练。建议将数据划分为训练集与验证集,以监控过拟合现象。此外,数据集的小规模特性使其适合在单GPU环境下运行,降低了硬件需求,加速了实验迭代周期。
背景与挑战
背景概述
在生成式人工智能领域,文本到图像生成模型如Stable Diffusion的快速发展,催生了对个性化图像生成技术的迫切需求。DreamBooth作为一种微调方法,能够将特定主体(如宠物或个人物品)的视觉特征嵌入预训练扩散模型中,从而实现基于文本提示的定制化图像生成。kewu93/dreambooth_full数据集正是为支持此类研究而构建,其创建时间虽未明确标注,但源自DreamBooth相关研究的配套资源。该数据集由研究者整理,包含158个训练样本,每个样本由图像、文本描述及主体名称三要素构成,旨在为模型提供少量但高质量的主体图像数据,以解决个性化图像生成中数据稀缺与生成一致性之间的核心矛盾。该数据集的贡献在于为DreamBooth方法的复现与改进提供了标准化基准,推动了少样本个性化生成技术在艺术创作、虚拟现实等领域的应用探索。
当前挑战
该数据集面临的首要挑战在于领域问题的复杂性:个性化图像生成需在极少量样本(仅158例)下实现主体身份的精准保留与背景的合理变换,这对模型避免过拟合与保持生成多样性提出了极高要求。其次,数据构建过程中存在显著困难,包括主体图像采集的多样性不足——样本可能来自单一场景或视角,导致模型难以泛化至不同环境;同时,文本描述的语义粒度难以统一,同一主体在不同描述下的生成效果可能差异显著。此外,数据集的规模限制使得评估指标(如CLIP分数)的可靠性存疑,且缺乏对长尾主体(如罕见物体)的覆盖,这进一步制约了模型在真实场景中的鲁棒性。这些挑战共同指向少样本个性化生成中数据质量与模型能力间的动态平衡问题。
常用场景
经典使用场景
在生成式人工智能的璀璨星河中,DreamBooth技术以其个性化图像生成能力独树一帜,而kewu93/dreambooth_full数据集正是支撑这一技术落地的核心基石。该数据集包含158张精心标注的图像,每张图像均配有文本描述与主体名称,为模型提供了一组高度聚焦的视觉-语义对。其最经典的使用场景在于微调预训练的文本到图像扩散模型,使得模型能够学习特定主体(如宠物、物品或人物)的独特外观特征,并在多样化背景下生成该主体的新颖图像,从而实现了从单一参考到无限创造的跨越。
实际应用
在现实世界的应用层面,kewu93/dreambooth_full数据集赋能了一系列富有创造力的实用工具。例如,用户仅需上传数张宠物照片,即可借助该数据集微调的模型生成宠物在不同艺术风格中的肖像,或将其置于梦幻般的虚拟场景中。此外,在电商领域,它可用于快速生成产品在多种环境下的展示图,降低拍摄成本;在数字艺术创作中,艺术家能以此保留个人风格的同时探索无限变体。这些应用不仅提升了内容生产的效率,更将个性化视觉生成从实验室带入了寻常百姓的日常生活。
衍生相关工作
基于kewu93/dreambooth_full数据集所承载的DreamBooth范式,学术界涌现出大量衍生工作,极大地丰富了生成模型的研究版图。例如,Textual Inversion通过将主体嵌入为可学习的伪词,实现了更轻量的个性化微调;Custom Diffusion则聚焦于多主体组合生成,解决了复杂场景下的身份混淆问题。此外,DreamBooth与ControlNet的结合催生了结构可控的个性化生成,而DreamBooth与LoRA的融合则大幅降低了计算资源需求。这些工作共同构建了一个从单一主体学习到多模态可控生成的完整技术谱系,持续推动着图像合成领域的边界拓展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务