
遇见数据集

QCRI/MemeReason

收藏
Hugging Face2026-07-08 更新2026-07-22 收录
官方服务:

资源简介:

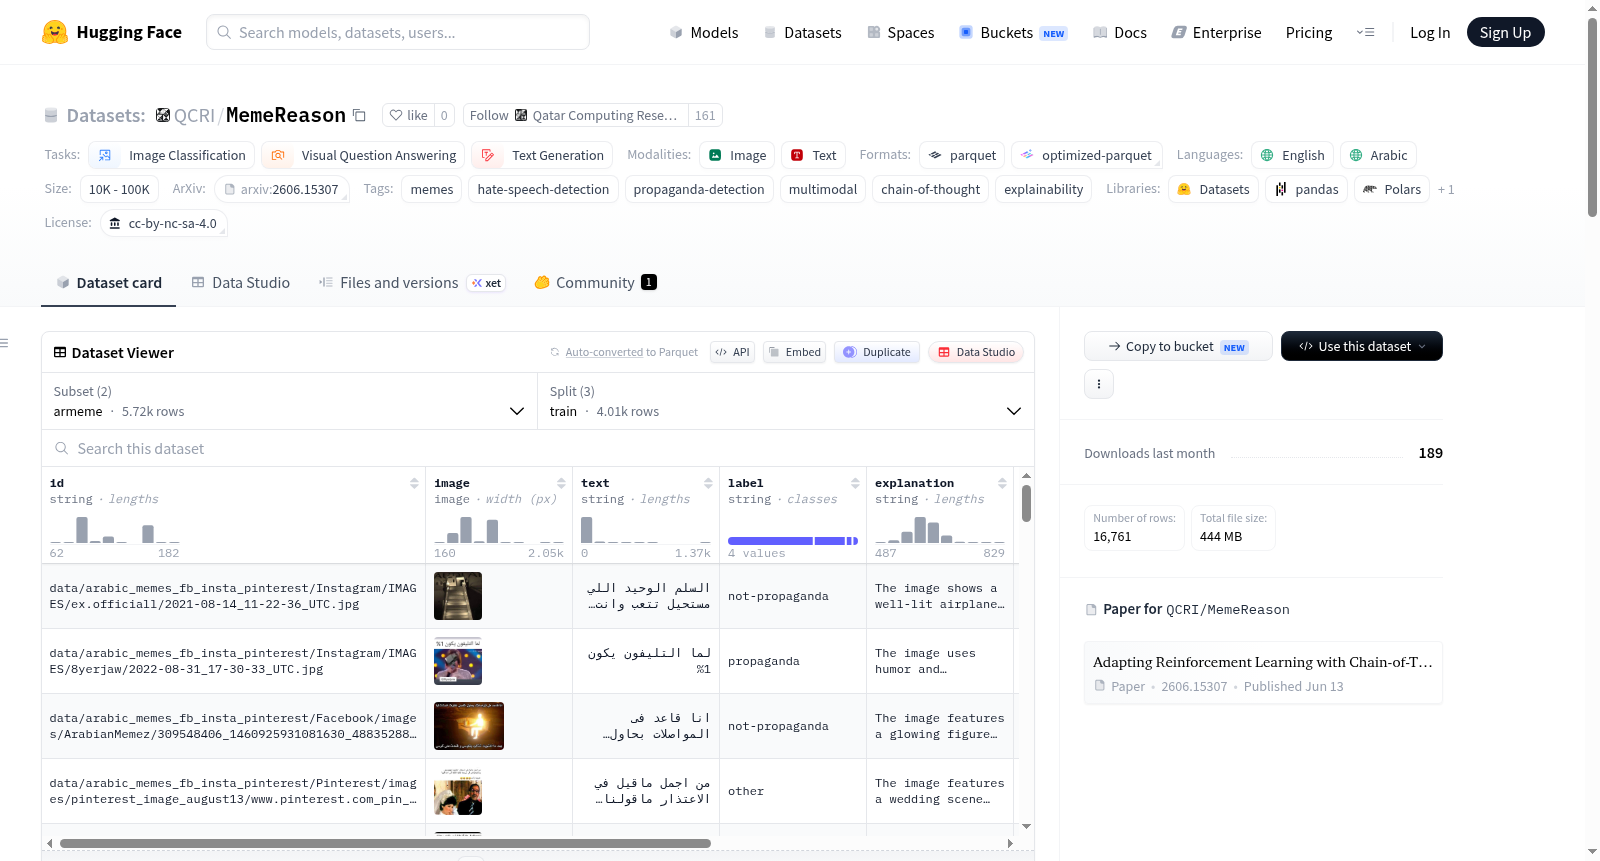
MemeReason是一个扩展的多模态数据集,旨在通过思维链监督进行可解释的仇恨和宣传性表情包检测。它基于两个基准数据集进行增强:hateful_memes(英语,二分类仇恨表情包检测)和armeme(阿拉伯语,4类宣传表情包检测)。数据集扩展了自然语言解释、细粒度标签(如受保护类别和攻击类型)、宣传技术注释(仅限armeme)以及从大型语言模型(如GPT-4.1)提取的逐步思维链推理。这些扩展用于训练可解释的、基于思维的多模态大语言模型,支持图像分类、视觉问答和文本生成等任务。数据集包含训练、开发和测试分割,适用于研究仇恨言论检测、宣传检测和可解释人工智能。注意:数据集内容可能包含令人不安或冒犯性的表情包。

MemeReason is an extended multimodal dataset for explainable detection of hateful and propagandistic memes with chain-of-thought supervision. It augments two benchmarks: hateful_memes (English, binary hateful meme detection) and armeme (Arabic, 4-class propaganda meme detection). The dataset includes natural-language explanations, fine-grained labels (e.g., protected category and attack type), propaganda technique annotations (for armeme), and step-by-step chain-of-thought rationales distilled from large language models like GPT-4.1. These extensions are used to train explainable, thinking-based multimodal LLMs, supporting tasks such as image classification, visual question answering, and text generation. The dataset contains train, dev, and test splits and is suitable for research on hate-speech detection, propaganda detection, and explainable AI. Warning: the dataset contains memes with potentially disturbing or offensive content.
提供机构:
QCRI
搜集汇总
数据集介绍
QCRI/MemeReason 数据集图片
构建方式
MemeReason数据集针对社交媒体中日益泛滥的仇恨言论与宣传性模因检测难题,通过增强两个经典基准测试而构建。其中,hateful_memes子集在原始仇恨模因数据集基础上,扩展了自然语言解释、细粒度保护类别与攻击类型标签,并利用GPT-4.1蒸馏出逐步推理的思维链路径。armeme子集则基于阿拉伯语宣传模因基准,由多大型语言模型管道(GPT-4.1与Llama-4-Scout联合标注、Gemini整合)生成精细的宣传技术标注,人工与模型间一致性达到Gwet's AC1=0.77,并同样提供了思维链蒸馏追踪。
特点
该数据集兼具双语与多模态特性,覆盖英语和阿拉伯语模因,提供图像、文本、标签、解释及思维链路径等丰富字段。其核心特色在于融合了深度推理的可解释性——通过<think>标签封装思维链追踪,为训练具备链式推理能力的多模态大语言模型提供监督信号。此外,armeme子集还包含阿拉伯语解释及JSON格式的细粒度宣传技术标注,hateful_memes子集则提供受保护类别与攻击类型信息,支持多层次仇恨言论分析。
使用方法
研究者可通过HuggingFace Datasets库便捷加载MemeReason的两个子集:使用load_dataset('QCRI/MemeReason', 'hateful_memes')获取英语仇恨模因数据,或load_dataset('QCRI/MemeReason', 'armeme')获取阿拉伯语宣传模因数据。数据集可直接用于图像分类、视觉问答及文本生成等任务。论文复现代码(涵盖监督微调、GRPO强化学习训练、推理与评估)已在GitHub开源,便于用户基于思维链监督进行可解释性模因检测的深入探索。
背景与挑战
背景概述
MemeReason数据集由Mohamed Bayan Kmainasi、Mucahid Kutlu等研究人员于2026年创建,旨在解决多模态社交媒体内容中仇恨言论与宣传性模因的可解释性检测问题。该数据集在Hateful Memes和ArMeme两大基准测试基础上,创新性地引入了细粒度标签、自然语言解释以及链式思维推理,为训练具备解释能力的多模态大语言模型提供了关键监督信号。通过整合GPT-4.1和Llama-4-Scout等多语言模型管道生成的注释,MemeReason不仅推动了多模态理解与可解释人工智能的交叉研究,还为跨语言(英语和阿拉伯语)的模因分析设立了新标准,在学术界产生了重要影响。
当前挑战
MemeReason面临的核心挑战在于多模态模因中仇恨与宣传内容的隐性表达,它们常借助讽刺、文化梗或图像-文本矛盾进行伪装,使得传统分类器难以准确识别。构建过程中,研究人员需应对异构数据源的统一标注难题,包括为Arabic模因设计多LLM协作的注释管道,并确保人类与模型间的一致性与可靠性(Gwet's AC1=0.77)。此外,Hateful Memes原始图像的版权限制导致数据集无法直接分发,必须依赖原始许可证获取图片,这不仅增加了使用门槛,也限制了数据集的广泛复现与扩展。
常用场景
经典使用场景
MemeReason数据集是面向多模态仇恨言论与宣传内容检测研究的重要资源,其经典使用场景在于为视觉-语言模型提供带有链式思维监督的可解释性训练数据。该数据集整合了英文Hateful Memes与阿拉伯语ArMeme两大基准,不仅包含图像与文本模态的原始内容,还配备了细粒度的标签体系(如保护类别、攻击类型及宣传手段)以及由GPT-4.1等大语言模型蒸馏得到的逐步推理轨迹。研究者可利用这些结构化解释和思考路径,训练模型在学习识别恶意内容的同时生成连贯的推理链,从而在检测任务中兼顾准确性与可解释性。
解决学术问题
MemeReason数据集着力解决多模态内容理解中可解释性与细粒度推理匮乏的学术难题。传统仇恨言论检测模型往往仅输出二元分类结果,缺乏对决策依据的透明呈现,难以满足监管与伦理审查的需求。该数据通过引入自然语言解释及链式思维标注,使模型能够模拟人类逐步分析图像与文本线索的过程,明确识别出煽动性图像中的攻击目标、保护类别以及具体宣传技巧。这种监督范式推动了从黑箱分类向可推理、可溯源的检测框架转型,为跨文化、多语言的网络内容治理研究奠定了方法论基础,显著提升了检测系统的可信度与实用性。
衍生相关工作
MemeReason数据集衍生了若干具有影响力的学术工作,其中最具代表性的是其配套论文提出的基于强化学习与链式思维监督的可解释检测方法。该方法通过结合监督微调与GRPO算法,首次将思维链模型应用于多模态仇恨内容识别,并在WWW Companion 2026及后续期刊中发表了系统性的实验分析。此外,该数据集的前身MemeXplain(MemeIntel, EMNLP 2025)奠定了以解释增强多模态理解的范式,而本数据集进一步将推理过程蒸馏为结构化监督信号,催生了关于大语言模型在多模态安全任务中推理能力的系列研究。这些工作共同推动了可解释人工智能与内容审核交叉领域的理论发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

