
遇见数据集

ArtificialAnalysis/Earnings22-Cleaned-AA-chunked

收藏
Hugging Face2026-06-29 更新2026-07-22 收录
官方服务:

资源简介:

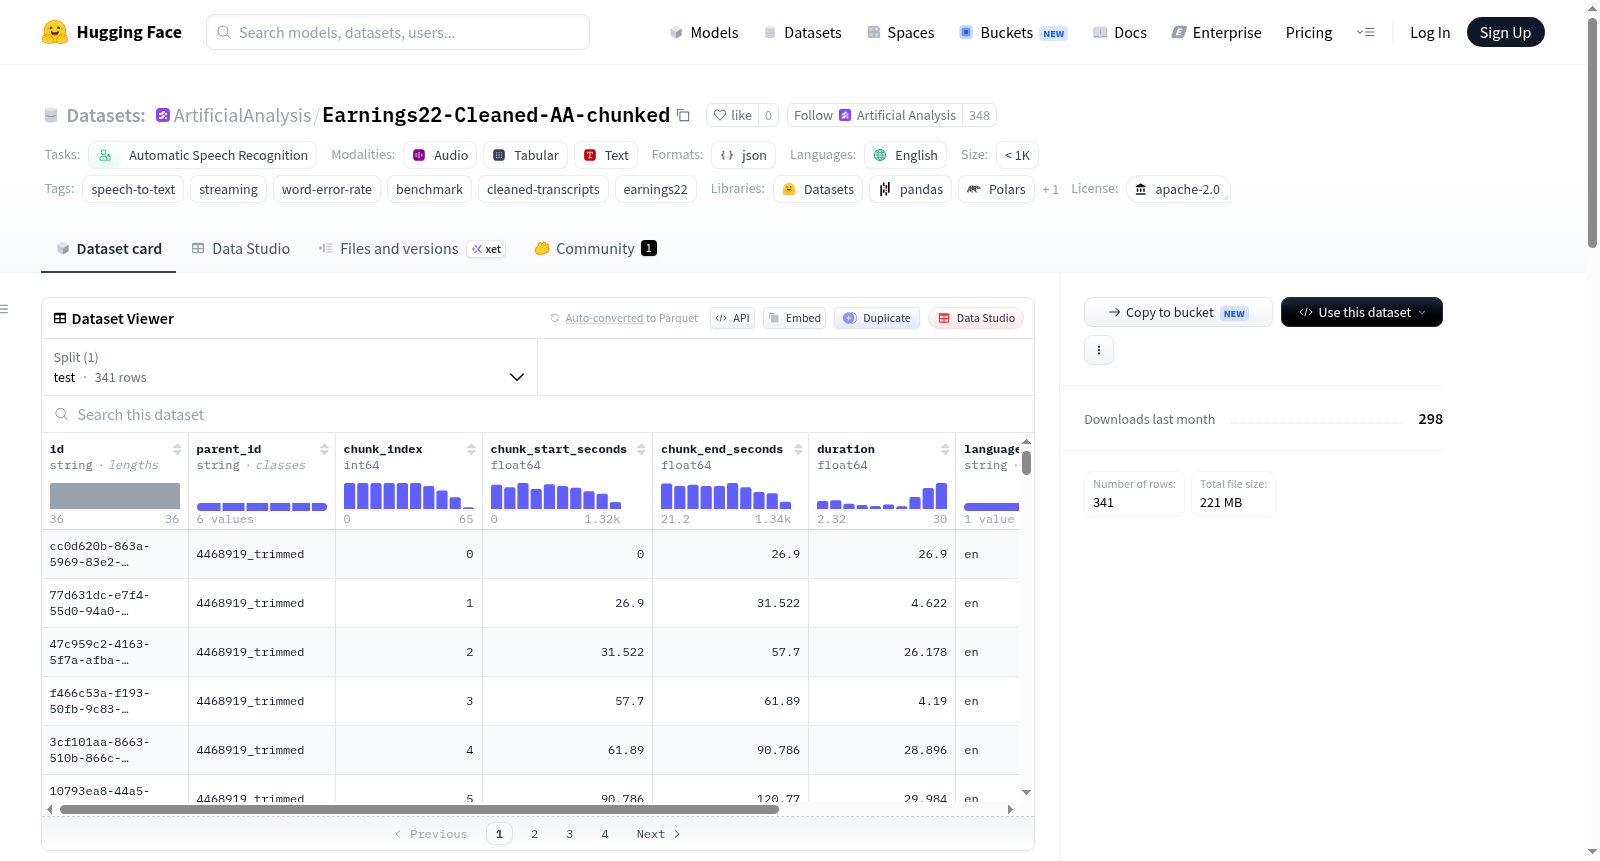
Earnings22-Cleaned-AA-chunked 是一个用于流式语音转文本评估的音频数据集,基于Earnings22-Cleaned-AA数据集的块状版本。原始数据来源于esb/datasets的企业财报电话会议语料库,该子集经过人工清理和校正参考转录文本,以减少地面真实错误对词错误率评估的不公平影响。数据集包含6个父样本,分割成341个音频块,每个块时长在2.32至29.98秒之间,总时长约115分钟,语言为英语。音频块使用Silero VAD进行语音活动检测生成,相邻片段被组合成不超过30秒的块,以支持流式语音转文本系统。数据集提供每个块的元数据(如ID、起始时间、文件名),但不包含每块的参考转录文本;评分时参考文本从清理后的父转录文本中派生并在评估流程中对齐。

Earnings22-Cleaned-AA-chunked is a chunked version of Earnings22-Cleaned-AA, the cleaned Earnings-22 subset used by Artificial Analysis for streaming Speech to Text evaluation. The original data comes from esb/datasets, a corpus of corporate earnings calls, with manual review and correction of reference transcripts to reduce ground-truth errors affecting word error rate. It contains 6 parent samples split into 341 audio chunks, each ranging from 2.32 to 29.98 seconds in duration, totaling approximately 115 minutes, in English. Chunks are generated using Silero VAD to identify speech segments, combined into segments up to 30 seconds to support streaming STT systems. The dataset includes metadata per chunk (e.g., ID, timestamps, filename) but not per-chunk reference transcripts; reference text is derived from cleaned parent transcripts and aligned during evaluation.
提供机构:
ArtificialAnalysis
搜集汇总
数据集介绍
ArtificialAnalysis/Earnings22-Cleaned-AA-chunked 数据集图片
构建方式
Earnings22-Cleaned-AA-chunked数据集是基于Earnings22-Cleaned-AA的衍生版本,专为流式语音到文本评测所设计。原始语料源于企业财报电话会议的录音,经Artificial Analysis团队人工审校修正参考转录文本以降低错词率。在此基础上,为适配仅支持短音频片段的流式系统,同时保持与非流式评测的可比性,研究者采用Silero语音活动检测技术识别每段父级音频的语音起止时间,将相邻的有声片段拼接为长度不超过30秒的语音块。最终共生成341个音频块,总时长约115分钟。
特点
该数据集的核心特色在于其精细化的语料清洗与结构设计。每个数据条目包含父级样本ID、音频块索引、起止时间、持续时长及音频文件名等完整元字段,便于追踪与对齐。尤其值得强调的是,数据集并未提供逐块参考文本,而是依赖父级人工修正转录本通过评估管道对齐计算,既保障了评分基准的准确性,又避免了引入额外注解误差。此外,数据集规模仅为数百个样本,专注服务于流式语音识别基准测试,具有极高的评测效率与针对性。
使用方法
使用该数据集时,可通过HuggingFace Datasets库简洁加载,调用load_dataset函数并指定分割为'test'即可获取全部341个语音块。音频文件存放于仓库的audio目录下,用户可配置hf_hub_download方法按文件名下载对应音频。由于数据集不内置逐块转录本,评估时需结合父级清洗后的参考文本,并利用Artificial Analysis评估管线的对齐机制计算字错误率,这一流程与流式语音到文本排行榜的方法论紧密契合。
背景与挑战
背景概述
在自动语音识别(ASR)领域,针对流式语音转文本系统的评估长期受限于两大瓶颈:其一,现有基准数据集多面向非流式场景,难以反映低延迟、实时解码的真实性能;其二,诸如Earnings-22等经典数据集中的参考转录文本常存在人工标注错误,导致词错误率(WER)指标失真。为攻克上述难题,Artificial Analysis团队于近期推出了Earnings22-Cleaned-AA-chunked数据集。该数据集源于企业财报电话会议语料库Earnings-22的清洗子集,由Artificial Analysis人工复审并修正了原始参考转录中的误差,进而采用Silero VAD算法将音频切分为不超过30秒的短片段,最终形成包含341个测试样本、总时长约115分钟的流式评估基准。作为流式语音转文字排行榜的核心评测集,该数据集的发布显著提升了ASR系统在流式场景下的评估公平性与可比性。
当前挑战
该数据集主要面临两大层面的挑战。在领域问题层面,流式语音转文字系统需在极低延迟约束下处理不完整的音频流,传统离线评估方式无法准确衡量其真实性能,因此亟需一种专为流式场景设计的标准化测试集,这正是Earnings22-Cleaned-AA-chunked所致力于解决的痛点——通过短片段切分与清洗转录本,为实时ASR系统提供可靠的WER评测基准。在构建过程中,挑战同样严峻:原始Earnings-22数据集存在大量转录错误(如拼写混杂、标点不一致),若直接用于评估将严重干扰WER结果的准确性,因此不得不投入大量人力进行逐条复核与修正;此外,将长音频合理分割为2.32至29.98秒不等的片段时,必须平衡切分粒度(确保适配流式API的输入限制)与语义完整性(避免断句错误导致评测失真),最终依赖Silero VAD结合人工对齐策略才得以解决这一难题。
常用场景
经典使用场景
Earnings22-Cleaned-AA-chunked数据集在自动语音识别(ASR)领域扮演着关键角色,尤其适用于流式语音转文本系统的评测。该数据集源自企业财报电话会议录音,经过精细的语音活动检测(VAD)切割,将原始长音频切分为长度不超过30秒的短片段,以适应流式模型对短音频输入的需求。研究人员可借助该数据集,在统一的测试集上对比不同流式ASR系统的词错误率(WER),从而客观衡量模型在处理真实、复杂商业场景语音时的转录精度与实时响应能力。
实际应用
在实际应用中,该数据集主要服务于金融与商业领域的实时语音转写服务评测。企业财报电话会议是投资者、分析师与高管之间的高频沟通场景,其内容涉及专业术语、数字和敏感信息,对转录准确率要求极高。流式ASR系统利用此数据集可验证其在类似场景下的实时转录性能,从而推动产品如实时会议纪要生成、智能投顾语音助手、合规监控等技术的落地与迭代。数据集提供的标准化评测流程,也帮助企业用户筛选性能最优的商用ASR方案。
衍生相关工作
该数据集衍生了一系列重要工作,最直接的是Artificial Analysis推出的流式语音转文本排行榜(Streaming Speech to Text Leaderboard),该榜单基于此数据集定期更新,实时反映业界主流ASR模型的性能对比。此外,原始Earnings22-Cleaned-AA数据集及本切分版本被广泛用于研究语音分割策略(如VAD参数调优)对WER的影响,以及流式与非流式模型在长语音转录上的一致性分析。这些工作深化了学界对语音片段化处理与评测方法论的理解,并推动了端到端流式ASR架构的改进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

