
saraiki-assistant-sft
收藏官方服务:
资源简介:
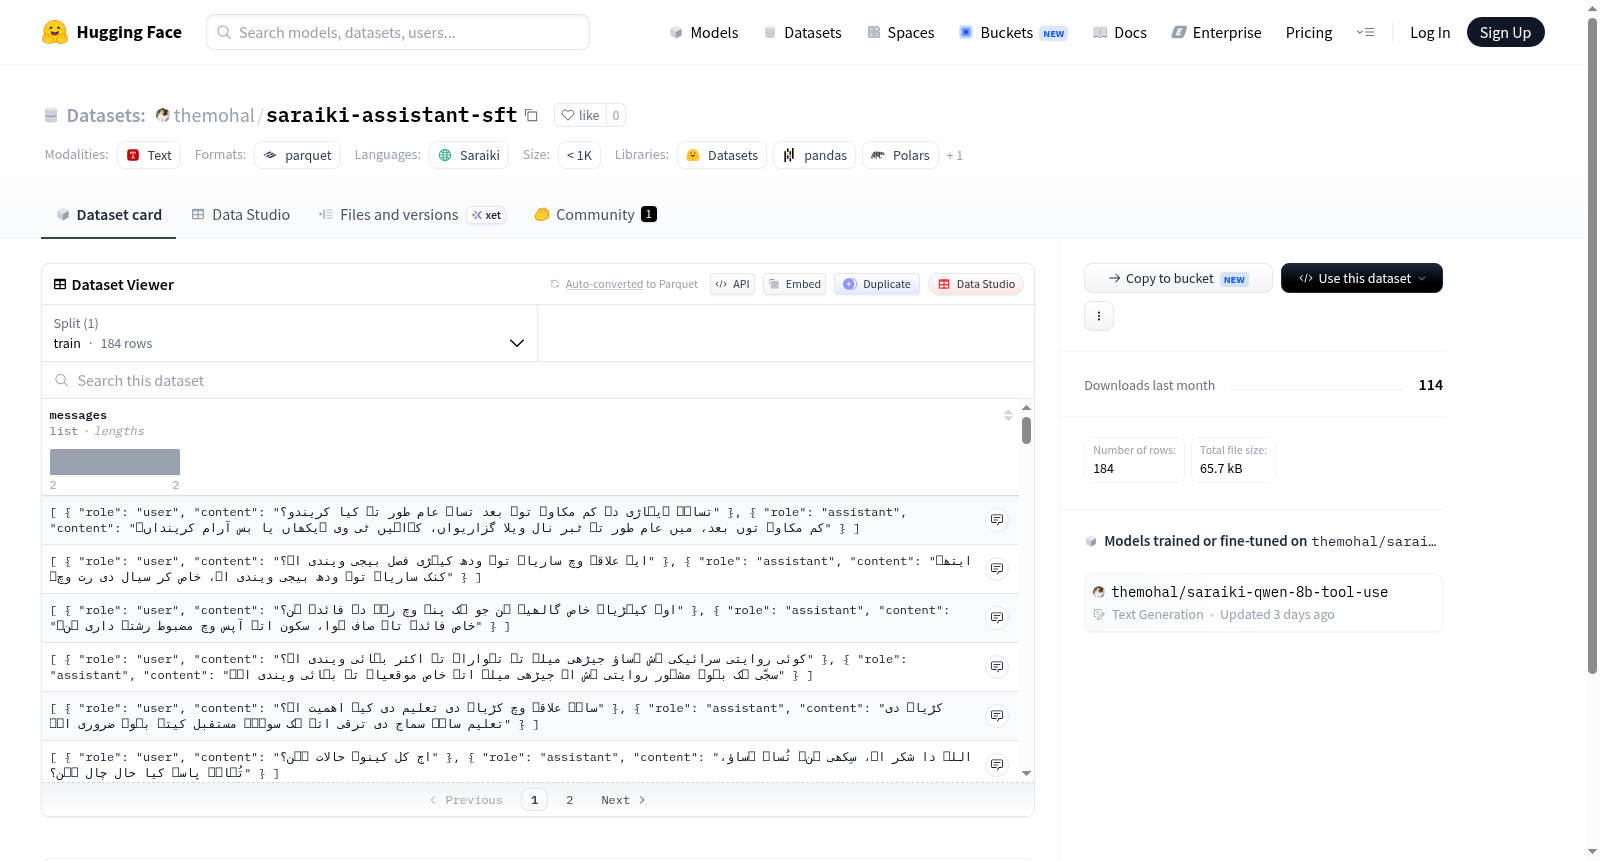
该数据集是一个对话数据集,包含180个训练样本,每个样本由一系列消息组成,每条消息包含角色(role)和内容(content)两个字段。数据集的语言标记为skr,可能指向一种特定语言或方言。适用于对话生成、角色扮演或语言模型微调等任务。
This dataset is a dialogue dataset containing 180 training samples. Each sample consists of a series of messages, and each message contains two fields: role and content. The datasets language is marked as skr, which may refer to a specific language or dialect. It is suitable for tasks such as dialogue generation, role-playing, or language model fine-tuning.
创建时间:
2026-08-03
原始信息汇总
数据集详情总结
基本信息
- 数据集名称:saraiki-assistant-sft
- 数据集地址:https://huggingface.co/datasets/themohal/saraiki-assistant-sft
- 数据集语言:skr(萨莱基语,Saraiki)
数据内容与格式
该数据集采用对话式结构,每条数据包含一个 messages 字段,其中每条消息包含以下两个属性:
- role(角色):字符串类型,表示消息的角色(如用户或助手)
- content(内容):字符串类型,表示消息的具体文本内容
数据划分与规模
- 数据分割:仅包含一个训练集(train)
- 训练集样本数量:184条
- 训练集数据大小:61,497字节(约60.1 KB)
- 数据集总下载大小:62,813字节(约61.4 KB)
配置信息
- 默认配置名称:default
- 数据文件路径:
data/train-*(以通配符形式存储的多个文件)
数据集用途
该数据集为指令微调(SFT,Supervised Fine-Tuning)格式的萨莱基语助手对话数据,适用于训练或微调对话式AI模型。
搜集汇总
数据集介绍
构建方式
该数据集名为saraiki-assistant-sft,专为萨莱基语(Saraiki)设计的指令微调数据。其构建方式遵循了对话式AI训练的常见范式,数据以messages字段为核心,每条样本包含role与content两个子字段,分别指示对话角色(如用户或助手)和具体内容。数据集以单条对话轮次的形式组织,共集成184条训练样本,总大小约为61KB,并以train分割形式存储于data/train-*文件中。
使用方法
使用时,可通过HuggingFace数据集库直接加载,默认配置为default,并指向train分割。用户可基于messages字段,利用标准对话格式(如角色和内容)进行模型微调。由于样本量较小,建议结合其他语言数据集进行联合训练,或采用数据增强策略以提高模型泛化能力。该数据集同样适用于评估模型的萨莱基语理解与生成能力。
背景与挑战
背景概述
随着自然语言处理技术的飞速发展,多语言模型的研究逐渐成为焦点,然而低资源语言(如Saraiki)的数字化资源仍十分匮乏。Saraiki语作为巴基斯坦的一种主要地区性语言,拥有庞大的使用群体,但其在NLP领域的研究尚处于起步阶段。为了推动Saraiki语的自然语言处理应用,研究团队于近期创建了‘saraiki-assistant-sft’数据集,该数据集由巴基斯坦的学术机构主导开发,旨在为Saraiki语提供高质量的指令微调(SFT)样本。通过构建包含184条训练样本的指令数据集,该资源为训练Saraiki语对话式AI助手奠定了初步基础,填补了该语言在开源NLP数据集上的空白,对促进低资源语言的智能交互研究具有重要的里程碑意义。
当前挑战
当前,‘saraiki-assistant-sft’数据集面临多重挑战。首要挑战在于数据规模极为有限,仅184条训练实例,难以支撑大型语言模型的高效训练与泛化,限制了模型对Saraiki语复杂语法和丰富方言变体的学习能力。其次,低资源语言的数据获取与标注难度大,人工标注成本高昂,且缺乏现成的语言工具和标注规范,导致数据集构建过程耗时费力。此外,Saraiki语中存在多种方言和文字变体,数据统一性和代表性不足,可能影响模型在实际应用中的表现。最后,数据集的领域覆盖范围较窄,主要集中于日常对话,缺乏专业领域知识,限制了其在更广泛场景下的适用性。这些挑战亟需通过扩充数据规模、引入自动化标注技术和多方言整合策略来逐步解决。
常用场景
经典使用场景
该数据集作为面向萨莱基语的指令微调资源,其核心场景在于构建和优化萨莱基语的大型语言模型。研究者可利用其中包含的184条人工撰写的多轮对话样本,对预训练模型进行监督式微调,赋予模型遵循指令、进行上下文连贯对话的能力,从而填补低资源语言在对话式人工智能领域的空白。
解决学术问题
该数据集直面低资源语言在自然语言处理中的长期缺位问题。它提供了首个公开可用的萨莱基语指令数据集,解决了该语言缺乏高质量监督信号、模型难以习得语义和语用规律的困境,为低资源语言的跨语言迁移学习、少样本学习以及对话系统评估提供了基准,促进了语言技术的公平性与多样性。
实际应用
在实际应用中,该数据集可支撑萨莱基语智能客服、语音助手和教育辅导系统的开发,使该语言使用者能够以自然语言与机器交互。涵盖日常生活、文化习俗等领域的对话样本,有助于构建符合当地语境的服务,提升信息可及性,并推动语言资源的数字化保护。
数据集最近研究
最新研究方向
该数据集聚焦于萨莱基语的指令微调,为低资源语言的自然语言处理领域注入新动力。当前研究前沿正积极拓展多语言及方言的对话式AI能力,此数据集通过构建高质量的人工标注对话样本,支撑了基于Transformer的模型在萨莱基语上的语义理解与生成优化,其仅有184条训练样本的特性,也催生了小样本学习与数据增强技术的探索,对促进语言技术普惠、保护语言多样性具有深远意义。
以上内容由遇见数据集搜集并总结生成


