
遇见数据集

marin-community/mcp-atlas-easy

收藏
Hugging Face2026-07-14 更新2026-07-22 收录
官方服务:

资源简介:

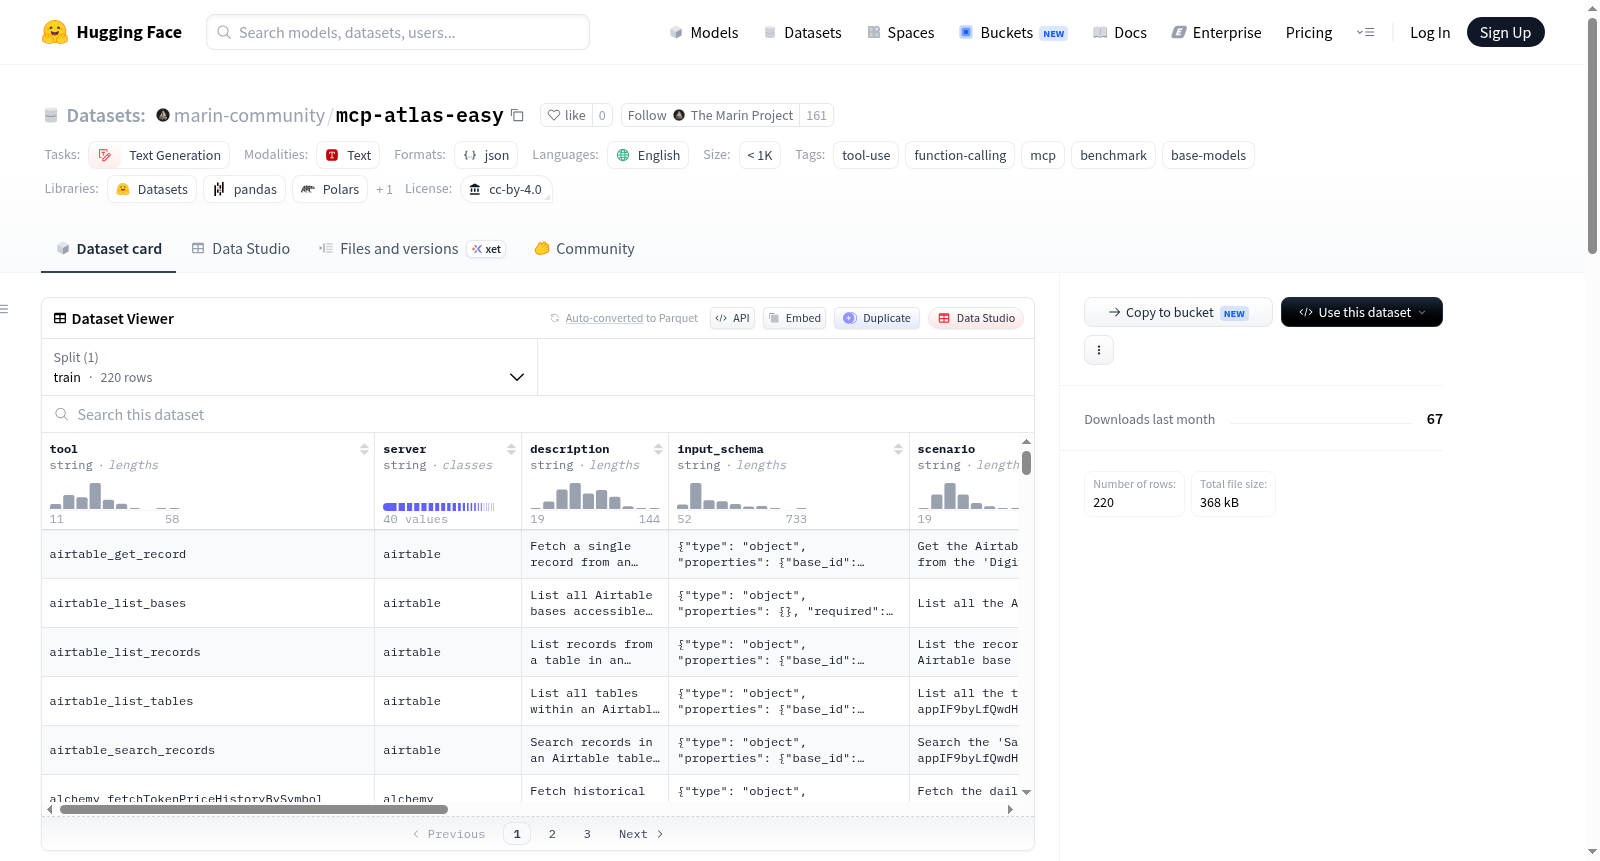
MCP-Atlas-Easy是一个用于预训练(基础)语言模型的简单、单工具调用基准测试数据集,源自ScaleAI/MCP-Atlas数据集。它简化了多步骤工具编排任务,专注于最基本的技能:一个工具规范、一个明确无误的用户请求、一个正确的工具调用,然后停止。这使得它适用于没有聊天模板的基础模型的完成式评估。数据集包含220个唯一工具,每个工具对应一行数据,包括工具名称、服务器前缀、工具描述、输入模式(JSON模式)、用户请求场景、目标调用(JSON字符串)、就绪使用的完成提示和目标完成(JSON工具调用后跟EOS标记)。数据集的构建过程包括从MCP-Atlas提取工具信息、使用Claude Sonnet生成规范和场景,并进行程序化验证。注意事项包括部分工具的模式是推断的,场景和目标调用是合成的,数据集遵循CC-BY-4.0许可。

MCP-Atlas-Easy is an easy, single-tool-call benchmark for pretrained (base) language models, derived from ScaleAI/MCP-Atlas. It strips down multi-step tool orchestration to the simplest possible form of the same skill: one tool spec, one trivially unambiguous request, one correct tool call, then stop. This makes it usable as a completion-style eval for base models with no chat template. The dataset contains 220 unique tools, each represented as a row with fields including tool name, server prefix, tool description, input schema (JSON Schema), user request scenario, target call (JSON string), ready-to-use completion prompt, and target completion (JSON tool call followed by EOS token). Construction involved extracting tool information from MCP-Atlas, generating grounded specs and scenarios using Claude Sonnet, and programmatically validating each row. Caveats include that some tools have inferred schemas, scenarios and target calls are synthetic, and the dataset is released under CC-BY-4.0.
提供机构:
marin-community
搜集汇总
数据集介绍
marin-community/mcp-atlas-easy 数据集图片
构建方式
MCP-Atlas-Easy数据集源自ScaleAI开发的MCP-Atlas基准测试,旨在评估预训练语言模型的基础工具调用能力。其构建过程首先从MCP-Atlas中提取全部220个独立工具名称,并收集每个工具的声明参数信息(41个工具具备显式参数声明)以及从运行轨迹中挖掘的真实调用参数(覆盖106个工具)。随后,借助Claude Sonnet为每个工具生成包含描述与JSON Schema的规范化规约,并配以一个完全确定的简单场景及其正确调用结果。最后,通过程序化校验确保每个目标调用的参数满足其自身Schema约束,且所有220个工具无一遗漏地得到覆盖。
特点
该数据集的核心特色在于其极致的简约性与纯净性。每条数据仅包含单一工具规约、一个无歧义的请求、一次正确的工具调用及终止标识,从而将复杂的多步工具编排任务降维至最简单的形式。这使得它能够直接作为预训练基座模型的补全式评估基准,无需依赖聊天模板或指令微调。此外,尽管部分工具(103个)的Schema基于工具名称和服务器已知行为推断得出,数据集内部始终保持高度一致性——提示中展示的规约与目标调用严格匹配,从而确保评估聚焦于语言模型的条件式格式转换与归约能力。
使用方法
使用时,可直接采用数据集中预构建的`prompt`字段作为模型输入,该字段包含了工具规约、用户请求及引导前缀“Tool call:”。模型需输出对应格式的JSON工具调用,随后生成结束符。推荐通过解析模型输出中的JSON对象并评估其与`target_call`字段的精确匹配或语义等价性来评分,同时检查模型是否在调用后正确终止(如生成EOS token而非继续生成无关内容)。在构建评估目标时,需将提示中的`<|endoftext|>`替换为对应分词器的EOS标记。
背景与挑战
背景概述
MCP-Atlas-Easy数据集诞生于2025年,由ScaleAI团队基于其先前发布的MCP-Atlas数据集精简而成。该数据集专注于评估预训练基础语言模型在工具调用这一关键能力上的表现,核心研究问题在于如何以最简单的形式衡量模型对单一工具规范的理解与执行能力。在人工智能领域,工具使用能力被视为大语言模型从语言理解迈向实用智能体的关键桥梁,而MCP-Atlas-Easy通过将复杂的多步骤工具编排简化为单次工具调用的基准测试,为研究者提供了一种纯净的评估基线。该数据集覆盖220个真实MCP服务器工具,其简洁的完成式格式设计使得未经过指令微调的基础模型也能参与评估,显著扩展了工具调用研究的适用范围,对推动语言模型工具使用能力的标准化评估具有重要影响力。
当前挑战
MCP-Atlas-Easy所解决的领域问题在于,现有工具调用评估多针对指令微调模型设计,而基础模型因缺乏对话模板难以直接参与评测,该数据集通过完成式提示格式填补了这一空白。构建过程中面临的核心挑战包括:首先,220个工具中有103个工具的输入模式与参数结构需从工具名称及已知服务行为推断而来,缺乏真实调用轨迹验证,这导致模式推断存在不确定性;其次,所有测试场景与目标调用均由Claude Sonnet模型合成生成而非人工撰写,可能引入模型偏差;最后,需确保每个工具被覆盖且目标调用严格符合自身规范,程序化验证虽解决了内部一致性问题,但合成数据与真实服务器接口之间的语义鸿沟仍是评估效度的潜在威胁。
常用场景
经典使用场景
在大型语言模型的基础能力评估领域,MCP-Atlas-Easy 数据集被广泛用于测试预训练(base)模型在极简工具调用场景下的表现。该数据集将复杂的多步工具编排任务简化为单一工具规范、明确无误的请求以及一次正确的工具调用,从而为不具备聊天模板的基础模型提供了一种补全式评估方案。研究者通常利用该数据集衡量模型是否能够根据给定的工具描述和用户需求,生成符合JSON Schema的精确工具调用,并适时终止生成过程,以评估其对结构化输出和任务边界的理解能力。
衍生相关工作
MCP-Atlas-Easy 的发布催生了一系列关于基础模型工具使用能力的衍生研究。其中,有工作基于该数据集构建了更细粒度的评估框架,通过引入参数类型多样性、必选参数缺失检测等维度,深入剖析模型在工具调用中的错误模式。还有研究将本数据集与ScaleAI/MCP-Atlas结合,形成从基础调用到多步编排的全链条评估体系,系统性地探究指令微调对工具使用能力的提升路径。此外,部分学者利用该数据集作为基准,对比不同分词器、解码策略以及模型架构对结构化输出质量的影响,为设计更高效的模型推理方案提供了实证基础。
数据集最近研究
最新研究方向
大语言模型工具调用能力的基准测试正从复杂的多步编排场景向基础模型的本体能力评估回归。MCP-Atlas-Easy作为ScaleAI/MCP-Atlas的精简衍生版本,聚焦于单工具调用的最简形式,旨在剥离指令微调与对话模板的影响,直接评估预训练基座模型对工具规范的理解与结构化输出能力。这一方向呼应了当前业界对模型原生能力边界探索的热潮,尤其是在函数调用与工具使用成为AI Agent核心技能的背景下,通过220个真实MCP服务器的工具集构建的标准化测试集,为研究语言模型在低混淆度场景下的泛化性与格式合规性提供了可复现的评测基准。其明确的JSON Schema验证机制与EOS终止条件设计,推动了对模型工具调用行为中停止生成与退化延续等关键问题的量化分析,对理解基础模型的知识蒸馏与指令跟随机理具有重要参考价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

