
遇见数据集

verba — Ukrainian Proverbs Corpus

收藏
github2026-06-24 更新2026-06-26 收录
官方服务:

资源简介:

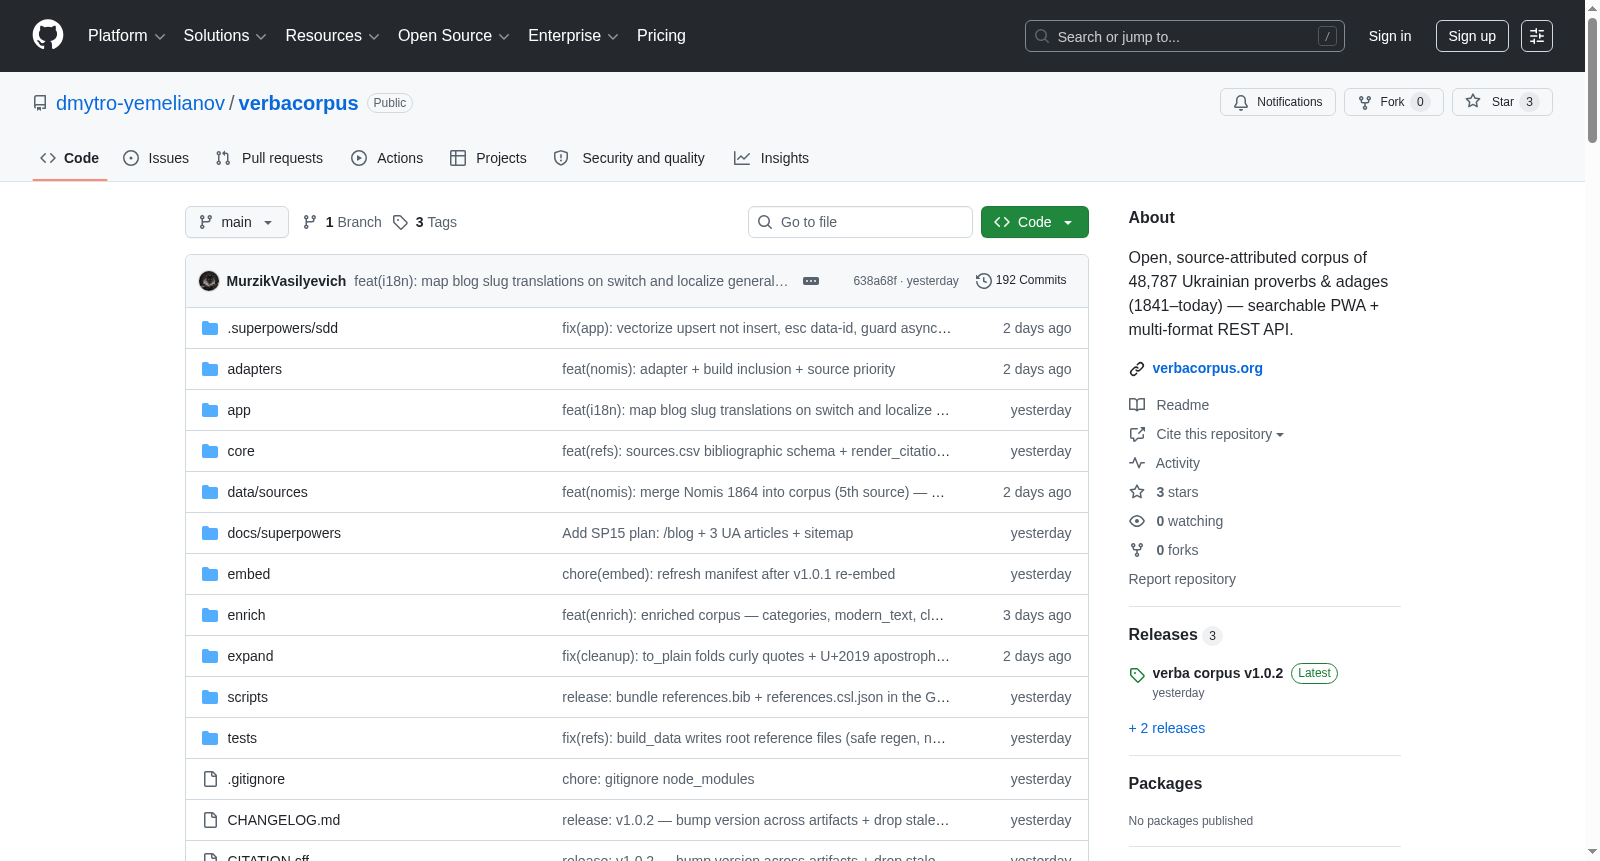
这是一个规范、去重、来源可溯源的乌克兰谚语和格言语料库,统一自数字化历史资源。它经过丰富处理:每条条目包含现代拼写版本和1-3个主题类别。

This is a standardized, deduplicated, source-traceable corpus of Ukrainian proverbs and maxims, compiled from digitized historical resources. It has undergone comprehensive processing: each entry contains a modern orthographic version and 1 to 3 thematic categories.

创建时间:
2026-06-22
原始信息汇总

数据集概述:ukr-proverbs-corpus (verba — 乌克兰语谚语语料库)

该数据集是一个经过规范化、去重、标注来源的乌克兰语谚语和格言语料库,整合自数字化历史文献,并进行了富化处理(每条记录包含现代拼写形式及1-3个主题类别)。

核心数据

  • 总条目数: 48,787 条(100% 已分类)
  • 数据格式: 源文件为 corpus.csv,另有 corpus.jsoncorpus.jsonlcorpus.xml 等格式的导出文件。
  • 版本管理: 使用语义化版本进行数据发布,通过 GitHub Releases 发布,当前版本信息记录在 meta.json 中。
  • 许可证: 编译与富化部分采用 CC BY 4.0 许可;历史源文本属于公共领域;现代合集文本受其出版商权利保护。

数据模式 (corpus.csv)

列名 含义
id 稳定标识符 (pNNNNNN)
text 逐字原文(保留1901年正字法,从不修改)
normalized_text 小写、去除标点后的匹配键
modern_text 现代标准乌克兰语拼写
keyword 词元/术语(来自Franko集)
explanation 学术注释(优先采用Franko集)
category 1-3个主题键,用 ; 分隔
sources 来源引用键,用 ; 分隔
source_refs 每个来源的参考文献,用 ; 分隔
variant_group 关联可能方言变体的ID

数据来源

  • Franko 1901: 伊万·弗兰科《加利西亚-鲁塞尼亚民间谚语》,约30,906条,带注释。
  • Nomis 1864: 马特维·诺米斯《乌克兰谚语、俗语及其他》(1864年,公共领域),9,785条。文本保留原始正字法,modern_text 为现代形式。最佳质量约75-80%,存在OCR字符错误。
  • Bobkova: 博布科娃等编《乌克兰民间谚语与俗语》(现代乌克兰语),5,613条。
  • Ilkevich 1841: 格里戈里·伊尔克维奇《加利西亚谚语与谜语》,2,702条。
  • Mlodzynskyi 2009: 《实用俄乌谚语词典》,2,261条。

主题分类

共27个固定主题(见 enrich/taxonomy.csv):work_labor, poverty_wealth, food_hunger, drink_alcohol, family_kinship, marriage_gender, speech_lying, wisdom_folly, fate_luck, time_seasons, death_illness, religion_god, social_relations, class_power, justice_truth, animals, body_health, home_household, conflict_enmity, friendship_love, travel_distance, trade_money, ethnic_local, emotion_mood, nature_weather, appearance_reputation, idiom_expressive

热门主题: emotion_mood, idiom_expressive, wisdom_folly, work_labor, animals

数据富化

  • 人工标注内容: category(主题分类)、modern_text(现代转写)、explanation(注释)、variant_group(变体分组)均由LLM(Claude Code)生成。
  • 质量审计: 现代转写可接受率约95%,主题标签可接受率约85%(主要标签更可靠)。
  • 变体分组: 基于模糊相似度(rapidfuzz token_set_ratio ≥ 85)的非破坏性链接,共5,064个变体组。

已知限制

  • sources.csv 仅包含引用键、标题、年份、作者,缺少BibTeX所需的完整元数据。
  • 变体分组仅提供链接,不合并记录,且超过8条的组会被解散。
  • 分类为单次最佳努力结果,次要标签或非27个主题内的分类可能不准确。

引用

  • 建议引用格式:Yemelianov, Dmytro (2026). verba — Ukrainian Proverbs Corpus (v1.0.0)。详见 CITATION.cff 文件。

交互界面与API

  • Web应用: 基于Cloudflare Worker的可搜索、离线可用的PWA(渐进式Web应用),地址为 https://verbacorpus.org
  • REST API: 版本化接口 /api/v1,支持 JSONJSONLXMLCSVTSV 格式输出。可通过 ?format= 参数或 Accept 头部协商。
    • GET /api/v1/search (关键词搜索)
    • GET /api/v1/semantic (语义搜索,基于嵌入向量)
    • GET /api/v1/random (随机获取N条)
    • GET /api/v1/query (灵活筛选)
    • GET /api/v1/proverb/:id (单条记录及注释)
    • GET /api/v1/export (批量导出)
    • GET /api/v1/categories, GET /api/v1/meta, GET /api/v1/similar/:id
  • 语义搜索: 由Workers AI的 @cf/baai/bge-m3 嵌入模型和Cloudflare Vectorize索引驱动。为选择性加入功能(仅在线可用)。
搜集汇总
数据集介绍
verba — Ukrainian Proverbs Corpus 数据集图片
构建方式
verba — Ukrainian Proverbs Corpus的构建源自对乌克兰语谚语与格言历史文献的系统性数字化整合。研究团队从五位经典出处中采集原始文本,包括伊万·弗兰科1901年的《加利西亚-鲁塞尼亚民间谚语》、诺米斯1864年的基础性19世纪集大成之作、博布科娃的现代汇编、伊尔克维奇1841年的早期文献以及姆洛津斯基2009年的词典。对于纸质文献,采用Tesseract光学字符识别技术进行数字化提取,并以逐列裁剪的策略优化识别精度。随后,通过批量Claude Code智能体对每条语料进行现代正字法转写、主题范畴标注和异文变体分组,最终生成包含48787条记录、27个固定主题分类的权威语料库,所有数据均以CSV格式存储作为唯一真实来源。
使用方法
使用者可通过多层次接口灵活访问该语料库。本地部署时,运行构建脚本即可从CSV源数据生成JSON、XML等多种导出格式,并通过内置测试套件验证数据完整性。线上途径包括一个基于Cloudflare Workers构建的可离线运行的渐进式Web应用,提供全文搜索、语义查询与随机抽取等功能。RESTful API以版本化方式暴露搜索、语义匹配、随机取样及完整导出等端点,支持JSON、JSONL、XML、CSV和TSV等格式的内容协商,配合内容范围分页机制和OpenAPI 3规范文档,便于集成到各类自然语言处理工作流中。高级用户还可以利用Embedding索引构建命令,在Workers付费计划下按需更新向量检索库。
背景与挑战
背景概述
verba — Ukrainian Proverbs Corpus是一个致力于乌克兰语谚语与格言规范化的综合语料库,由Dmytro Yemelianov于2026年创建。该数据集整合了自19世纪以来的多个历史数字化来源,涵盖Franko 1901、Nomis 1864等重要文献,共计48,787条条目,每条均附加现代正字法转写与1–3个主题分类标签。核心研究问题在于构建一个去重、可溯源且语义增强的谚语资源,以支撑乌克兰语文化遗产的数字化保存与计算语言学研究。该语料库通过GitHub Releases进行版本化发布,并配套提供搜索PWA与REST API接口,对乌克兰语语料库建设、民俗学量化分析及低资源语言的NLP研究产生了积极影响。
当前挑战
该数据集面临的主要挑战在于:1)领域问题层面,乌克兰语谚语作为口语化、地域性极强的文化遗产,拼写变体多样且语义模糊,传统的词汇与规则方法难以实现准确的去重、分类与语义关联,亟需大规模标注语料支撑自动理解与跨源对比;2)构建过程中,语料来自不同年代的印刷品和OCR识别结果(如Nomis 1864的OCR字符错误率约20–25%),数据质量参差不齐,需人工与LLM结合进行现代正字法转写和27类主题标注,但LLM生成的分类标签经抽检约有15%存在争议或错误,且变体分组依赖模糊匹配阈值(rapidfuzz token_set_ratio≥85),大于8条的组会被解散以避免过度关联,映射精确度受限;此外,源文献缺乏标准元数据(如BibTeX信息),阻碍了规范的学术引用生态建设。
常用场景
经典使用场景
在乌克兰语言文化与计算语言学交叉领域中,verba — Ukrainian Proverbs Corpus 被广泛用作多维度语料库资源,支撑基于谚语的语义分析、方言变异研究及主题分类建模。该数据集收录近五万条经过规范去重并标注来源的谚语,每条均附有现代正字法转写与1–3个主题类别标签,为研究者提供了兼顾历史原貌与现代标准的统一语料基础。经典使用场景包括:利用其丰富的类别体系(如情感情绪、智慧愚昧、劳动工作等27个固定主题)开展谚语的情感倾向分析;借助variant_group字段追溯方言变体之间的关联谱系;以及结合normalized_text与modern_text字段完成历时正字法映射与语言演变追踪。
解决学术问题
该数据集有效解决了乌克兰谚语研究长期面临的语料碎片化、来源混杂与标注缺失等学术瓶颈。通过将弗兰科(Franko 1901)、诺米斯(Nomis 1864)等五大历史文本源统一整合并去重,构建了首个规范化、可复用的结构化谚语库,弥补了乌克兰语计算语言学科在民间智慧语料层面的关键空白。同时,LLM自动生成的现代拼写转写与主题分类策略,大幅降低了人工标注成本,为低资源语言的数据增强与模型微调提供了高质量训练材料。该数据集的发布推动了乌克兰民族语言遗产的数字化保护与量化研究进程,成为连接传统语文学与自然语言处理的重要桥梁,其CC BY 4.0许可更促进了跨语言对比与开源社区协作。
实际应用
在实际应用层面,verba — Ukrainian Proverbs Corpus 通过配套的Web应用与REST API接口,实现了从学术研究到公众服务的无缝转化。研究者可直接通过语义搜索接口(基于Cloudflare Vectorize索引与BGE-M3嵌入)执行含义层面的联想检索,或利用多格式导出功能(JSON、CSV、XML等)批量获取指定类别或来源的谚语子集。该数据集已服务于乌克兰语教学辅助工具开发、文化保护数字展览、语言生成模型中的谚语风格注入等场景。其提供的离线PWA应用使得偏远地区用户也能便捷访问庞大的谚语知识库,有效促进了乌克兰民间智慧的日常传播与代际传承。
数据集最近研究
最新研究方向
在计算语言学和数字人文学科的交汇处,verba语料库的构建标志着乌克兰谚语研究迈入了一个新的范式。该语料库整合了从弗兰科1901年经典文本到诺米斯1864年基础性收藏等多源历史资料,通过LLM驱动的现代正字法转写、主题分类与变体聚类,实现了48787条谚语的规范化与语义增强。其前沿性体现在两方面:一是部署了基于Workers AI bge-m3嵌入向量的语义搜索引擎,支持用户按含义而非仅按词汇检索谚语,这为大范围民间口承文化的计算分析提供了技术原型;二是遵循机器学习可复现标准,发布Croissant元数据和版本化GitHub Release,为低资源语言的语料库工程树立了透明化与可引用性的标杆。该数据集不仅填补了东斯拉夫语谚语语料的结构化缺失,更通过开放的REST API与渐进式Web应用,使语言学研究和文化遗产数字化转化为公众可便捷探索的知识基础设施。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

