
遇见数据集

lumasik/captcha-25k

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

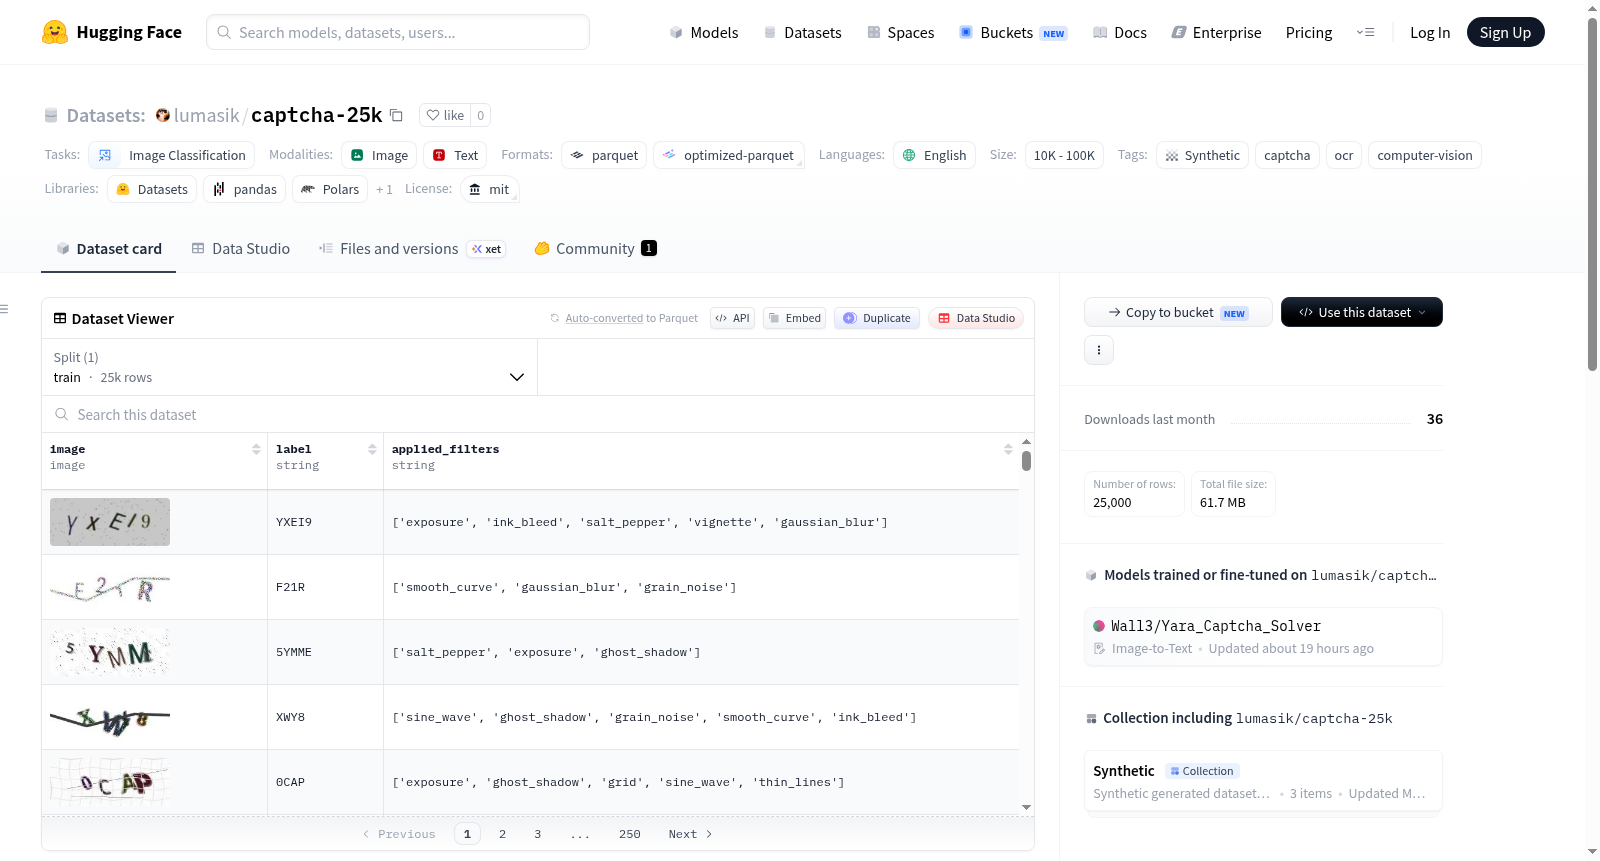
这是一个合成数据集,包含25,000张生成的验证码图像,专为训练和测试OCR(光学字符识别)和计算机视觉模型而设计。数据集通过自定义Python脚本生成,具有合成数据来源。它包含12种以上的噪声过滤器、失真效果和可变字体渲染,以模拟真实世界的验证码挑战。该数据集主要用于OCR基准测试和自动化识别系统的评估,但需要注意的是,作为纯合成数据,它虽然适用于字符识别基准,但未考虑行为反机器人措施(如鼠标移动或浏览器指纹识别)。数据集结构为单个train.parquet文件,包含图像和元数据,共25,000个样本,每个样本都有对应的真实文本标签。数据集大小为61.7 MB,可通过Hugging Face的datasets库流式加载或本地训练使用。

A synthetic dataset consisting of 25,000 generated captcha images, designed for training and testing OCR and computer vision models. The dataset is generated via a custom Python script and includes 12+ types of noise filters, distortions, and variable font rendering to simulate real-world captcha challenges. It is intended for OCR benchmarking and testing automated recognition systems, but as pure synthetic data, it serves as an excellent benchmark for character recognition without accounting for behavioral anti-bot measures (like mouse movement or browser fingerprinting). The dataset is structured as a single train.parquet file with images and metadata, containing 25,000 samples with corresponding ground truth text labels. It has a size of 61.7 MB and is fully compatible with the Hugging Face datasets library for streaming or local training.
提供机构:
lumasik
搜集汇总
数据集介绍
lumasik/captcha-25k 数据集图片
构建方式
该数据集通过自研的Python脚本全流程生成,属于纯粹的综合合成数据。在构建过程中,系统模拟真实网络环境中的验证码图片,融合了超过12种噪声滤波、形变处理及可变字体渲染技术,经过精细的参数调优以呈现多变的干扰特征。每一张图片均携带对应的真实文本标签,共生成25,000个样本,并以统一的Parquet格式存储于单个训练文件中,便于高效加载与处理。
特点
该数据集在设计上具有高度的可重复性与多样性,其集成的多种噪声与形变策略有效提升了OCR模型的鲁棒性。作为图像分类任务的典型基准,它不仅完全兼容Hugging Face Datasets库,还支持流式传输或本地训练,使得研究者在不同计算环境下均能灵活调用。数据集规模适中(约61.7 MB),既避免了过大的存储开销,又提供了充足的样本来开展有效的模型评估。
使用方法
用户可通过Hugging Face的datasets库一行代码即可实现数据加载,快速获取包含图像元数据与标签的训练集。推荐将其作为OCR系统的基准测试集,用于对比不同字符识别算法的表现。需要注意的是,由于数据为纯合成来源,它仅能衡量模型的视觉识别能力,而无法覆盖行为层面的反机器人检测策略。研究者可结合其他真实验证码样本或数据增强技术,以拓展模型的泛化边界。
背景与挑战
背景概述
在计算机视觉与光学字符识别(OCR)领域,验证码(CAPTCHA)作为抵御自动化脚本攻击的关键安全机制,其识别与破解研究始终备受关注。为满足该领域对大规模标准化测试数据的迫切需求,Synthetic-Captcha-25k数据集于近期由研究团队通过自定义Python脚本生成,旨在为OCR模型提供鲁棒性基准测试。该数据集由25,000张合成验证码图像构成,融合了超过12种噪声滤波器、几何畸变及可变字体渲染技术,模拟真实世界中的复杂验证码挑战。其发布为验证码识别算法的性能评估提供了统一标准,推动了字符识别模型在抗干扰能力与泛化性方面的研究进展,在学术界与工业界均具有重要参考价值。
当前挑战
该数据集主要面临以下挑战:首先,在领域问题层面,验证码识别需应对人为设计的强干扰——包括背景噪声、字符扭曲、粘连及重叠等,这使得传统OCR模型难以准确分割并识别单个字符,要求模型具备极强的特征提取与语义理解能力。其次,在构建过程中,数据集完全依赖合成数据生成,虽能模拟多样化噪声模式,却无法涵盖真实验证码中的行为安全机制(如鼠标轨迹追踪、浏览器指纹等),导致模型在纯合成数据上训练后可能无法泛化至实际部署场景。此外,如何平衡噪声强度与人类可读性,避免因过度扭曲导致标注歧义,也是数据生成环节的核心难点。
常用场景
经典使用场景
在计算机视觉与模式识别领域,验证码图像识别始终是评估光学字符识别(OCR)系统鲁棒性的试金石。captcha-25k数据集以其精心合成的25,000张验证码图像,为研究者提供了模拟真实世界验证码挑战的标准化测试平台。该数据集包含12种以上的噪声滤镜、扭曲变形及可变字体渲染,使得研究团队能够在控制变量条件下,系统性地检验OCR算法对背景干扰、字符粘连及几何畸变的抗干扰能力。经典的用法包括将数据集划分为训练集与测试集,以端到端方式训练卷积神经网络或Transformer架构,评估模型在验证码文本转录任务上的字符错误率与序列精度。这一场景不仅服务于学术算法验证,更是工业界预研自动验证码识别系统的基准环节。
解决学术问题
长期以来,学术界在验证码识别研究中面临真实数据获取成本高昂、合规风险显著等瓶颈,而captcha-25k数据集的出现有效化解了这一困境。它解决了制约OCR领域发展的核心问题:如何在缺乏充足、多样且标注精确的真实样本前提下,推动字符识别模型从浅层特征学习向深层语义理解演进。通过提供大规模的合成图像及对应字符级标签,该数据集使研究者能够探索数据增强、域适应和对抗训练等前沿手段对模型泛化能力的改善效果。其意义在于构建了一座从受控实验室环境通往复杂现实场景的桥梁,使得针对扭曲字符、杂色背景和叠加噪声的鲁棒识别研究得以规范化、可重复化,从而为更智能的文字信息抽取技术奠定方法论基础。
衍生相关工作
captcha-25k数据集的发布激发了多项具有启发性的后续研究,包括但不限于基于注意力机制的编码器-解码器结构的优化研究,以及专门针对高噪声验证码的对抗样本生成与防御框架的设计。研究人员以此为基础,探讨了不同噪声类型对CTC解码策略性能的差异化影响,提出了结合注意力热图与剪枝技术的轻量化字符分割方案。此外,该数据集被广泛用作迁移学习中的预训练基石,例如将在其上微调的特征提取器迁移至街景门牌号识别或历史手写文本转录任务中,显著提升了目标领域的小样本学习表现。这些衍生工作不仅验证了高质量合成数据作为学术标杆的有效性,还拓展了验证码识别思路在更广阔视觉理解任务中的适应边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

