
ilsp/Humanibench_Greek
收藏官方服务:
资源简介:
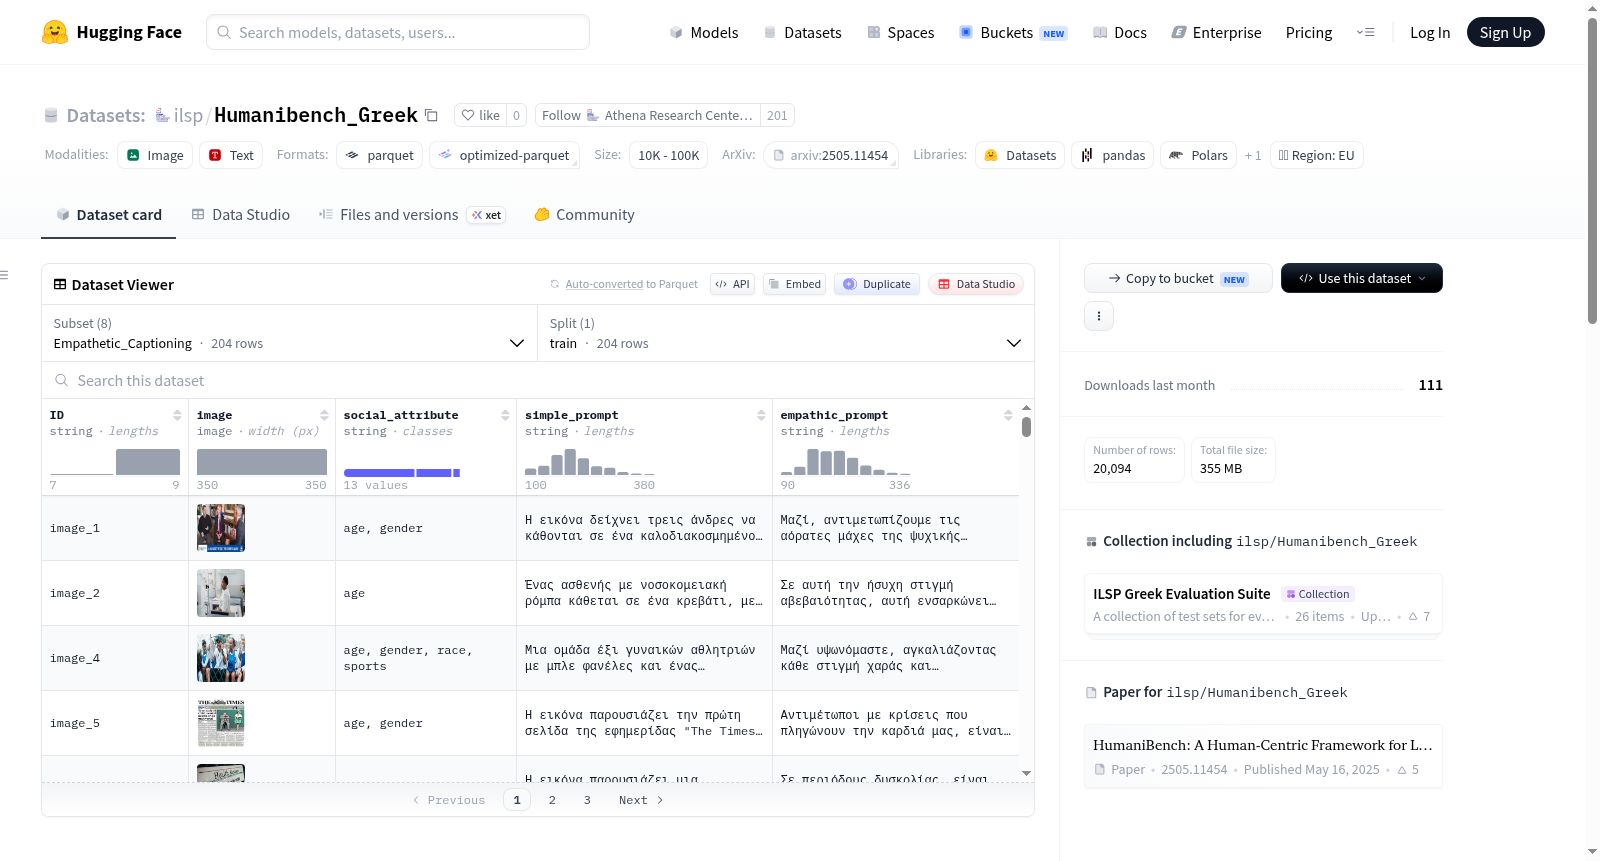
该数据集是HumaniBench的希腊语翻译版本,HumaniBench是一个用于评估大型多模态模型的人类中心基准。此版本的目标是使HumaniBench可作为评估支持希腊语的视觉语言模型的基准。数据集保留了原始HumaniBench数据集的任务结构,文本字段已翻译成希腊语。HumaniBench包含多个多模态评估任务,包括视觉问答、多项选择VQA、多语言QA、视觉定位和共情字幕。
This dataset is a Greek translation of HumaniBench, a human-centered benchmark for evaluating Large Multimodal Models. The goal of this version is to make HumaniBench usable as an evaluation benchmark for Greek-capable Vision-Language Models. The dataset keeps the same task structure as the original HumaniBench dataset. The text fields have been translated into Greek. HumaniBench contains multiple multimodal evaluation tasks, including visual question answering, multiple-choice VQA, multilingual QA, visual grounding and empathetic captioning.
提供机构:
ilsp搜集汇总
数据集介绍
构建方式
Humanibench_Greek数据集是基于原版HumaniBench的希腊语翻译版本构建而成。该数据集严格保留了原始基准测试的任务结构,仅将文本字段翻译为希腊语,涵盖视觉问答、多选题视觉问答、多语言问答、视觉定位以及共情描述等多种多模态评估任务。每个子数据集以独立的配置名称组织,包含图像、属性、问题、答案等字段,其中部分任务还提供了推理过程或边界框信息。数据集的构建旨在使HumaniBench能够作为希腊语视觉-语言模型的评估基准使用。
特点
该数据集的核心特点在于其多维度、多任务的评估能力。它涵盖了从场景理解、实例识别到多语言闭端与开端问答、图像鲁棒性测试等八项子任务,全面评估模型在人类中心场景下的视觉理解与语言生成能力。每个子任务均包含大量精心设计的样本,如Scene_Understanding子任务包含超13000个样本,确保评估的全面性与统计可靠性。此外,数据集支持希腊语文本,填补了该语言在多模态评估领域的空白。
使用方法
用户可通过HuggingFace的datasets库加载该数据集,并依据不同配置名称选择评估子任务。例如,使用'Multilingual_CloseEnded'子集可测试模型在希腊语环境下的封闭式视觉问答能力,而'Visual_Grounding'子集则用于评估模型对图像中特定区域的定位精度。评估时,模型需基于给定的图像和希腊语问题生成答案,并与数据集中提供的标准答案进行比对,从而量化模型在多模态人类中心任务中的表现。
背景与挑战
背景概述
随着多模态大模型在视觉语言任务中取得突破性进展,如何全面评估其在人机交互场景中的能力成为关键研究课题。Humanibench_Greek数据集于2025年由肖娜·拉扎(Shaina Raza)等研究人员创立,源自向量研究所(Vector Institute)提出的HumaniBench基准的希腊语版本。该数据集旨在填补多模态评估体系中非英语语言的空白,聚焦于人类中心视角下的视觉理解、视觉问答、多语言推理与情感化描述等核心研究问题。其构建不仅保留了原始基准的八项子任务结构,更通过高质量的希腊语翻译扩展了多模态评估的语言覆盖范围,为希腊语大语言模型与视觉语言模型的性能评测提供了标准化工具,在推动多模态模型跨语言泛化能力的客观度量方面具有重要影响力。
当前挑战
该数据集面临的核心挑战体现在双重维度:其一,在领域问题层面,它旨在解决当前多模态模型在希腊语环境下缺乏系统评估基准的困境,尤其涉及视觉问答中的推理能力、场景理解的语境适应性以及情感化描述中的社会属性感知等复杂任务。这些任务要求模型同时具备视觉识别、多语言理解和人类意图解读的综合能力,对现有模型的多模态对齐与跨语言知识迁移构成显著考验。其二,在构建过程中,将包含文化特定元素的图像描述、专家标注的情感维度和多模态问答对精准希腊语化是一项艰巨任务。确保翻译不损失原始语义的同时保持人类中心评估的生态效度,特别是处理习语、情感表达与场景关系中的文化负载词,需要严谨的翻译与验证流程,而当前数据集的示例规模尚小,可能限制模型在多任务场景下的泛化评估稳定性。
常用场景
经典使用场景
Humanibench_Greek数据集作为HumaniBench的希腊语译本,旨在评估具备希腊语能力的大规模多模态模型在以人为本的多模态任务中的表现。其核心使用场景涵盖场景理解、实例识别、多选视觉问答、多语言开放与封闭式问答、视觉定位以及共情描述等八项子任务,构成一个全面且结构化的人本评估基准。研究者利用该数据集测试模型在图像理解、跨语言推理、细粒度视觉定位及情感共情描述等多维度上的综合能力,尤其关注模型在希腊语环境下对视觉内容进行高层语义解析与任务适配的稳健性。
衍生相关工作
Humanibench_Greek的推出衍生出多项相关研究工作。一方面,它催生了针对希腊语多模态模型的跨语言迁移学习与微调策略的探索,研究者在此数据集上比较不同多模态架构在翻译后基准上的性能衰减现象。另一方面,该数据集推动了多语种人本评测框架的构建,例如结合HumaniBench原版与希腊语版本进行文化差异下的语义偏差分析。此外,基于该数据集的共情描述与图像容错子任务也激发了面向情感计算与对抗鲁棒性的专项研究,为多模态模型在非英语社区中的人本化部署奠定了评估基础。
数据集最近研究
最新研究方向
面向希腊语多模态大模型的人本评估基准迁移与跨语言鲁棒性研究。随着多模态大模型(LMMs)在希腊语等低资源语言场景中的急速应用,其理解图像、处理复杂问答及保持社会属性感知的能力成为焦点。HumaniBench_Greek通过将HumaniBench中的视觉问答、多选推理、视觉定位与共情描述等任务全盘希腊语化,构建了首个聚焦“人本核心”的跨语言评测框架。该数据集不仅检验模型在场景理解、实例识别与图像鲁棒性上的表现,更通过共情提示与多语言开闭式问答设计,揭示模型在跨文化情感认知与多任务泛化中的脆弱性,为构建更具包容性的智能视觉系统提供了关键验证工具。
以上内容由遇见数据集搜集并总结生成


