
遇见数据集

media-metadata-radiobrowser-stations

收藏
Hugging Face2026-06-26 更新2026-06-29 收录
官方服务:

资源简介:

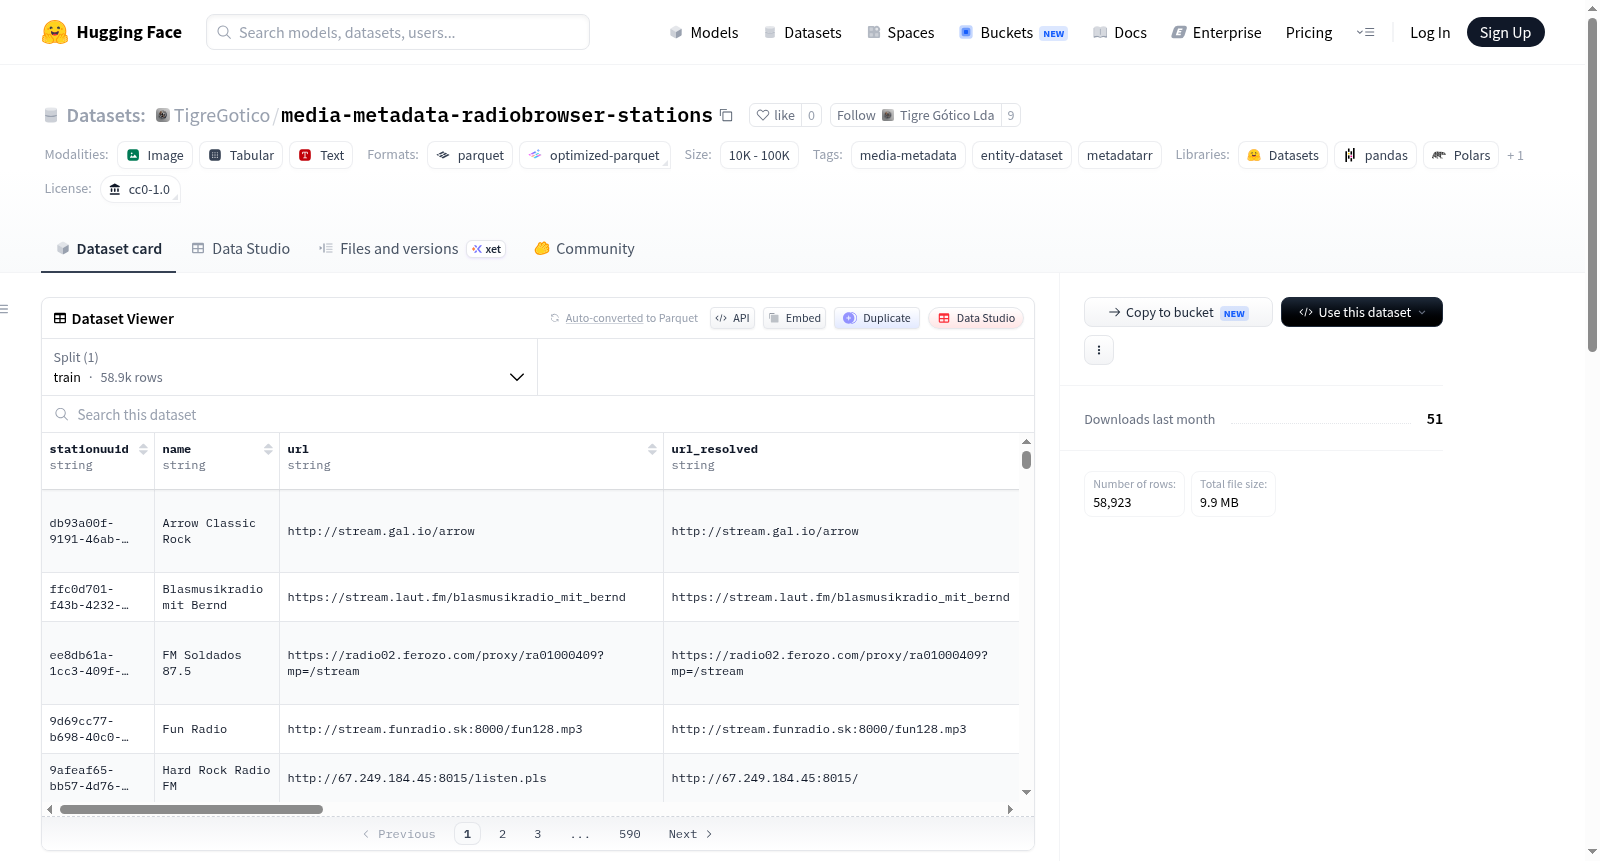
Radio Browser Stations 数据集是一个包含约 59,000 个全球互联网广播电台元数据的结构化集合。数据源自 Radio Browser,这是一个由社区维护、采用 CC0 许可的全球互联网广播电台开放目录,也是目前最大的开放广播数据库之一。数据集提供了每个电台的详细元信息,包括:稳定的唯一标识符 (stationuuid)、电台名称 (name)、流媒体播放地址 (url, url_resolved)、官方网站 (homepage)、图标链接 (favicon)、地理位置信息(国家 country、国家代码 countrycode、州/省 state)、广播语言 (language, language_codes)、音乐类型与风格标签 (tags)、音频技术参数(编码格式 codec、比特率 bitrate)以及社区互动数据(投票数 votes、总点击量 clickcount、近期点击趋势 clicktrend)。该数据集适用于多种任务,如广播电台发现与推荐、基于地理位置或音乐类型的电台分类与过滤、音频流媒体技术分析以及构建音乐信息检索系统。

The Radio Browser Stations dataset is a structured collection containing metadata for approximately 59,000 global internet radio stations. The data originates from Radio Browser, a community-maintained, CC0-licensed open directory of global internet radio stations and one of the largest open broadcast databases currently available. The dataset provides detailed metadata for each station, including: a stable unique identifier (stationuuid), station name (name), streaming URLs (url, url_resolved), official website (homepage), favicon link (favicon), geographic information (country, countrycode, state), broadcast language (language, language_codes), music genre and style tags (tags), audio technical parameters (codec format codec, bitrate bitrate), and community interaction data (votes votes, total click count clickcount, recent click trend clicktrend). This dataset is suitable for various tasks, such as radio station discovery and recommendation, classification and filtering based on geography or music genre, audio streaming technical analysis, and building music information retrieval systems.
创建时间:
2026-06-24
搜集汇总
数据集介绍
media-metadata-radiobrowser-stations 数据集图片
构建方式
该数据集由metadatarr工具链中的radiobrowser_stations爬虫模块从RadioBrowser平台采集而来,最终汇聚成包含58,923条条目的丰富实体数据集。每个条目代表一个广播电台,并包含如stationuuid、name、url、url_resolved、homepage、favicon、country、countrycode、state、language、language_codes、tags、codec、bitrate、hls、votes、clickcount、clicktrend、last_check_ok及entity_type等字段。整个数据采集与清洗流程由开源项目metadatarr驱动,其源代码托管于GitHub,确保了构建过程的透明性与可复现性,为后续研究与分析奠定了坚实的数据基础。
特点
本数据集的核心特色在于其广播电台实体的全面性与明细度。它不仅涵盖电台的基本标识与网络链接,还深度收录了地理归属、语言编码、音频编码格式与码率等技术参数,以及用户互动数据(如投票、点击次数与趋势)。尤为突出的是entity_type字段,为数据使用者提供了灵活的实体分类视角,便于针对特定类别进行定制化分析。整体上,该数据集既是广播领域数字档案的宝贵资源,也是媒体元数据挖掘与推荐系统研究的高质量素材。
使用方法
研究者与开发者可直接通过Hugging Face Datasets库加载本数据集,使用'load_dataset()'函数即能快速获取完整的CSV格式数据。数据以标准表格结构呈现,便于利用Pandas等工具进行筛选、聚合与可视化分析。其丰富的字段设计支持多维度查询,例如按国家、语言、编码类型或用户活跃度进行子集抽取,适用于广播电台推荐、地区媒体生态分析或音频流服务比对等场景。此外,由于数据集采用CC0-1.0许可证,使用者无需顾虑版权限制,可自由用于学术研究或商业应用。
背景与挑战
背景概述
随着互联网音频内容的爆炸式增长,广播电台作为传统媒介的数字化延伸,亟需结构化元数据以支撑检索、推荐与内容分发等下游任务。media-metadata-radiobrowser-stations数据集由TigreGotico团队利用metadatarr爬虫框架于近期构建,旨在整合全球广播电台的实体信息,涵盖站台标识、网络资源、地理分布、语言编码及用户行为等二十个核心字段。该数据集填补了公开可用的广播电台元数据资源空白,为媒体元数据标准化、跨语言广播分析及用户偏好建模等领域提供了高质量基础数据源。
当前挑战
领域层面,广播电台元数据面临来源碎片化、标准不统一、更新滞后等固有问题,且不同国家与地区的语言编码、标签体系差异显著,增加了数据整合与跨域分析的复杂度。构建过程中,爬虫需应对动态网络资源解析、站点健康状态验证及大量重复条目去重等工程挑战,同时需确保海量非结构化数据向结构化字段的准确映射。此外,用户行为指标(如投票数与点击量)的时效性与可靠性亦构成数据质量保障的关键瓶颈。
常用场景
经典使用场景
media-metadata-radiobrowser-stations数据集汇聚了全球近六万个广播电台的元数据信息,涵盖了台名、URL、国家、语言、编码格式、码率等关键属性。在媒体信息检索与推荐系统的研究领域,该数据集常被用作构建广播电台知识图谱的基础素材,支持基于内容的过滤、语言偏好分析以及地域性媒体分发策略的建模。研究者能够利用其丰富的结构化字段,开展电台标签聚类、多语种服务识别以及音频流质量评估等经典任务,从而为个性化广播服务与全球媒体索引系统提供坚实的数据支撑。
实际应用
在实际产业应用中,该数据集为流媒体聚合平台、智能音箱服务及车载娱乐系统提供了关键的冷启动数据源。开发者可基于其完整的电台URL与码率信息,快速构建起全球广播频道索引,实现跨区域的电台搜索与一键播放功能。此外,通过分析其中的点击趋势与投票数据,广告投放系统能够精准识别高活跃度电台,优化音频广告的定向策略;而在网络质量监测领域,该数据集还可用于检测不同地区广播流媒体的可用性与响应延迟,支撑内容分发网络的性能调优与故障诊断。
衍生相关工作
围绕该数据集,学术界与工业界衍生了一系列经典工作。其中,基于语言编码与标签字段的多标签分类模型被广泛用于自动识别电台的播出语言与内容主题,推动了非结构化媒体标签的语义化进程。此外,有研究利用各地电台的编码格式与码率分布,构建了广播基础设施的地域差异化分析框架,并衍生出数字鸿沟评估的实证工具。在元数据质量提升方面,该数据集促成了实体对齐与去重算法的开源基准,为类似规模的多源媒体数据融合任务提供了可复用的评估范例与实验基线。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

