遇见数据集

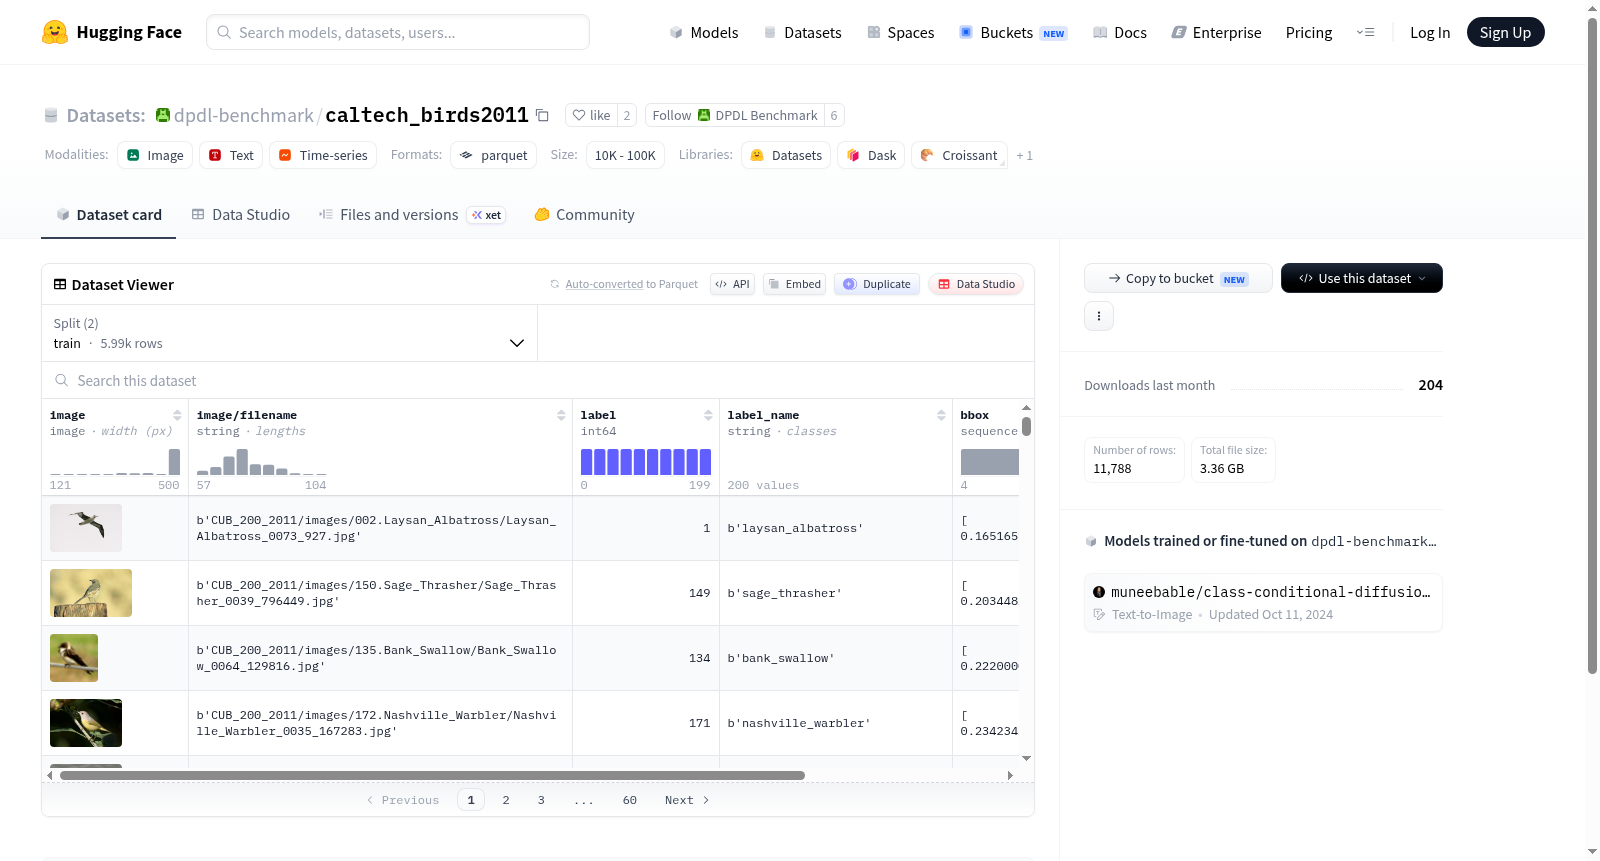
dpdl-benchmark/caltech_birds2011

收藏
Hugging Face2024-05-08 更新2024-06-12 收录
官方服务:

资源简介:

--- dataset_info: features: - name: image dtype: image - name: image/filename dtype: string - name: label dtype: int64 - name: label_name dtype: string - name: bbox sequence: float32 - name: segmentation_mask dtype: image splits: - name: train num_bytes: 1713011861.5 num_examples: 5994 - name: test num_bytes: 1644699321.5 num_examples: 5794 download_size: 3357935260 dataset_size: 3357711183.0 configs: - config_name: default data_files: - split: train path: data/train-* - split: test path: data/test-* ---

数据集信息: 特征: - 字段名: 图像 数据类型: 图像 - 字段名: 图像/文件名 数据类型: 字符串 - 字段名: 标签 数据类型: 64位整数 - 字段名: 标签名称 数据类型: 字符串 - 字段名: 边界框(bbox) 数据类型: 单精度浮点数序列 - 字段名: 分割掩码 数据类型: 图像 数据集划分: - 划分名称: 训练集 占用字节数: 1713011861.5 样本数量: 5994 - 划分名称: 测试集 占用字节数: 1644699321.5 样本数量: 5794 下载总大小: 3357935260 数据集总存储大小: 3357711183.0 配置项: - 配置名称: 默认配置 数据文件: - 划分: 训练集 路径: data/train-* - 划分: 测试集 路径: data/test-*

提供机构:
dpdl-benchmark
原始信息汇总

数据集概述

数据集特征

  • image: 图像数据,数据类型为 image。
  • image/filename: 图像文件名,数据类型为 string。
  • label: 标签,数据类型为 int64。
  • label_name: 标签名称,数据类型为 string。
  • bbox: 边界框,数据类型为 sequence of float32。
  • segmentation_mask: 分割掩码,数据类型为 image。

数据集分割

  • 训练集: 包含5994个样本,总大小为1713011861.5字节。
  • 测试集: 包含5794个样本,总大小为1644699321.5字节。

数据集大小

  • 下载大小: 3357935260字节。
  • 数据集总大小: 3357711183.0字节。

数据文件配置

  • 默认配置:
    • 训练数据路径: data/train-*
    • 测试数据路径: data/test-*
搜集汇总
数据集介绍
dpdl-benchmark/caltech_birds2011 数据集图片
构建方式
Caltech-UCSD Birds-200-2011数据集是细粒度图像分类领域的经典基准,其构建旨在推动鸟类物种的自动识别研究。该数据集包含11,788张图像,涵盖200种鸟类物种,每种物种约60张样本。数据被划分为训练集(5,994张)与测试集(5,794张),确保模型评估的公平性。每张图像不仅提供类别标签(label)和物种名称(label_name),还附有边界框(bbox)用于目标定位,以及分割掩码(segmentation_mask)以实现像素级语义解析。这种多维标注体系,使得数据既支持分类任务,也能服务于目标检测与语义分割研究。
特点
该数据集的核心特点在于其细粒度与丰富标注的有机结合。200个鸟类物种类别间差异细微,对模型区分相似外观的能力提出严苛挑战,因此成为验证细粒度识别算法性能的试金石。边界框与分割掩码的同步提供,使得研究人员能在同一数据上探索多任务学习框架。此外,图像文件名(image/filename)的保留便于溯源,而图像字段(image)直接存储视觉内容,简化了数据加载流程。数据集规模适中,既避免小样本过拟合风险,又降低大规模训练的计算门槛。
使用方法
使用该数据集时,可通过HuggingFace Datasets库加载,指定配置名为'default',并利用'split'参数选择训练集或测试集。加载后,每条样本包含图像、边界框(float32序列)、分割掩码(图像格式)及标签。图像与掩码可直接用于深度学习模型的输入管道,边界框可转换为标准格式(如[x, y, width, height])用于目标检测。推荐将标签字段(label)映射为分类任务的整数索引,并利用label_name进行结果可视化。对于分割任务,需将segmentation_mask解码为模型所需的张量形状。数据集已预分好训练与测试集,无需额外划分。
背景与挑战
背景概述
在计算机视觉领域,细粒度图像分类任务长期致力于区分同一基础类别下的不同子类别,例如不同鸟类物种的识别。Caltech-UCSD Birds-200-2011(CUB-200-2011)数据集由加州理工学院和加州大学圣迭戈分校的研究人员于2011年创建,旨在推动细粒度视觉识别的研究进展。该数据集包含200种鸟类,共计11,788张图像,每张图像均提供了边界框、部位关键点以及语义分割掩码等丰富标注。其核心研究问题在于如何捕捉类间微小差异,以提升模型对相似物种的区分能力。作为细粒度分类领域的标杆数据集,CUB-200-2011极大地促进了注意力机制、部件检测以及度量学习等技术的发展,对生态监测、生物多样性保护等应用具有深远影响。
当前挑战
该数据集所解决的领域问题在于细粒度图像分类中类间差异极小、类内变化极大的挑战,例如不同鸟类在羽毛纹理、形态结构上的细微差别常导致分类混淆。构建过程中面临多重困难:首先,数据采集需涵盖广泛的地理分布与季节变化,确保物种多样性;其次,人工标注边界框、部位关键点及分割掩码耗时且需专业知识,易引入标注误差;再者,图像质量参差不齐,包含光照、遮挡及背景干扰等因素,增加了模型泛化难度。此外,数据集规模相对较小,对深度学习方法的鲁棒性提出了更高要求,需借助迁移学习或数据增强策略来缓解过拟合风险。
常用场景
经典使用场景
Caltech-UCSD Birds-200-2011数据集,作为细粒度图像分类领域的标杆性基准,长期以来被广泛用于鸟类物种的精准识别任务。其包含200种鸟类、近12000张图像,并提供了边界框、分割掩码等精细标注,使得研究者能够深入探索类别间细微差异的辨识方法。该数据集最经典的应用场景在于训练和评估深度学习模型在高度相似物种间的区分能力,例如区分不同种类的啄木鸟或鸣禽,从而推动细粒度视觉识别技术的进步。
实际应用
在实际应用中,基于Caltech Birds 2011训练的模型可部署于生态保护与鸟类观测领域。例如,通过无人机或野外摄像头实时捕获图像,自动识别珍稀或迁徙鸟类,辅助生态学家进行种群数量统计与栖息地分析。此外,该技术还可延伸至农业害虫识别、工业产品缺陷检测等场景,其核心在于将细粒度分类能力转化为对细微差异的自动化判断,从而提升各行业监测与管理的智能化水平。
衍生相关工作
围绕该数据集,学术界衍生出一系列经典工作。其中最具代表性的包括双线性卷积神经网络(Bilinear CNNs),通过双流结构建模局部特征交互;以及基于部件检测的细粒度方法(如Part-based R-CNN),利用边界框监督学习部位对齐表示。此外,注意力机制模型如Triplet Attention和Transformer架构的引入,进一步推动了无监督或弱监督细粒度分类的发展,这些工作均以Caltech Birds 2011为核心验证平台,持续引领细粒度视觉研究的演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务