Indian Law 100: Legal AI Micro-Case Benchmark
收藏资源简介:
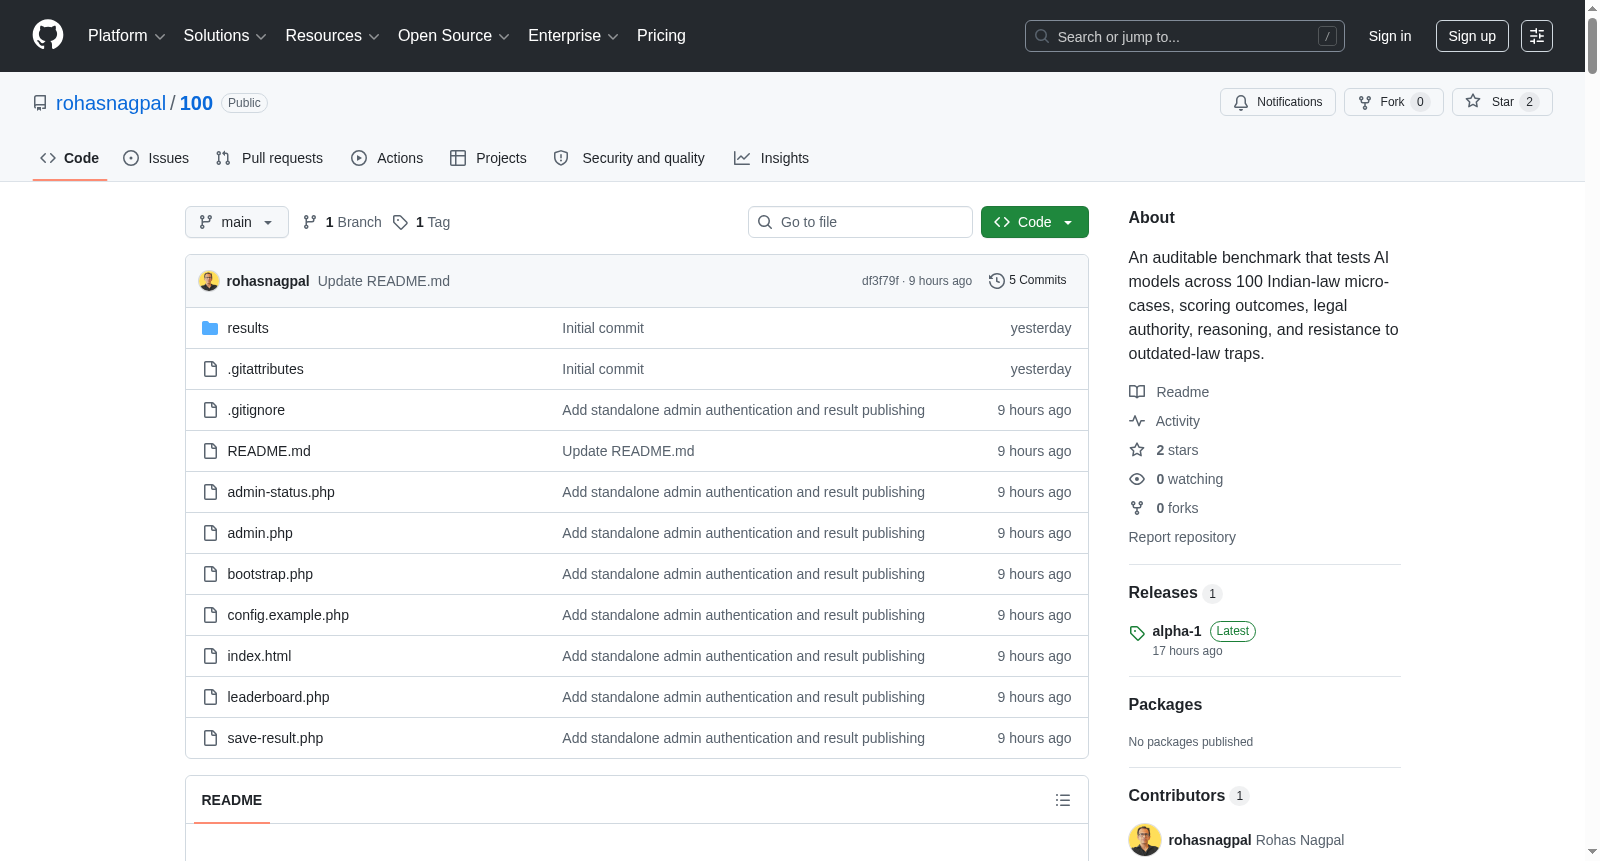
Indian Law 100是一个基于浏览器的基准测试,用于衡量AI模型将印度法律应用于具体事实的准确性。它包含100个独立的微案例,涵盖13个法律领域、3个难度等级,并故意设置了过时或废止法律的陷阱。每个案例都根据法律结果、管辖权威和应用质量进行评估。
Indian Law 100 is a browser-based benchmark developed to assess the accuracy of AI models when applying Indian legal frameworks to specific factual scenarios. It includes 100 self-contained micro-cases spanning 13 legal domains and 3 difficulty tiers, with intentional traps leveraging outdated or repealed Indian legal provisions. Each model-generated answer is evaluated against three core metrics: legal outcome, jurisdictional authority, and the quality of legal application. Benchmark results can be manually reviewed and overridden, exported in auditable JSON format, and published to a comparative leaderboard.
Indian Law 100: Legal AI Micro-Case Benchmark
数据集概述
Indian Law 100 是一个基于浏览器的基准测试,用于评估AI模型在具体事实场景中应用印度法律的准确度。该数据集包含100个自包含的微案例,涵盖13个法律领域、3个难度等级,并设置了针对过时或已废止法律的陷阱案例。
数据集构成
法律领域分布
| 领域 | 案例数 |
|---|---|
| 刑法 – BNS | 15 |
| 刑事诉讼法 – BNSS | 8 |
| 证据法 – BSA | 7 |
| 合同法 | 10 |
| 宪法 | 10 |
| 消费者保护 | 8 |
| IT法与网络犯罪 | 8 |
| 财产与租赁 | 7 |
| 家庭法 | 7 |
| 劳动与就业 | 6 |
| 公司法 | 5 |
| 税收与GST | 5 |
| PMLA、加密货币与FEMA | 4 |
| 总计 | 100 |
难度分布
- 40个简单案例
- 40个中等案例
- 20个困难案例
- 13个明确标记为陷阱的案例
陷阱类型涵盖IPC到BNS、CrPC到BNSS的映射问题、已废止条款、过时判例、时效问题、修正案陷阱等,用于测试模型是否应用了现行法律。
评分机制
每个案例满分100分,评分维度如下:
| 评分维度 | 分值 | 评估内容 |
|---|---|---|
| 正确结果 | 50 | 模型是否得出法律上正确的结果 |
| 正确法律依据 | 30 | 是否引用了正确的条款、法规或具有约束力的权威依据 |
| 推理与陷阱规避 | 20 | 是否合理应用规则并规避已知陷阱 |
总分上限为 10,000分。结果判定等级:
- 正确: 70–100分
- 部分正确: 40–69分
- 不正确: 0–39分
运行流程
- 用户输入OpenRouter API密钥
- 加载实时OpenRouter目录并按模型提供商分组
- 用户选择一个模型,并可选择独立的裁判模型
- 案例按顺序独立发送
- 测试模型的答案实时流式输出到结果表中
- 根据提供的标准答案和运行时生成的评分标准进行评分
- 分数和解释显示在答案旁边
- 用户可覆盖任意三个评分维度或使用正确、部分正确、不正确的预设
- 所有100个案例评分完成后,用户可最终确定运行并下载JSON文件
- 管理员登录后可保存运行结果至服务器排行榜
模型设置
| 设置项 | 用途 |
|---|---|
| 温度 | 控制随机性;较低值产生更可重复的答案 |
| Top P | 限制采样范围 |
| 最大输出令牌数 | 限制每个答案长度,推荐默认值400 |
| 推理努力 | 从兼容模型和提供商请求推理级别 |
| 种子 | 在支持的模型中提高可重复性 |
| 独立裁判模型 | 使用独立模型评分;留空则测试模型自我评分 |
推荐公共比较设置:温度0、Top P 1、400输出令牌数、模型默认推理、无种子。
裁判可靠性与降级处理
裁判请求使用严格的四字段JSON模式:
json { "outcome_score": 0, "legal_basis_score": 0, "reasoning_score": 0, "reason": "简短的评分说明" }
系统处理常见的模型偏差(如被Markdown代码块包裹的JSON、被解释性文字包围的JSON等)。若第一次裁判响应不可读,进行一次修复尝试;若仍失败,标记为"裁判失败",用户可人工覆盖评分。
恢复机制与IndexedDB
活动运行存储在浏览器的IndexedDB数据库中:
- 数据库:
indian-law-100-benchmark - 对象存储:
active-runs - 活动记录键:
active
系统在以下情况保存检查点:流式输出期间约每750毫秒、答案生成前后、评分前后、人工覆盖后、页面隐藏或卸载时、运行结束时。刷新后UI自动恢复模型、裁判、生成设置、答案、评分、错误、使用量、成本和进度。
项目结构
micro-case-benchmark-india/ ├── .gitignore ├── README.md ├── admin.php 管理员登录/登出 ├── admin-status.php 登录状态与CSRF令牌端点 ├── bootstrap.php 共享配置、会话、认证、CSRF辅助 ├── config.example.php 配置模板 ├── index.html 自包含的基准测试运行器与100个案例数据集 ├── leaderboard.php 结果扫描、排名、图表、运行存档 ├── save-result.php 认证验证与JSON保存端点 └── results/ └── .gitkeep 最终运行结果JSON文件存储目录
无构建步骤,无JavaScript包依赖。
案例记录格式
json { "id": "CRIM-BNS-001", "domain": "criminal_bns", "difficulty": "easy", "is_trap": true, "trap_type": "ipc_bns_mapping", "fact_pattern": "自包含的事实描述...", "question": "一个精确的法律问题...", "gold": { "outcome": "可验证的法律结果...", "legal_basis": ["控制性条款或判决"], "reasoning_notes": "必需的应用和陷阱规避说明...", "common_wrong_answers": ["已知错误答案"] } }
已知限制
- 法律准确性最终取决于所提供的标准答案和审核过程
- LLM评分可能存在不一致性;建议使用固定裁判模型和人工审核
- OpenRouter定价和模型可用性可能发生变化
- 成本数字基于模型目录返回的定价估算
- 浏览器存储具有源特异性,可能被隐私浏览或站点数据清理移除
- 100个案例的运行至少需要每个案例一次测试模型请求和一次裁判请求;重试会增加时间和成本
- 动态路由器可能使用不同的底层模型,降低可重复性
- 种子仅在支持的情况下提高可重复性,并不保证确定性
- 当前运行器一次仅评估一个模型
负责任的用途说明
本基准测试是研究和评估工具,不构成法律建议、专业审查的替代品,或证明模型适合无监督法律实践的证据。评分应结合数据集版本、裁判模型、生成设置、失败日志、人工覆盖及100个案例的范围进行解读。